Claude Code 六层记忆体系
结构说明:本文采用 总 — 分 — 总 三层组织。 第一层(总):整体认知,先建立全局地图。 第二层(分):逐层拆解 ⑥ 个记忆层 + 1 个横向缓存体系。 第三层(总):收束关系,给出最终结论。
配图 4 张(矢量 SVG + PNG,位于
82.ClaudeCode六层记忆体系-图/): 图 1 六层记忆体系总览(见「2. 整体架构」)、图 3 指令记忆遍历收集与反转加载(见「1.2 加载策略」)、 图 2 摘要记忆压缩过程(见「第 5 层」开头)、图 4 缓存体系与 Prompt Cache(见「横向篇」开头)。
第一层 · 总:整体认知
1. 核心思想
Agent 的记忆不是简单地“保存聊天记录”,而是按照不同的生命周期、作用域和用途进行分层管理,在有限 Token / Context Window 下实现:
- 规则约束
- 上下文保持
- 任务连续
- 长期沉淀
- 上下文压缩
- 记忆治理
一句话概括:
不同的记忆解决不同的问题,用不同的生命周期管理,最终在有限的 Context 里维持长期运行的连续性。
2. 整体架构
Claude Code Memory
│
├── ① 指令记忆|规则级
│   └── CLAUDE.md
│
├── ② 短期会话记忆|Session 级
│   └── Recent Context
│
├── ③ 工作任务记忆|Task 级
│   └── Task State
│
├── ④ 长期记忆|Persistent 级
│   └── memdir / MEMORY.md / Topic Memory
│
├── ⑤ 摘要记忆|Compression 级
│   └── session-memory.md
│
└── ⑥ AutoDream|离线级
    └── 记忆整理 / 重塑 / 索引
横向还有一层缓存体系(性能层),它不属于六层记忆,但和记忆体系协同工作。
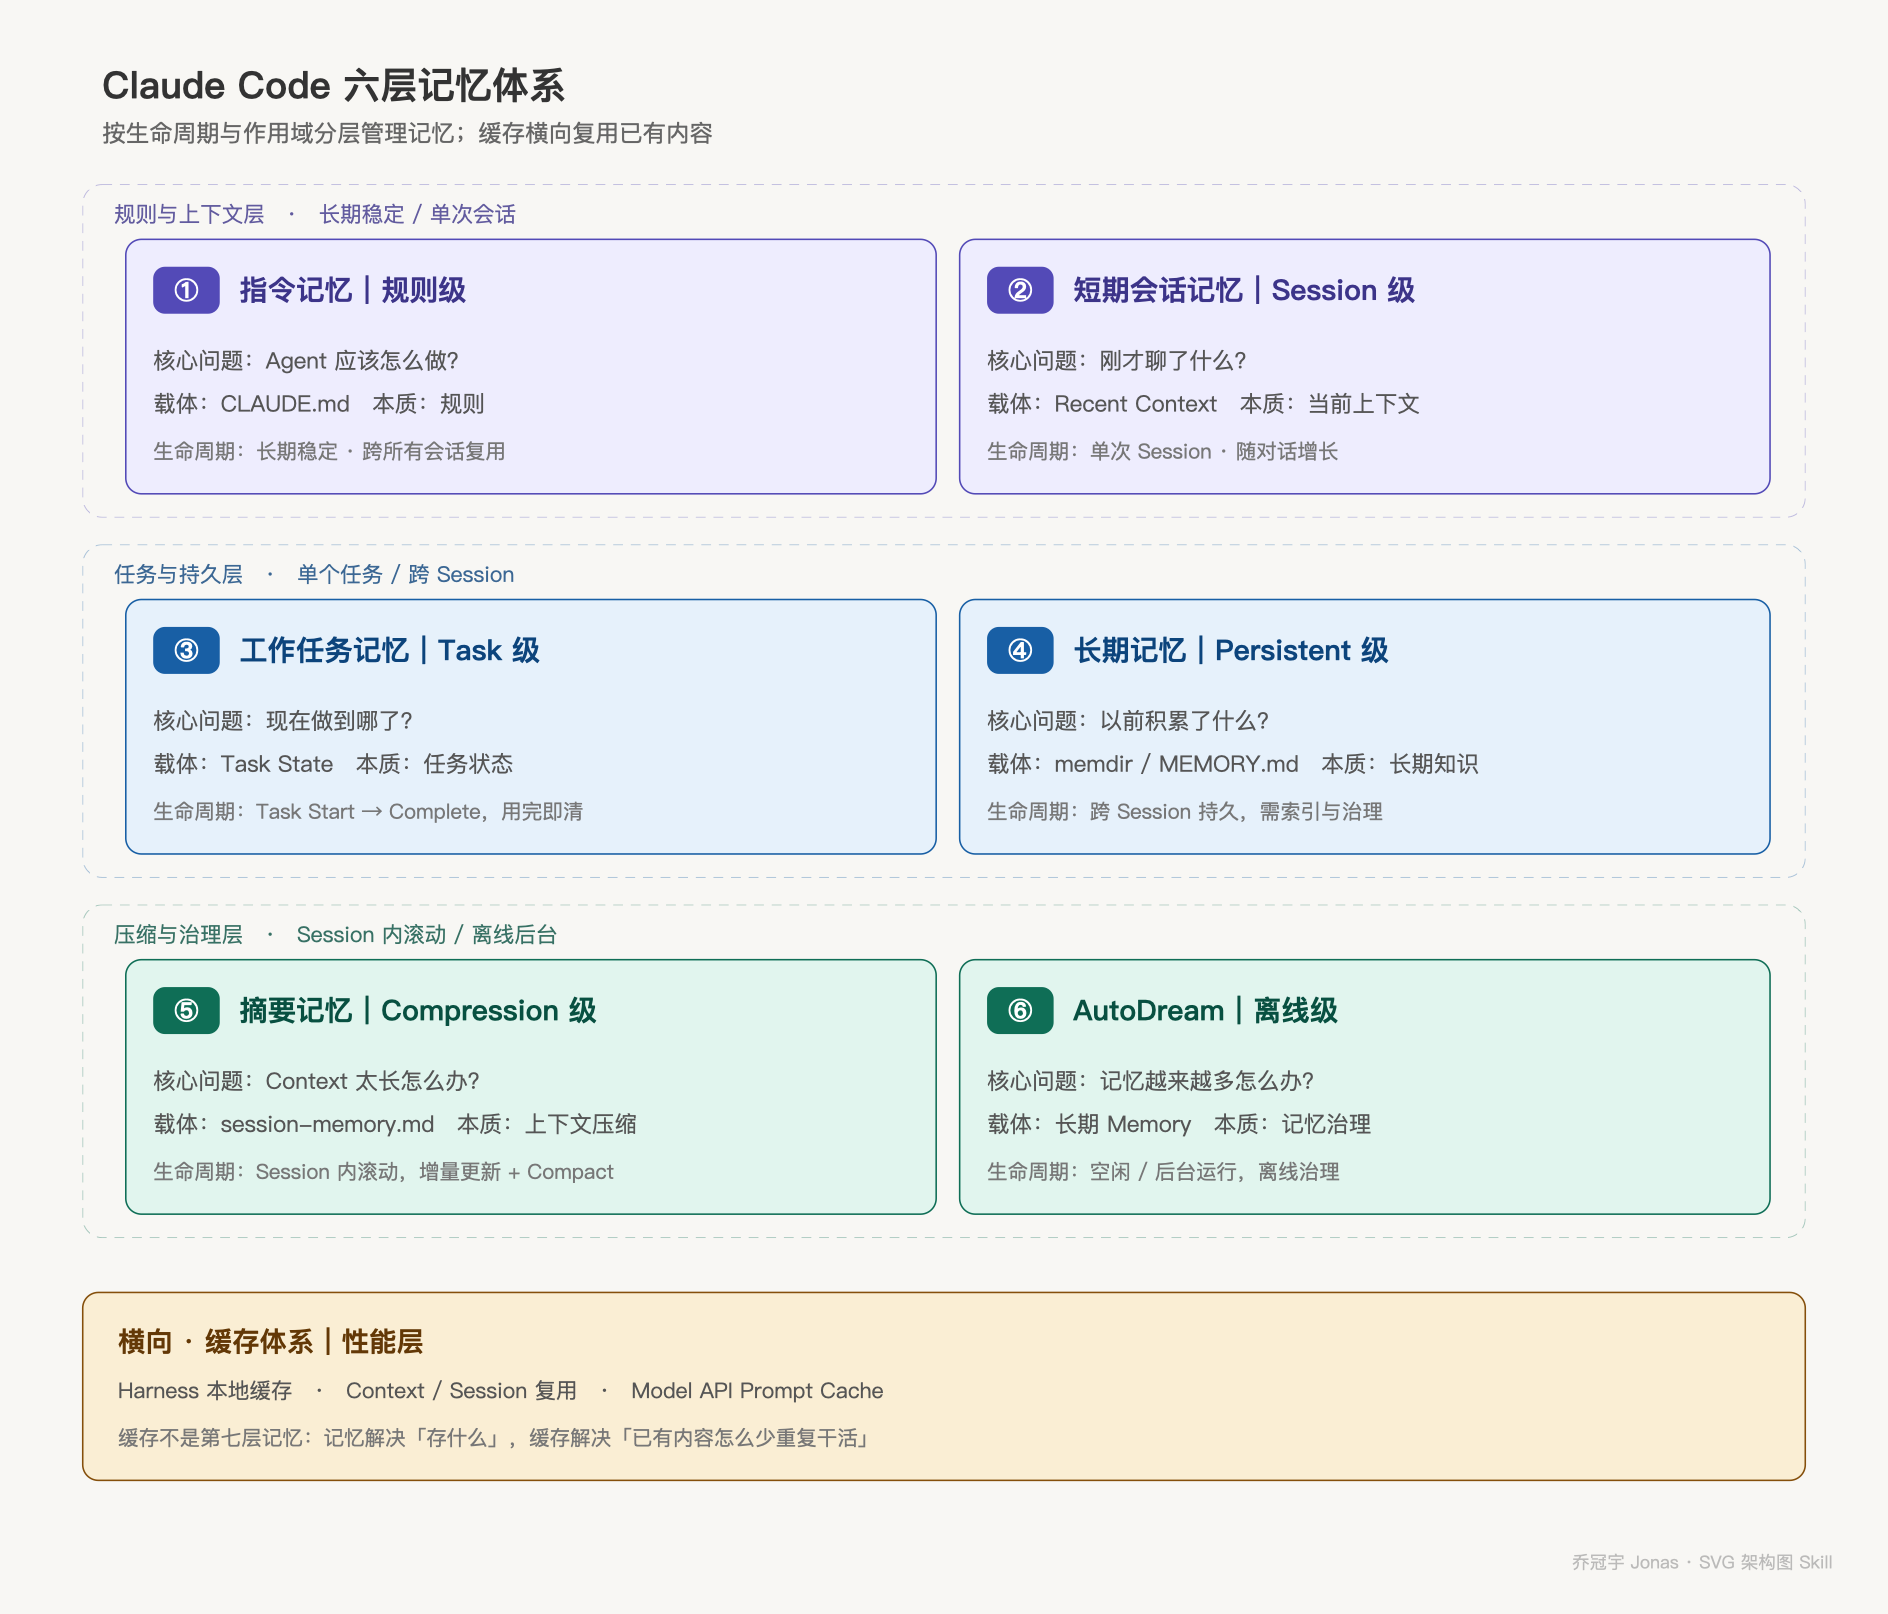
图 1 六层记忆体系总览 —— ① 指令记忆 / ② 短期会话记忆 / ③ 工作任务记忆 / ④ 长期记忆 / ⑤ 摘要记忆 / ⑥ AutoDream,底部横带为不属于六层的缓存体系。
3. 六层分别解决什么问题?
| 层级 | 核心问题 | 本质 | 生命周期 |
|---|---|---|---|
| ① 指令记忆 | Agent 应该怎么做? | 规则 | 长期稳定 |
| ② 短期会话记忆 | 刚才聊了什么? | 当前上下文 | 单次 Session |
| ③ 工作任务记忆 | 现在做到哪了? | 任务状态 | 单个 Task |
| ④ 长期记忆 | 以前积累了什么? | 长期知识 / 经验 | 跨 Session 持久 |
| ⑤ 摘要记忆 | Context 太长怎么办? | 上下文压缩 | Session 内滚动 |
| ⑥ AutoDream | 记忆越来越多怎么办? | 记忆治理 | 离线后台 |
4. 一条主线:记忆 vs 缓存
记忆体系
→ 记什么、怎么保存、怎么压缩、怎么治理

缓存体系
→ 已有内容怎么更高效地复用
两者要严格区分:
Harness / Claude Code 的上下文组织
                ≠
Anthropic Model API 的 Prompt Cache
记忆是“存什么”,缓存是“怎么少重复干活”。
5. 全文地图(阅读指引)
| 第二层章节 | 对应层面 | 核心诉求 |
|---|---|---|
| 第 1 层 | ① 指令记忆 | 应该怎么做 |
| 第 2 层 | ② 短期会话记忆 | 刚才聊了什么 |
| 第 3 层 | ③ 工作任务记忆 | 现在做到哪 |
| 第 4 层 | ④ 长期记忆 | 以前记住什么 |
| 第 5 层 | ⑤ 摘要记忆 | 太长了怎么压 |
| 第 6 层 | ⑥ AutoDream | 乱了怎么整理 |
| 横向篇 | 缓存体系 | 已有内容怎么复用 |
第二层 · 分:六层记忆 + 缓存逐层详解
第 1 层 | ① 指令记忆|规则级
解决:Agent 应该怎么做。
核心载体是 CLAUDE.md 文件体系。
1.1 四层体系
Managed
   ↓
User
   ↓
Project
   ↓
Local
| 层级 | 作用 |
|---|---|
| Managed | 组织 / 公司级统一策略 |
| User | 用户个人全局偏好 |
| Project | 项目 / 团队共享规范 |
| Local | 当前项目的本地私有规则 |
核心思想:
全局提供基础约束,局部提供项目灵活性。
例如:
Managed
└── 公司安全规范

User
└── 我的编码习惯

Project
└── 项目技术栈、架构规范

Local
└── 本机特殊配置
1.2 加载策略
不是只读取当前目录的 CLAUDE.md。
可以理解为:
CWD
 ↓
parent
 ↓
grandparent
 ↓
...
 ↓
root
第一步:遍历收集
CWD → parent → ... → root
收集沿途存在的指令文件。
第二步:反转加载
root → ... → parent → CWD
即:
先向上遍历收集,再从全局到局部反向加载。
最终形成:
全局基础规则
      ↓
用户规则
      ↓
项目规则
      ↓
当前目录规则
越具体的作用域拥有越强的针对性。
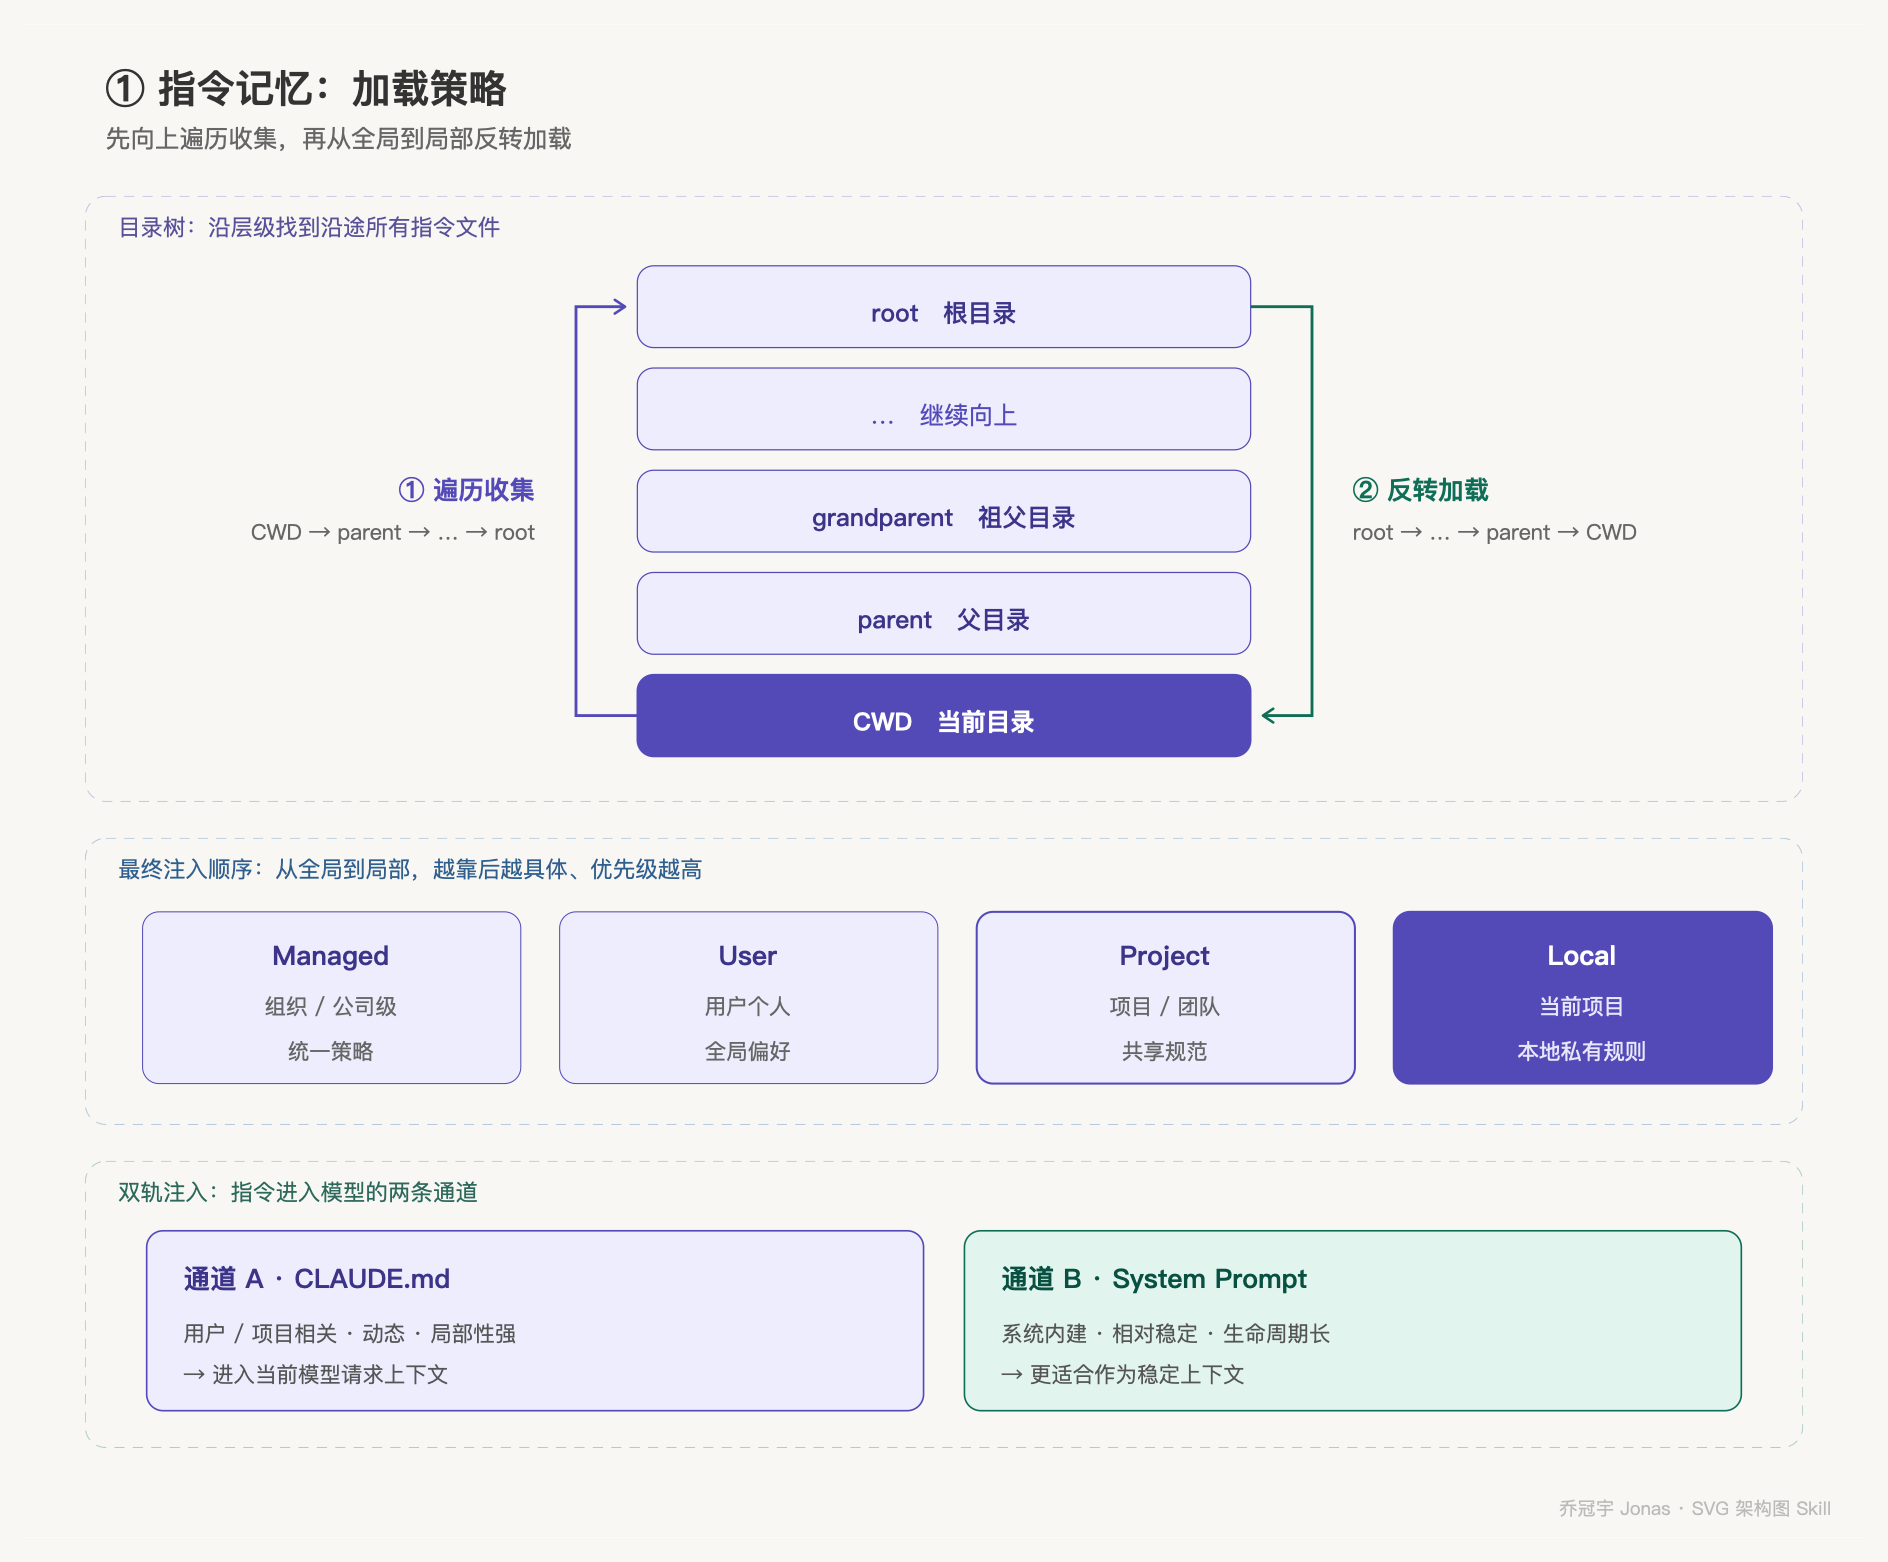
图 3 ① 指令记忆加载策略 —— 左侧肘形折线向上为「遍历收集 CWD → … → root」,右侧肘形折线向下为「反转加载 root → … → CWD」,下方接四级注入顺序与双轨注入。
1.3 设计好处
统一约束
   +
局部定制
   ↓
既规范,又灵活
避免:
- 所有项目都强制使用一套规则
- 每个项目都从零定义规则
- 用户习惯无法复用
1.4 双轨注入架构
指令进入模型可以从两个通道理解:
             指令 / 行为规范
                    │
          ┌─────────┴─────────┐
          ↓                   ↓
      通道 A                通道 B
   用户/项目指令            系统行为规范
          │                   │
     CLAUDE.md              System Prompt
          ↓                   ↓
   上下文中的指令内容       模型系统级约束
通道 A:CLAUDE.md
CLAUDE.md
    ↓
读取 / 聚合
    ↓
进入当前模型请求上下文
特点:
- 用户 / 项目相关
- 动态
- 具有较强的局部性
通道 B:系统行为规范
系统行为规范
    ↓
System Prompt
特点:
- 系统内建
- 相对稳定
- 生命周期长
- 更适合作为稳定上下文的一部分
核心区别
CLAUDE.md
→ “这个用户 / 项目有什么要求”

System Prompt
→ “Agent 本身应该遵守什么行为规范”
第 2 层 | ② 短期会话记忆|Session 级
解决:当前这次对话发生了什么。
主要就是当前 Session 的上下文:
User
 ↓
Assistant
 ↓
Tool Call
 ↓
Tool Result
 ↓
User
 ↓
...
包括:
- 用户问题
- Agent 回复
- Tool 调用
- Tool Result
- 当前上下文信息
2.1 Recent Context
不是简单按照“多少轮对话”计算。
核心受:
Context Window
+
Token Budget
约束。
可以理解为:
完整 Session
      ↓
当前 Context
      ↓
Token Budget
      ↓
Context Window
当上下文越来越长,就需要:
- 截断
- 压缩
- 摘要
- 召回长期记忆
2.2 和长期记忆的区别
短期记忆
→ 当前 Session 发生了什么

长期记忆
→ 跨 Session 以后还需要记住什么
短期记忆更接近当前原始上下文。
长期记忆则是跨 Session 提炼后的持久知识。
第 3 层 | ③ 工作任务记忆|Task 级
解决:当前任务做到哪里了。
短期记忆回答:
“我们刚才聊了什么?”
工作记忆回答:
“这件事情现在做到哪了?”
3.1 存什么?
典型包括:
任务目标
当前进度
已完成步骤
中间结论
失败尝试
待办事项
下一步计划
临时状态
例如:
实现用户登录
│
├── ✓ 数据库表
├── ✓ Entity
├── ✓ Service
├── → Controller
└── ○ 测试
3.2 生命周期
Task Start
    ↓
创建 Task State
    ↓
任务执行
    ↓
不断更新
    ↓
Task Complete
    ↓
清理 / 销毁
它和长期记忆最大的区别:
工作记忆主要是临时状态,不应该把所有 Task State 都永久保存。
只有真正具有长期价值的信息,才应该沉淀到长期记忆。
第 4 层 | ④ 长期记忆|Persistent 级
解决:跨 Session 以后还记得什么。
这是整个记忆体系中真正负责持久化的一层。
4.1 Memory 结构
可以理解为:
memdir
│
├── User
│   └── 用户画像
│
├── Feedback
│   ├── 成功确认
│   └── 错误纠正
│
├── Project
│   └── 项目长期上下文
│
├── Reference
│   └── 外部知识指针
│
└── MEMORY.md
User:用户画像
保存长期稳定的:
- 偏好
- 工作风格
- 经验水平
- 习惯
Feedback:行为反馈
特别重要的是:
错误纠正
→ “以后不要这么做”

成功确认
→ “以后优先这么做”
也就是:
通过用户反馈不断形成 Agent 的长期经验。
Project:项目上下文
例如:
技术栈
架构约定
目录结构
业务规则
项目特殊约束
Reference:外部指针
不是把所有外部知识全部复制进 Memory。
而是保存:
Reference
   ↓
URL
Wiki
官方文档
知识库
代码仓库
需要时再读取。
因此:
Memory 更适合保存“以后应该知道什么 / 去哪里找”,而不是把所有外部知识全部塞进 Memory。
4.2 索引与动态召回
长期记忆不是:
所有 Memory
    ↓
全部塞进 Context
而是:
当前任务
    ↓
Memory 索引
    ↓
候选记忆
    ↓
动态筛选
    ↓
Relevant Memory
    ↓
进入当前 Context
核心目标:
只把当前任务真正需要的长期记忆召回。
4.3 AI 决策式召回
传统 RAG 可以理解为:
Query
 ↓
Embedding
 ↓
Vector Search
 ↓
Top-K
Agent Memory 可以进一步采用:
当前任务
    ↓
候选 Memory
    ↓
AI 判断哪些记忆有用
    ↓
Relevant Memory
也就是:
不一定单纯依赖关键词或向量相似度,而可以让模型参与判断记忆是否真正相关。
这是 Agent Memory 和传统知识库检索之间的重要区别之一。
4.4 为什么 Fork 子 Agent 写 Memory?
不要让主 Agent 同时承担:
业务任务
+
Memory 整理
+
Memory 写入
可以:
                主 Agent
                   │
          ┌────────┴────────┐
          ↓                 ↓
      完成业务任务       Fork Memory Agent
                            ↓
                       整理 / 提炼 / 写入
好处:
- 降低主 Agent 上下文压力
- 减少主 Agent 的额外认知负担
- Memory 操作与业务任务解耦
- 可以后台异步执行
4.5 Memory 读写互斥
多个 Agent 同时操作 Memory 可能出现:
Agent A ──┐
          ├── Memory
Agent B ──┘
可能导致:
- 并发覆盖
- 脏写
- 数据竞争
- 更新丢失
因此需要相应的:
读写互斥 / 锁 / 原子更新 / 版本控制等机制。
第 5 层 | ⑤ 摘要记忆|Compression 级
解决:Session 越来越长,Context Window 不够怎么办。
核心载体:
session-memory.md
这一层需要重点区分两个概念:
Session Memory 更新
        ≠
真正 Context Compact
Session Memory 是后台持续维护的摘要状态;Context Compact 才是真正让主 Context 变小的过程。
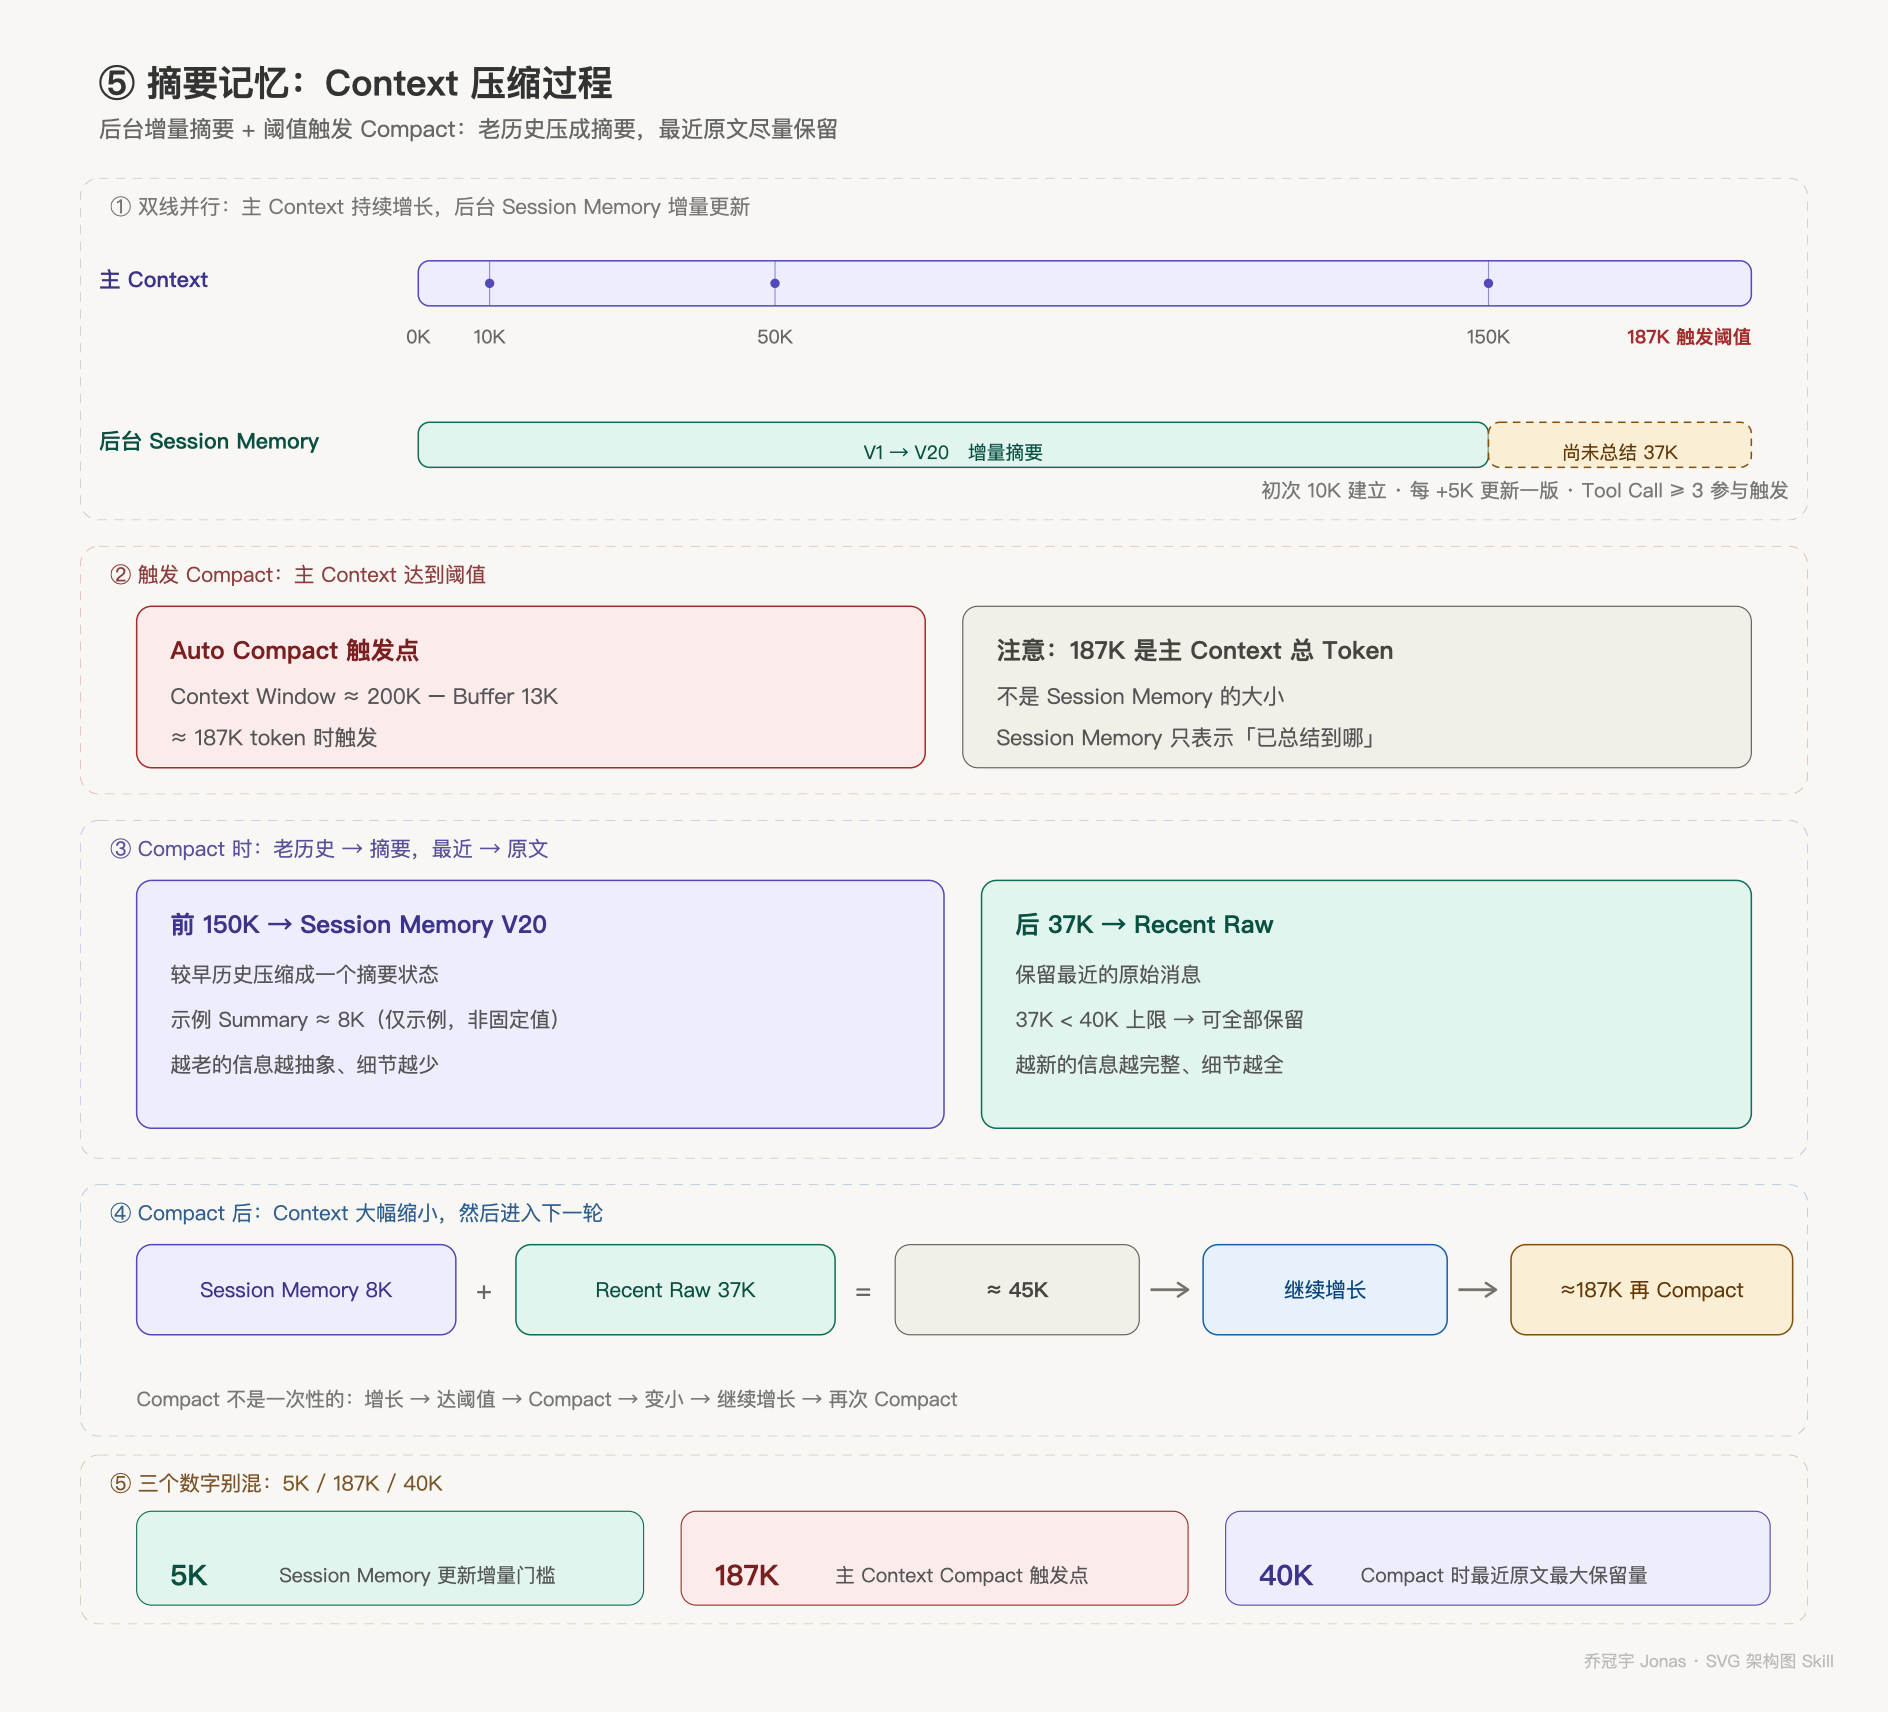
图 2 ⑤ 摘要记忆压缩过程 —— 主 Context 与后台 Session Memory 双时间轴并行;≈187K 触发 Compact;老历史压成摘要、最近 40K 以内保留原文;缩到 ≈45K 后继续增长并再次 Compact。
5.1 两条线同时运行
整个过程可以理解成:
                    Claude Code
                         │
          ┌──────────────┴──────────────┐
          │                             │
          ▼                             ▼
     主 Context                  后台 Session Memory
          │                             │
          │                             ▼
          │                       Forked Agent
          │                             │
          │                             ▼
          │                     session-memory.md
          │                             │
          │                       不断更新版本
          │
          ▼
    Context 持续增长
          │
          ▼
    接近 Compact 阈值
          │
          ▼
     真正 Compact
主 Context 是:
当前模型调用真正携带的上下文。
可以包括:
System Prompt
+
Claude Code Instructions
+
当前 Session 消息
+
Assistant 消息
+
Tool Use
+
Tool Result
+
当前请求需要的其他信息
正常情况下:
后台 Session Memory 更新,不会立即删除主 Context 中的原始消息。
5.2 Session Memory 如何渐近式更新
Session Memory 并不是:
Context 爆掉
    ↓
一次性总结整个 Session
而更接近:
已有 Memory
     +
上一次提取之后新增的原始消息
     ↓
新的 Memory
即:
增量 / 渐近式维护 Session Memory。
例如:
10K 原始消息
   ↓
Memory V1

新增 5K
   ↓
V1 + 新增原始消息
   ↓
Memory V2

再新增 5K
   ↓
V2 + 新增原始消息
   ↓
Memory V3
不是每次都重新总结全部历史。
关键状态
源码分析中可以看到类似:
lastSummarizedMessageId
tokensAtLastExtraction
sessionMemoryInitialized
它们用于知道:
已经总结到哪里
+
上次总结时是多少 Token
+
Session Memory 是否已经初始化
因此后台 Agent 不需要每次从头处理整个 Session。
Session Memory 默认触发参数
在我们分析的 Claude Code 源码版本中,可以看到:
| 参数 | 默认值 | 作用 |
|---|---|---|
| 首次建立 Session Memory | 10K tokens | 对话达到一定规模后开始建立 |
| 后续更新 Token 增量 | 5K tokens | 距离上次提取新增约 5K 后满足更新条件 |
| Tool Call 门槛 | 3 次 | 与 Token 增长、自然对话断点共同参与触发判断 |
核心逻辑可以理解为:
Token 增长 ≥ 5K
        AND
Tool Call ≥ 3
或者:
Token 增长 ≥ 5K
        AND
最新 Assistant Turn 没有 Tool Call
所以:
5K 是必要的 Token 增量条件;3 次 Tool Call 不是任何情况下都必须满足的绝对条件。
同时需要注意:
不同 Claude Code 版本可能调整这些内部参数,因此不要把这些数字理解成永久固定的 API 合同。
5.3 Session Memory 是异步的
主 Context 和 Session Memory 的进度不是完全同步的。
例如:
主 Context
0K → 10K → 50K → 100K → 150K → 180K → 187K
                                      ↑
                                继续正常执行
与此同时:
Session Memory
10K  → V1
15K  → V2
20K  → V3
...
150K → V20
因此完全可能出现:
主 Context = 187K

Session Memory
只总结到了 150K
甚至此时后台 Memory Agent 仍然可能正在更新。
因此:
主 Context 当前长度 ≠ Session Memory 当前已经总结到的位置。
5.4 什么时候真正 Compact?
这里需要区分:
Session Memory 更新
和:
Context Compact
Session Memory 更新解决:
“提前准备一份压缩后的 Session 状态。”
Context Compact解决:
“主 Context 已经太长了,必须真正把它缩小。”
200K Context 的示例
在我们讨论的源码配置/分析中,可以用:
Context Window ≈ 200K
Auto Compact Buffer ≈ 13K
来理解:
200K - 13K
≈ 187K
因此可以把:
≈ 187K
理解为这个配置下的 Auto Compact 触发位置。
注意:
187K 是主 Context 的总 Token 数,不是 Session Memory 的大小。
5.5 真正 Compact 时发生什么?
假设:
主 Context = 187K
但后台 Session Memory 最新版本只总结到了:
150K
那么:
0K ───────────────── 150K ─────────────── 187K
│                     │                    │
│ 已被 Memory 总结     │                    │
│                     │                    │
└─────────────────────┘                    │
                                            │
                                   尚未总结的原始消息
真正 Compact 时:
前面的 150K 由:
Session Memory V20
来代表。
后面的内容尽量保留最近的原始消息。
最终可以理解为:
┌──────────────────────────────┐
│ Session Memory V20           │
│                              │
│ 代表较早历史的压缩状态         │
├──────────────────────────────┤
│ 最近的原始消息                 │
│                              │
│ ≤ 40K tokens                 │
└──────────────────────────────┘
5.6 40K 是什么?
这里特别容易和 5K、187K 混淆。
5K
→ Session Memory 后续更新的 Token 增量门槛

187K
→ 示例配置下主 Context 的 Auto Compact 触发位置

40K
→ 真正 Compact 时,最近原始消息的最大保留量
所以:
40K 不是 Session Memory 的大小。
而是:
Compact 时,为了保留最近上下文而设置的 recent raw messages 上限。
源码分析中的相关配置可以看到类似:
minTokens = 10K
minTextBlockMessages = 5
maxTokens = 40K
其中 40K 是 recent messages 的 hard cap。
5.7 为什么 Compact 后还要保留 Raw?
因为摘要存在信息损失。
例如原始消息:
用户:
把 payment-service 的超时时间从 3 秒改成 5 秒。

Agent:
已修改 application.yml。

用户:
另外把 Redis timeout 改成 10 秒。

Agent:
已修改。
如果全部压成:
项目配置已经完成相关修改。
虽然节省了大量 Token,但:
3 秒 → 5 秒
Redis → 10 秒
这些具体细节就可能丢失。
因此 Compact 通常采用:
老历史
  ↓
Summary

最近历史
  ↓
Raw
形成:
Summary
+
Recent Raw
即:
越老的信息越抽象,越新的信息越完整。
5.8 第一次 Compact 的例子
假设:
Context Window = 200K
Compact ≈ 187K
达到:
187K
此时:
Session Memory
已经总结到 150K
那么:
150K
 ↓
Session Memory V20

37K
 ↓
最近原始消息
因为:
37K < 40K
所以这 37K 可以全部保留。
Compact 后:
Session Memory V20
+
37K Recent Raw
如果:
Session Memory Summary ≈ 8K
这里只作为示例:
8K + 37K
≈ 45K
那么主 Context 就从:
187K
大幅下降到:
≈ 45K
注意:
8K 只是示例,不是 Claude Code 固定规定 Summary 必须是 8K。
5.9 如果尚未总结的原始消息超过 40K
例如:
Context = 187K

Session Memory
只总结到了 120K
那么:
187K - 120K
= 67K
但最近 Raw 的上限约为:
40K
因此不会把全部 67K 原文都保留下来。
而是从最近消息向前选择:
最近消息
    ↑
    │
    │ ≤ 40K
    │
────┴────────────────
更老的部分
同时需要考虑:
- 消息边界
- Tool Use
- Tool Result
- 上下文结构完整性
核心思想:
优先保留最近的、最完整的原始交互。
5.10 Compact 完以后,新消息怎么算?
这是理解整个机制非常关键的一点。
假设 Compact 后:
Session Memory = 8K
Recent Raw = 37K
那么:
当前 Context
= 8K + 37K
= 45K
之后用户又产生:
+10K
那么新的 Context 就继续增长:
8K Summary
+
37K Recent Raw
+
10K New Raw
=
55K
然后继续:
55K
 ↓
80K
 ↓
120K
 ↓
150K
 ↓
...
 ↓
≈187K
 ↓
再次 Compact
所以 Context Compact 不是“一次性的”。
它是一个循环:
Context 增长
    ↓
达到阈值
    ↓
Compact
    ↓
Context 变小
    ↓
继续增长
    ↓
再次 Compact
5.11 第二次 Compact
假设第二次达到:
≈187K
此时后台 Session Memory 可能已经更新到:
V30
那么第二次 Compact 可以理解为:
V30
+
V30 之后最近的 Raw Messages
然后再次形成一个新的较小 Context。
因此整个生命周期:
第一次
────────────────────

完整原始 Context
        ↓
后台维护 V1 V2 V3...
        ↓
≈187K
        ↓
Compact
        ↓
V20 + Recent Raw


第二次
────────────────────

V20
+
Recent Raw
+
New Messages
        ↓
继续增长
        ↓
后台产生 V21 V22 V23...
        ↓
≈187K
        ↓
Compact
        ↓
V30 + Recent Raw
5.12 长期运行后的信息保真度
因此会出现一个自然规律:
距离当前越远
      ↓
经历的 Summary / Compact 次数越多
      ↓
信息越来越抽象
      ↓
细节保真度通常越低
而:
距离当前越近
      ↓
越可能仍然保留 Raw
      ↓
细节越完整
所以它本质上是在:
Context Window 有限的情况下,用“历史摘要 + 最近原文”换取长期连续性。
第 6 层 | ⑥ AutoDream|离线级
解决:长期运行后,Memory 越来越多、越来越乱怎么办。
AutoDream 可以理解为:
Agent 空闲或后台运行时,对长期 Memory 进行整理、重塑和治理。
它和 Session Memory Agent 不是一回事。
6.1 三者区别
Session Memory Agent
→ 这次 Session 发生了什么?

Memory Extraction Agent
→ 这次对话有什么以后还应该记住?

AutoDream
→ 过去积累的长期记忆现在怎么整理?
所以:
Session Memory
→ 当前 Session 压缩

Memory Extraction
→ 新长期记忆提炼

AutoDream
→ 长期 Memory 治理
6.2 核心流程
已有长期 Memory
        ↓
定向探索
        ↓
发现重复 / 冲突 / 过期内容
        ↓
信息整合
        ↓
去重 / 合并 / 重写
        ↓
更新结构
        ↓
重建索引
类似人类:
平时产生大量笔记
        ↓
定期整理
        ↓
删除重复内容
        ↓
合并相关知识
        ↓
更新过期内容
        ↓
重新分类
        ↓
建立索引
所以:
AutoDream 本质是长期 Memory 的离线治理与重塑。
6.3 为什么需要 AutoDream?
长期运行后 Memory 可能出现:
重复
过期
冲突
碎片化
索引混乱
因此需要:
Memory
 ↓
发现问题
 ↓
整理
 ↓
合并
 ↓
更新
 ↓
重建索引
最终让长期 Memory 更:
- 稳定
- 精简
- 结构化
- 容易召回
6.4 并发安全
AutoDream 可能和正常 Agent 同时操作 Memory:
        Memory
       ↙      ↘
   Agent     AutoDream
因此需要相应的并发控制,例如:
文件锁
版本号
CAS
原子更新
核心目标:
避免 AutoDream 整理 Memory 时覆盖 Agent 刚刚写入的新内容。
横向篇 | 缓存体系|性能层
缓存不是第七层记忆。
六层解决的是“记忆是什么、生命周期是什么、如何压缩和治理”;缓存解决的是“已有数据/上下文如何减少重复处理”。
这里尤其要区分:
Harness / Claude Code 的上下文组织
                ≠
Anthropic Model API 的 Prompt Cache
缓存体系一共三层:
第一层:Harness / 本地数据缓存
第二层:Context / Session 复用
第三层:Model / API Prompt Cache
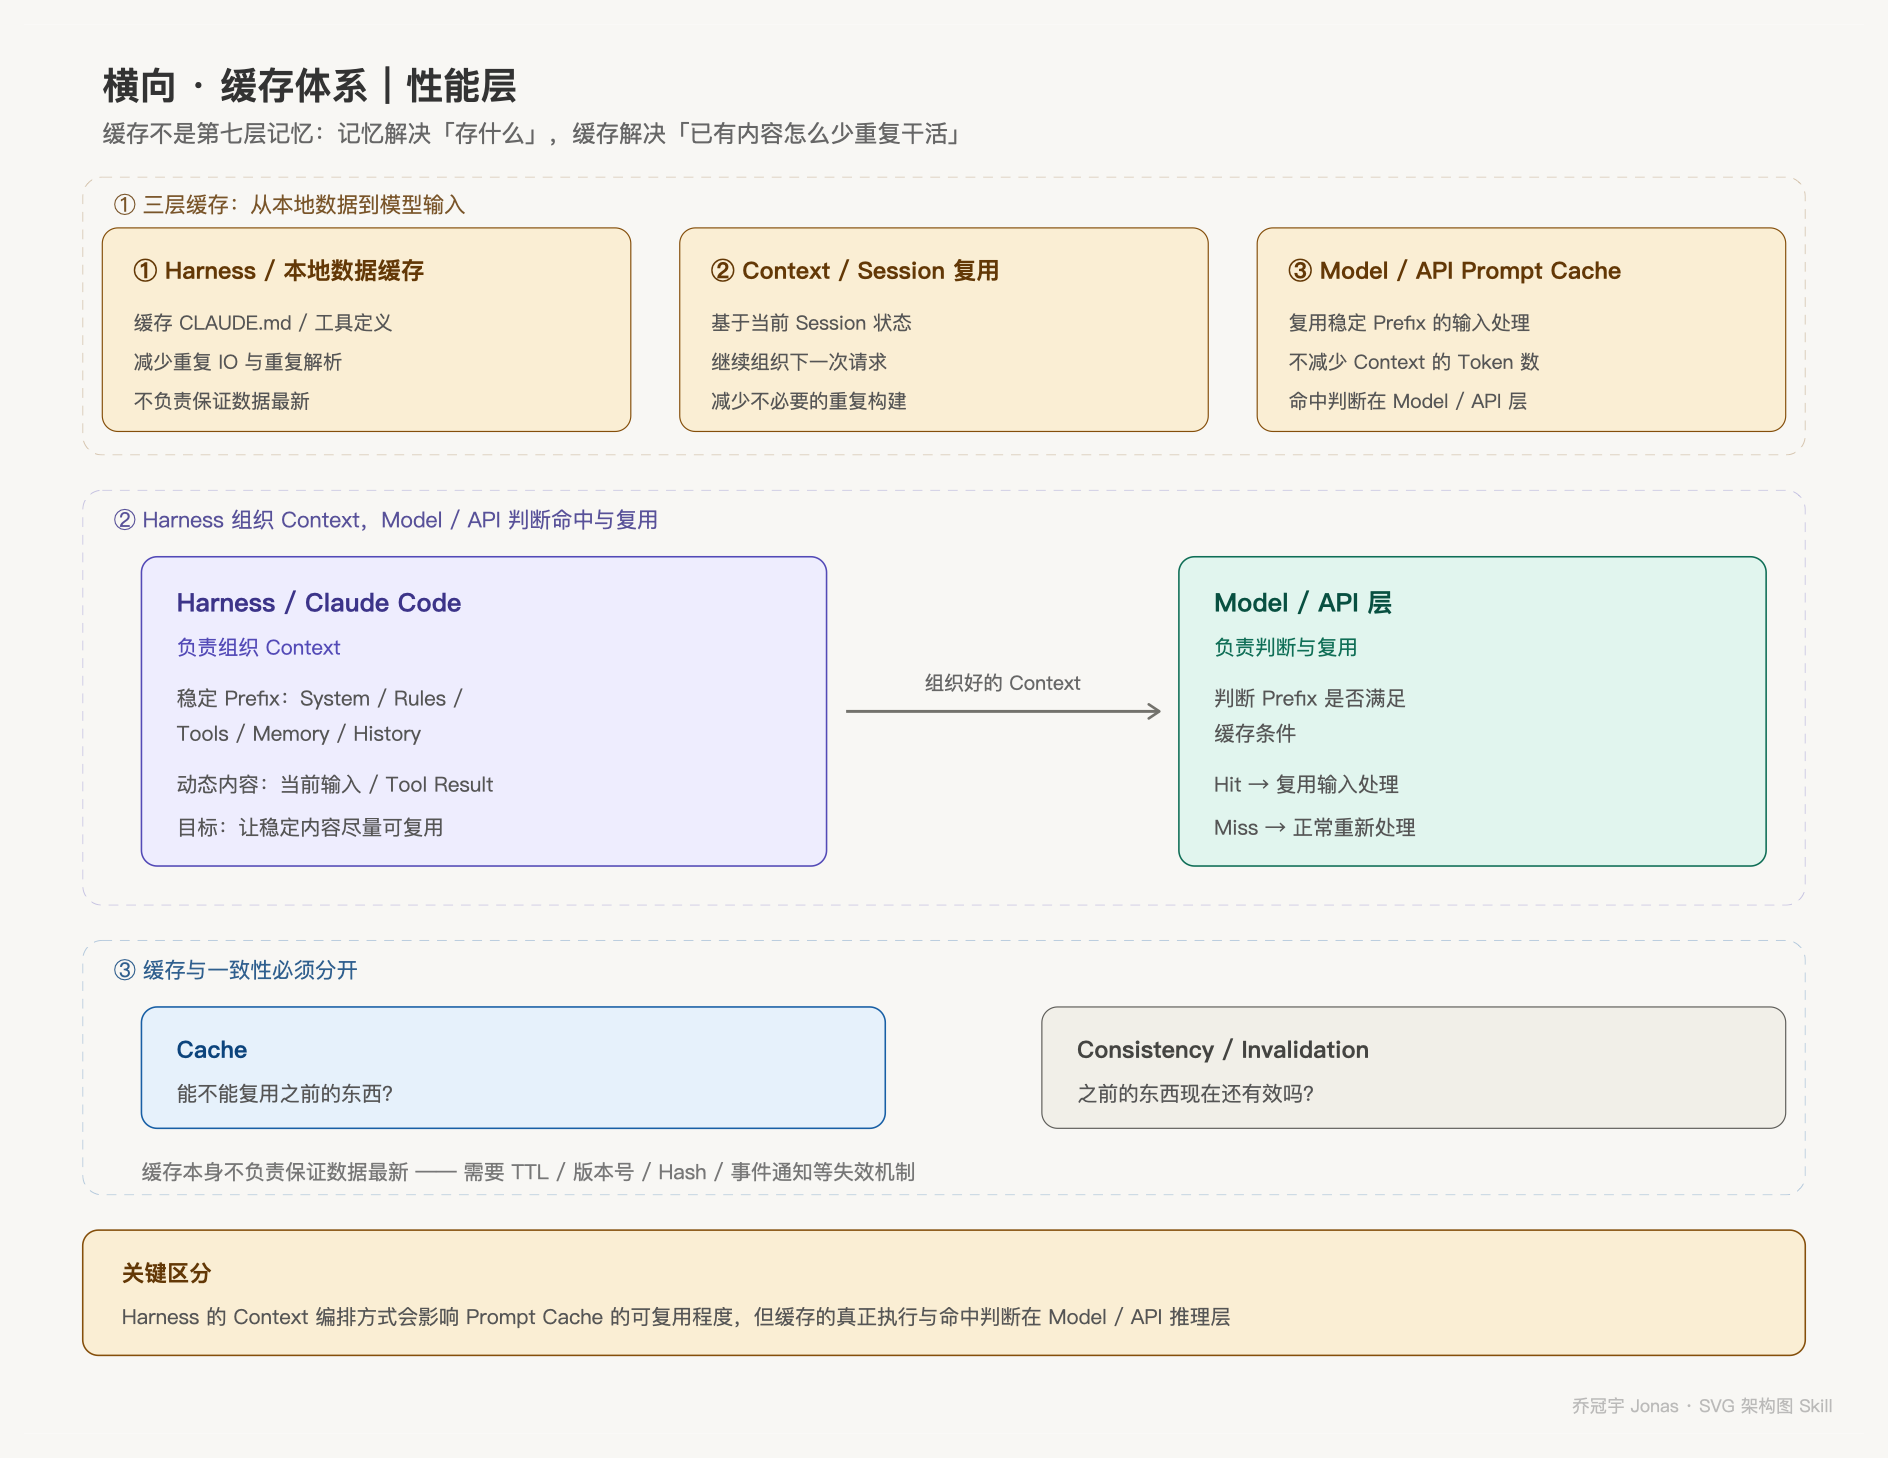
图 4 横向缓存体系 —— 三层缓存(Harness 本地缓存 / Context·Session 复用 / Model·API Prompt Cache)、Harness 与 Model/API 的职责分工,以及「缓存」与「一致性」必须分开。
7.1 第一层:Harness / 本地数据缓存
如果 Harness 对某些本地数据做缓存,例如:
CLAUDE.md
项目配置
已经读取 / 解析的数据
工具定义
Memory 文件读取结果
它的作用主要是:
第一次:
磁盘
 ↓
读取
 ↓
解析
 ↓
得到结果

后续:
Cache
 ↓
直接复用
作用:
减少重复 IO
减少重复解析
降低本地处理开销
但必须注意:
这种缓存本身不负责保证数据最新。
如果原始数据发生变化,就需要通过:
文件修改时间
版本号
Hash
TTL
事件通知
其他失效机制
等方式判断缓存是否还能使用。
因此:
缓存本身 ≠ 数据一致性机制。
7.2 第二层:Context / Session 复用
这一层更准确地理解为:
减少不必要的上下文重新构建,而不是一种独立的“模型缓存”。
例如当前 Session 已经存在:
System
+
Rules
+
Tools
+
Memory
+
历史 Context
Harness 会基于当前 Session 状态继续组织下一次请求,而不是每次都把整个 Agent 状态从零开始构建。
因此它解决的是:
Session 状态连续性
+
Context 组织效率
这一层和 Prompt Cache 不要混为一谈。
7.3 第三层:Model / API Prompt Cache
真正意义上的 Prompt Cache 位于:
Model / API 推理层
而不是 Harness 自己实现。
它缓存的不是:
❌ Memory.md 文件
❌ 最终答案
❌ 一个普通的文件缓存
而是:
对于重复输入 Prefix,模型侧可以复用之前已经完成的输入处理。
例如第一次:
System
+
Rules
+
Tools
+
100K History
+
Current Question
第二次:
System
+
Rules
+
Tools
+
100K History
+
New Question
如果前面的稳定部分满足 Prompt Cache 的缓存条件:
System
+
Rules
+
Tools
+
100K History
就可以作为稳定 Prefix 被复用。
Prompt Cache 的作用
核心是:
第一次:

100K Prefix
    ↓
模型处理
    ↓
产生可复用的缓存状态


第二次:

同样的 100K Prefix
    ↓
Prompt Cache Hit
    ↓
复用之前的处理
    ↓
只需要继续处理变化部分
所以:
Prompt Cache 不减少 Context 中实际存在的 Token 数量,而是减少重复输入的计算成本,并在适用的 API 计费规则下减少缓存输入的处理成本。
例如:
第一次:
Input = 100K

第二次:
Input = 100K
并不意味着第二次 Context 变成:
Input = 5K
而是:
Context 仍然 ≈100K

其中:
稳定 Prefix → Cache Hit
新增内容   → 正常处理
7.4 Harness 和 Prompt Cache 到底是什么关系?
这是最容易混淆的地方。
正确关系:
Claude Code / Harness
        │
        │ 负责组织 Context
        ▼
┌──────────────────────────┐
│ 稳定 Prefix               │
│ System / Rules / Tools   │
│ Memory / History         │
├──────────────────────────┤
│ 动态内容                  │
│ Current User Input       │
│ Tool Result              │
└─────────────┬────────────┘
              │
              ▼
       Model / API 层
              │
              ▼
        Prompt Cache
              │
       ┌──────┴──────┐
       ↓             ↓
     Hit            Miss
       ↓             ↓
  复用处理结果      重新处理
因此:
Harness 做什么?
组织 Context,让稳定内容尽量稳定、连续、可复用。
Model/API 做什么?
真正判断 Prompt Cache 是否命中,并复用之前的输入处理。
所以不能理解成:
Harness
  ↓
自己决定“这个 Prompt 是缓存”
更准确是:
Harness
  ↓
把 Context 组织好
  ↓
形成稳定 Prefix
  ↓
Model/API
  ↓
判断是否满足 Prompt Cache 条件
7.5 为什么 Harness 的 Context 组织会影响 Prompt Cache?
因为 Prompt Cache 关注的是:
输入的稳定 Prefix。
情况 A:稳定内容在前
System
Rules
Tools
Memory
History
────────────
Current Question
下一次:
System
Rules
Tools
Memory
History
────────────
New Question
前面大量内容没有变化。
因此更容易形成稳定 Prefix。
情况 B:动态内容混在前面
Current Question
System
Tools
History
下一次:
New Question
System
Tools
History
那么一开始就发生变化。
后面的内容即使没变,也不再属于相同的前缀。
因此:
Harness 的 Context 编排会影响 Prompt Cache 的可复用程度。
但它仍然不是 Harness 在实现 Prompt Cache。
7.6 缓存和一致性必须分开
这是缓存体系中最重要的概念之一:
Cache
→ 能不能复用之前的东西?

Consistency / Invalidation
→ 之前的东西现在还有效吗?
两者不是一个问题。
例如本地文件:
10:00
CLAUDE.md = V1
 ↓
Harness Cache = V1

10:05
CLAUDE.md 被修改
 ↓
文件 = V2
如果没有失效机制:
Harness
 ↓
继续使用 V1
那么当然可能产生旧数据。
因此真正完整的缓存逻辑是:
数据源
  ↓
Cache
  ↓
判断 Cache 是否有效
  │
  ├── 有效 → 复用
  │
  └── 失效 → 重新读取
而 Prompt Cache 又是另外一回事:
Harness
  ↓
最新 Context
  ↓
Model API
  ↓
Prefix 是否满足缓存条件?
  │
  ├── Hit → 复用模型输入处理
  │
  └── Miss → 正常处理
第三层 · 总:最终总结
1. 整体关系图
最终可以把整个体系理解成:
                    Claude Code
                         │
        ┌────────────────┼────────────────┐
        │                │                │
        ▼                ▼                ▼
    记忆体系          Context 管理       性能优化
        │                │                │
        │                │                │
  ┌─────┴─────┐          │          ┌─────┴─────┐
  │           │          │          │           │
规则       长期记忆      Compact   Harness    Prompt Cache
Session    AutoDream               Cache      Model/API
Task       Memory
2. 六层记忆解决什么
① 指令
→ 应该怎么做

② 短期
→ 刚才聊了什么

③ 工作
→ 现在做到哪

④ 长期
→ 以前记住什么

⑤ 摘要
→ 太长了怎么压

⑥ AutoDream
→ 长期记忆乱了怎么整理
3. 缓存解决什么
Harness / 本地缓存
→ 少做重复的数据读取和处理

Context / Session 复用
→ 少做不必要的上下文重新构建

Model Prompt Cache
→ 少做重复的模型输入计算
4. 六层一览(最终收口)
| 层级 | 核心问题 | 关键载体 | 关键机制 |
|---|---|---|---|
| ① 指令记忆 | 应该怎么做 | CLAUDE.md |
四级作用域 + 反转加载 + 双轨注入 |
| ② 短期会话记忆 | 刚才聊了什么 | Recent Context | 受 Context Window / Token Budget 约束 |
| ③ 工作任务记忆 | 现在做到哪 | Task State | 任务生命周期内创建与销毁 |
| ④ 长期记忆 | 以前记住什么 | memdir / MEMORY.md |
索引 + 动态召回 + 读写互斥 |
| ⑤ 摘要记忆 | 太长了怎么压 | session-memory.md |
渐近式更新 + Compact(Summary + Recent Raw) |
| ⑥ AutoDream | 乱了怎么整理 | 长期 Memory | 离线治理:去重 / 合并 / 重建索引 |
| 横向 · 缓存 | 怎么少重复干活 | Harness / Model API | 本地缓存 + Context 复用 + Prompt Cache |
5. 最终一句话
六层记忆解决“记什么、怎么保存、怎么压缩、怎么治理”;缓存解决“已有内容怎么更高效地复用”。其中 Prompt Cache 的真正执行与命中判断位于 Model/API 推理层,Harness 的主要作用是组织 Context、保持稳定 Prefix,从而让这种缓存更容易发挥作用。