Agent 开发需要理解的算法架构知识
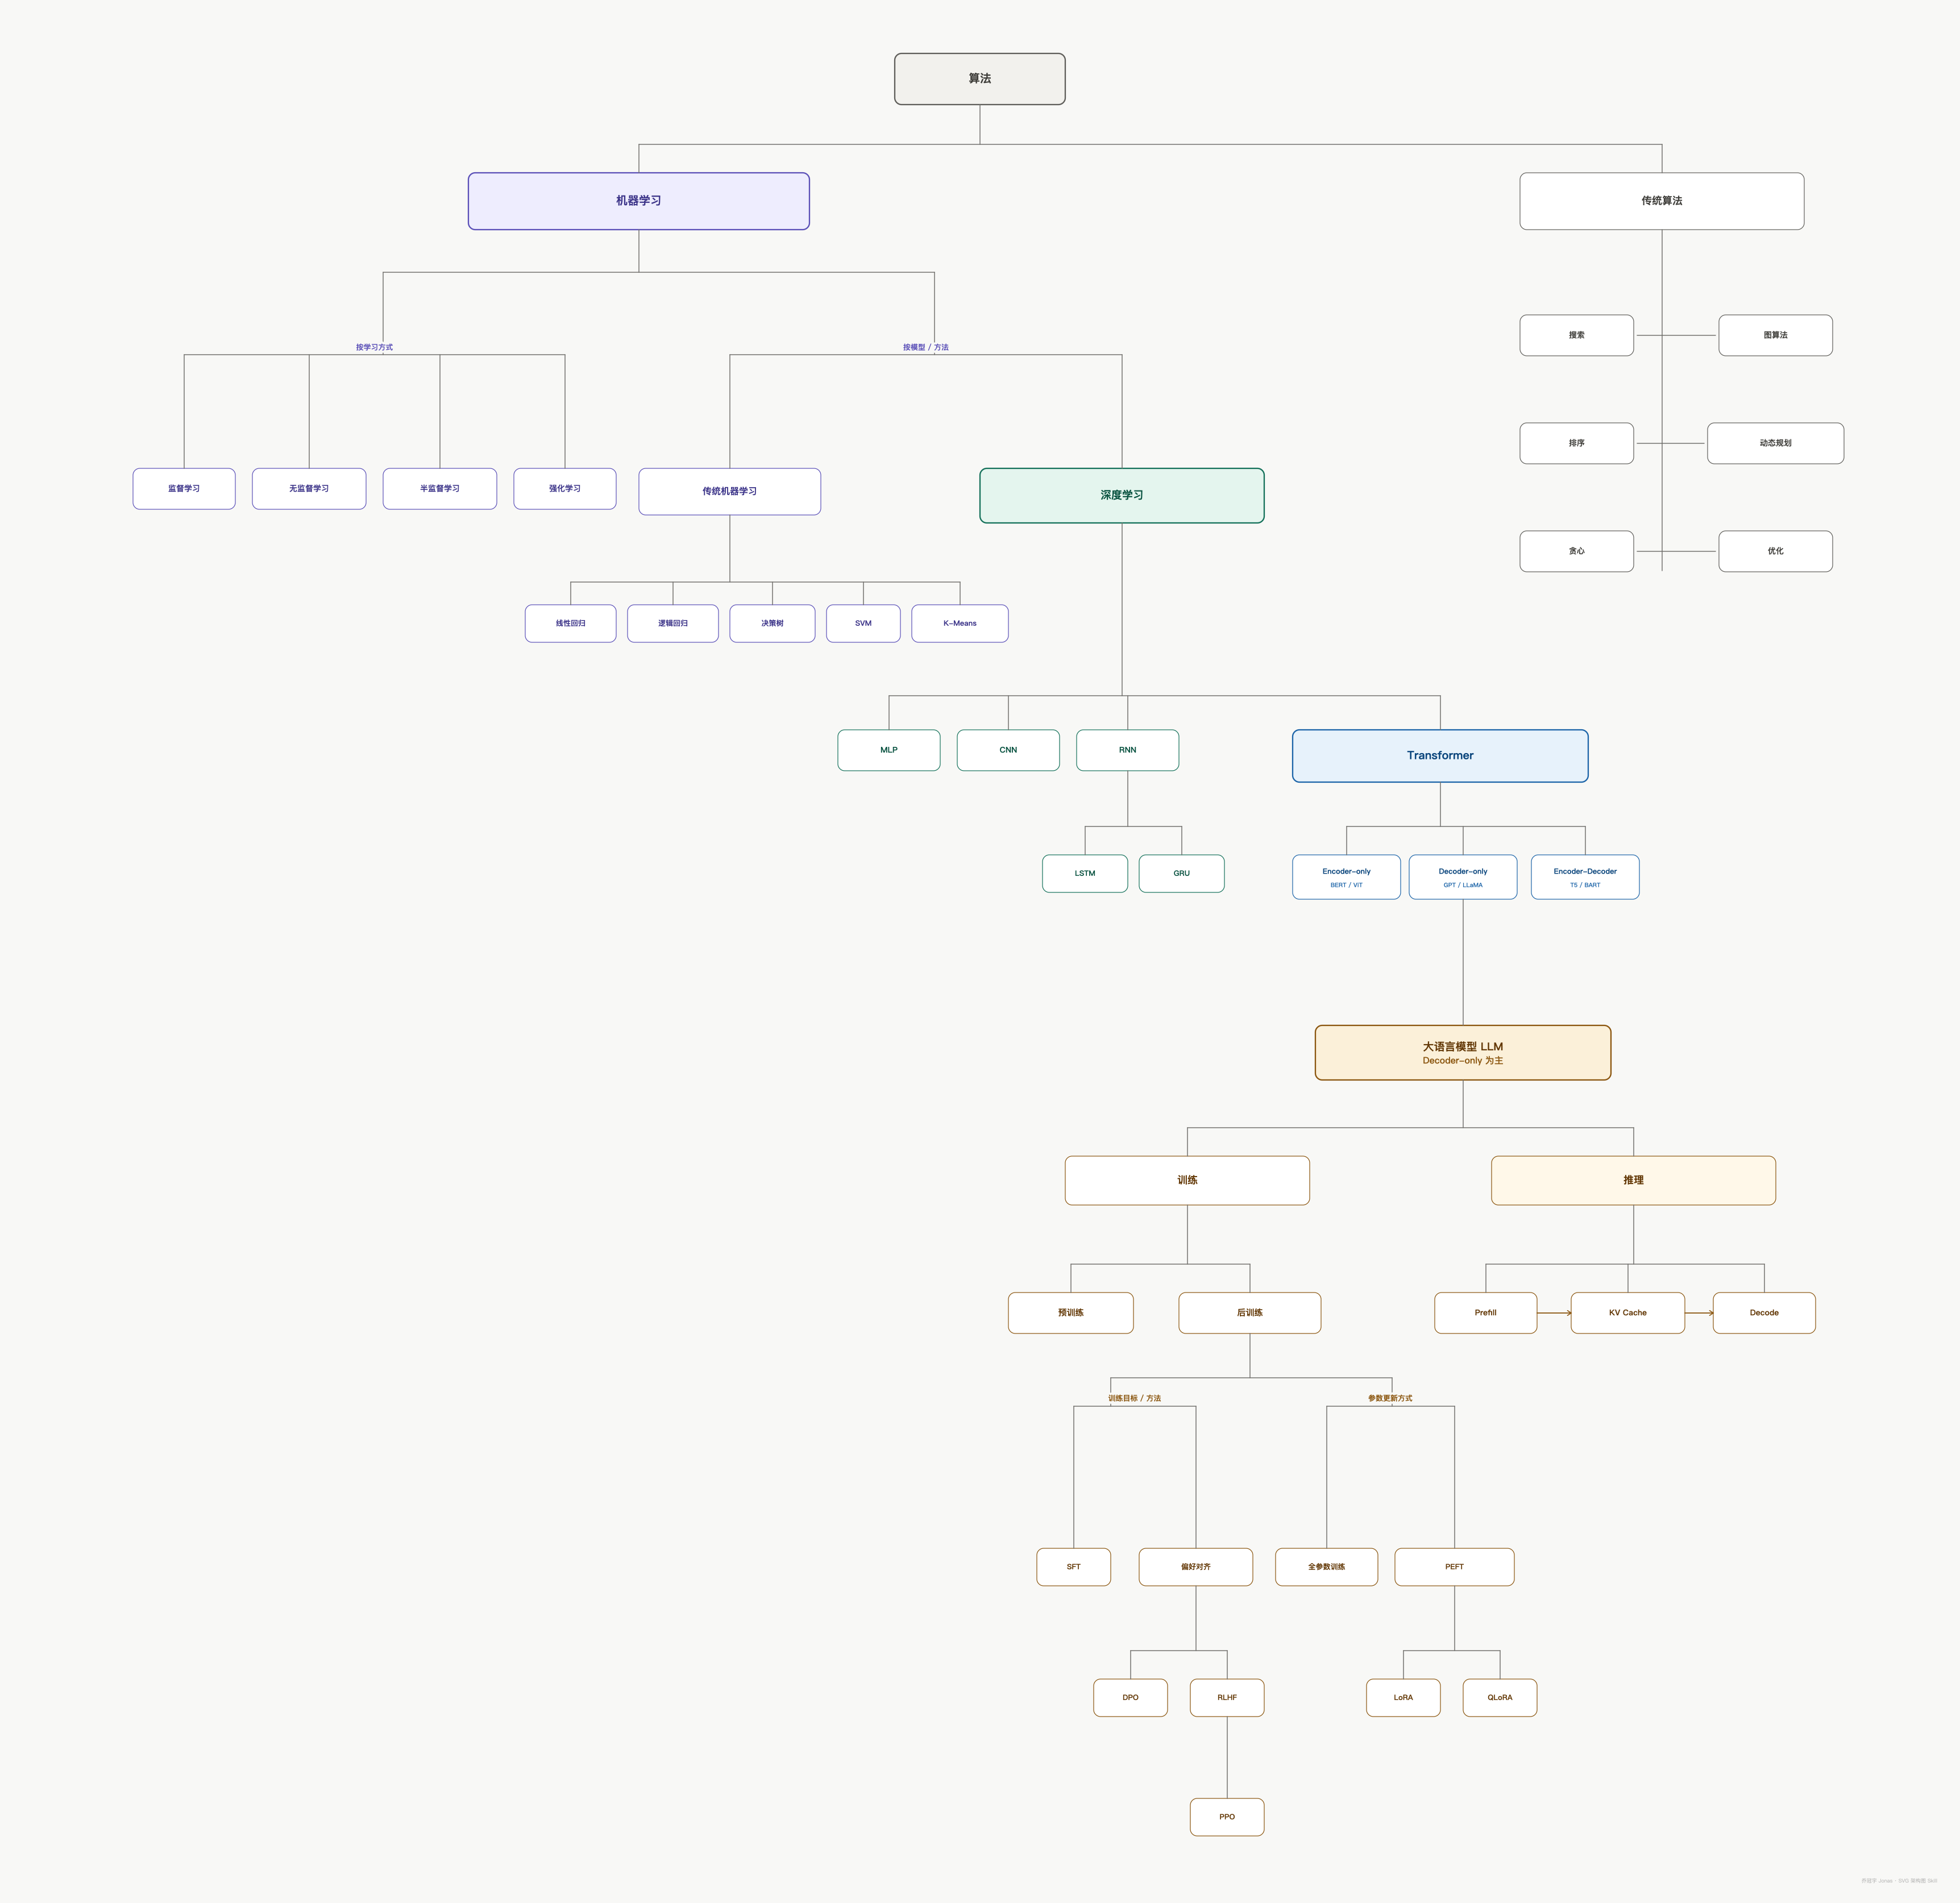
从传统算法 → 机器学习 → 深度学习 → Transformer → Decoder-only → LLM 训练 → LLM 推理 → Agent
一、传统算法
1. 什么是传统算法?
传统算法可以理解为:
人把解决问题的规则和步骤设计好,计算机按照这些规则执行。
例如:
输入数据
   ↓
人工设计规则
   ↓
算法执行
   ↓
得到结果
比如:
- 排序:按照某种规则把数据排好
- 搜索:按照某种策略寻找目标
- 最短路径:寻找代价最小的路径
- 动态规划:通过保存子问题结果求解复杂问题
- 贪心:每一步选择当前最优方案
- 优化:在约束条件下寻找最优解
传统算法的核心特点是:
规则主要由人设计,而不是让机器从数据中自己学习。
2. 常见传统算法
传统算法并不是一个严格的算法分类体系,这里主要从工程和算法学习中比较常见的几类来看。
搜索
是什么:
在一个状态空间中,根据一定策略不断探索,寻找目标状态或者可行解。
例如:
当前状态
   ↓
选择下一步
   ↓
新的状态
   ↓
继续搜索
   ↓
目标状态
常见方法:
- BFS:广度优先搜索,逐层寻找
- DFS:深度优先搜索,一条路径深入到底
- Dijkstra:寻找带权图中的最短路径
- A*:加入启发式信息,加速搜索
- Minimax:博弈问题中的对抗搜索
- MCTS:通过模拟探索决策空间
核心解决:
“从当前状态,怎么找到目标?”
图算法
是什么:
把现实问题抽象成:
节点 Vertex
    +
边 Edge
然后研究节点之间的连接关系、路径和结构。
例如:
A —— B —— C
|         |
D ——————— E
常见问题:
- 图遍历
- 最短路径
- 最小生成树
- 拓扑排序
- 强连通分量
- 最大流
- 二分图匹配
例如:
地图中的城市可以看成节点,道路可以看成边,最短路径算法就可以计算两个城市之间的最短路线。
核心解决:
“怎么分析和处理节点之间的关系?”
排序
是什么:
按照某个关键字,把数据整理成有序序列。
常见方法:
- 快速排序:平均
O(n log n) - 归并排序:
O(n log n) - 堆排序:
O(n log n) - 计数排序:
O(n+k) - 基数排序:
O(d(n+k))
排序本身通常不是最终目的,而是为了方便后续:
- 查找
- 比较
- 合并
- 统计
- 去重
例如:
原始数据:

8  3  5  1  9

      ↓ 排序

1  3  5  8  9
核心解决:
“如何高效地把数据组织成有序结构?”
动态规划
是什么:
把一个复杂问题拆成多个子问题,并保存已经计算过的结果,避免重复计算。
核心思想:
大问题
 ↓
多个子问题
 ↓
保存子问题结果
 ↓
利用状态转移
 ↓
得到最终答案
通常需要:
- 状态定义
- 状态转移
- 初始化
- 遍历顺序
- 最终答案
常见问题:
- 背包问题
- 最长公共子序列
- 最长递增子序列
- 编辑距离
- 一些最短路径问题
核心解决:
“如何利用子问题之间的关系,高效求解复杂问题?”
贪心
是什么:
每一步都选择当前看起来最优的方案,并且一般不回头修改。
例如:
当前有多个选择
      ↓
选择当前最优
      ↓
继续下一步
      ↓
再选择当前最优
常见问题:
- 区间调度
- Huffman 编码
- 最小生成树
- 部分硬币找零
- 任务安排
但要注意:
贪心并不是“只要每一步选最优就一定正确”。
必须证明问题具有相应的贪心选择性质。
优化
是什么:
在一定约束条件下,让某个目标函数达到最大或者最小。
可以抽象成:
决策变量
   ↓
目标函数
   ↓
约束条件
   ↓
寻找最优解
例如:
给定预算和人员数量,如何让项目收益最大?
常见:
- 线性优化
- 非线性优化
- 凸优化
- 非凸优化
- 连续优化
- 离散优化
常见方法:
- 梯度下降
- 牛顿法
- 线性规划
- 整数规划
这里需要注意:
机器学习训练本质上也离不开优化。
例如神经网络训练就是不断调整参数,使损失函数尽可能小。
3. 为什么从传统算法走向机器学习?
传统算法最大的特点是:
规则由人设计。
但是现实世界的问题越来越复杂。
例如垃圾邮件识别。
传统算法可能需要人工写:
如果出现“中奖”
并且出现“免费”
并且出现某些关键词
→ 判断为垃圾邮件
但现实中的语言非常复杂,很难把所有规则写出来。
于是产生了新的思路:
传统算法:

数据 + 人工规则
       ↓
     结果

机器学习:

数据 + 目标
       ↓
   模型学习规律
       ↓
     结果
于是进入机器学习。
二、机器学习
1. 什么是机器学习?
机器学习的核心思想是:
不再完全依赖人手工编写规则,而是让模型从数据中学习输入和输出之间的规律。
例如垃圾邮件分类:
大量邮件数据
     +
垃圾邮件 / 正常邮件标签
          ↓
       机器学习
          ↓
      分类模型
          ↓
输入新邮件 → 垃圾 / 正常
所以机器学习的核心变化是:
从“人工写规则”转向“从数据学习规律”。
2. 按学习方式分类
机器学习按照“有没有标签、怎么获得反馈”可以分为几种常见方式。
监督学习
是什么:
使用带标签的数据学习输入到输出之间的映射关系。
输入 X → 正确答案 Y
例如:
房屋面积、地段、楼层
        ↓
      房价
常见任务:
- 分类
- 回归
常见应用:
- 房价预测
- 垃圾邮件分类
- 风控
- 用户点击预测
- 图像分类
核心特点:
训练数据有明确的“正确答案”。
无监督学习
是什么:
数据没有人工标签,让模型自己发现数据内部的结构。
例如:
大量用户
 ↓
模型根据行为特征
 ↓
自动分成几个群体
常见方法:
- K-Means
- 聚类
- 降维
- 异常检测
常见应用:
- 用户分群
- 商品聚类
- 文档聚类
- 异常检测
- 数据探索
核心特点:
没有明确答案,重点是发现数据本身的结构。
半监督学习
是什么:
同时利用少量有标签数据和大量无标签数据。
例如:
1000 万张图片
      ↓
只有 1 万张有人工标签
      +
999 万张没有标签
      ↓
半监督学习
核心解决的问题:
人工标注成本太高,如何利用大量无标签数据?
强化学习
是什么:
让智能体在环境中不断采取动作,根据环境反馈的奖励来学习策略。
核心元素:
Agent
 ↓ Action
Environment
 ↓
State + Reward
 ↓
Agent 更新策略
例如:
- 游戏 AI
- 机器人控制
- 自动驾驶决策
- 推荐系统
- 复杂决策优化
核心特点:
不是直接告诉模型正确答案,而是通过奖励和惩罚让模型学会怎么行动。
3. 按模型 / 方法分类
另一种常见分类方式,是按照使用的模型来看。
传统机器学习
传统机器学习通常使用相对浅层的模型,并且比较依赖人工特征工程。
常见方法:
- 线性回归
- 逻辑回归
- 决策树
- SVM
- K-Means
- 随机森林
- XGBoost
线性回归
用于预测连续数值。
例如:
房屋面积
地段
楼层
   ↓
线性回归
   ↓
房价
核心思想:
用线性函数拟合输入和连续输出之间的关系。
逻辑回归
虽然名字叫“回归”,但主要用于分类。
通过 Sigmoid 将结果映射到 0~1:
x
 ↓
wx + b
 ↓
Sigmoid
 ↓
概率
例如:
- 是否点击
- 是否违约
- 是否垃圾邮件
决策树
通过一系列条件判断不断划分数据。
例如:
年龄 > 30?
├── 是 → 收入 > 1 万?
└── 否 → 是否有房?
适合:
- 分类
- 回归
特点:
可解释性强,容易理解成一组“如果……那么……”规则。
SVM
SVM 的核心是:
寻找一个能够最大化类别之间间隔的分类超平面。
例如:
● ● ●

      | ← 最大间隔 → |

○ ○ ○
核心概念:
- 超平面
- 支持向量
- 间隔
- 核函数
适合:
高维、小样本分类问题。
K-Means
一种经典的无监督聚类算法。
目标:
把数据划分成 K 个簇,使每个数据点尽可能接近自己所属簇的中心。
基本过程:
初始化 K 个中心
      ↓
样本分配给最近中心
      ↓
重新计算中心
      ↓
重复
常见应用:
- 用户分群
- 文档聚类
- 数据探索
- 图像压缩
4. 为什么从传统机器学习走向深度学习?
传统机器学习通常是:
原始数据
   ↓
人工设计特征
   ↓
机器学习模型
   ↓
预测结果
例如图像识别,可能需要人工设计:
- 边缘
- 纹理
- 形状
问题是:
复杂数据很难人工设计出足够好的特征。
深度学习改变了这个过程:
原始数据
   ↓
神经网络
   ↓
自动学习特征
   ↓
预测结果
于是进入深度学习。
三、深度学习
1. 什么是深度学习?
深度学习是机器学习的一个重要分支。
核心思想:
使用多层神经网络,让模型自动学习从底层特征到高层语义的表示。
传统机器学习:
人工特征
   ↓
模型
   ↓
结果
深度学习:
原始数据
   ↓
神经网络自动提取特征
   ↓
高层表示
   ↓
结果
因此深度学习特别适合:
- 图像
- 语音
- 文本
- 视频
- 多模态数据
2. 常见神经网络结构
MLP
MLP,全称 Multi-Layer Perceptron,多层感知机。
核心:
全连接神经网络。
输入
 ↓
全连接层
 ↓
隐藏层
 ↓
全连接层
 ↓
输出
适合:
- 表格数据
- 特征向量
- 分类
- 回归
它是很多神经网络结构的基础,但不会主动利用图像空间结构或者文本顺序。
CNN
CNN,全称 Convolutional Neural Network,卷积神经网络。
核心:
局部连接 + 权重共享。
通过卷积核提取局部特征:
边缘
 ↓
纹理
 ↓
局部形状
 ↓
物体部件
 ↓
完整物体
主要解决:
如何高效处理具有空间结构的数据?
典型场景:
- 图像分类
- 目标检测
- 图像分割
- 人脸识别
RNN
RNN,全称 Recurrent Neural Network。
核心:
通过隐藏状态,把前面的信息传递到后面。
x1 → h1
      ↓
x2 → h2
      ↓
x3 → h3
      ↓
x4 → h4
主要解决:
如何处理具有时间顺序的序列数据?
例如:
- 文本
- 语音
- 时间序列
但是普通 RNN 存在:
- 长距离依赖困难
- 梯度消失
- 梯度爆炸
- 难以并行
于是出现了 LSTM 和 GRU。
LSTM / GRU
LSTM 和 GRU 都是 RNN 的改进。
LSTM:
通过输入门、遗忘门、输出门以及 Cell State 控制信息流。
GRU:
进一步简化结构,通过更新门和重置门控制历史信息。
核心目的都是:
让 RNN 更好地保存长期信息,同时缓解梯度问题。
可以理解为:
RNN
 ↓
长期记忆能力不足
 ↓
LSTM / GRU
 ↓
能够更好处理长期依赖
3. 从 MLP、CNN、RNN 到 Transformer
整个演进可以简单理解成:
MLP
 ↓
只会处理一般特征
 ↓
CNN
 ↓
加入空间结构
 ↓
RNN
 ↓
加入时间 / 顺序信息
 ↓
LSTM / GRU
 ↓
改善长期依赖
 ↓
Transformer
 ↓
通过 Attention 直接建模全局关系
Transformer 的出现,解决了 RNN 很重要的一些问题:
- 顺序计算限制并行能力
- 长距离依赖困难
- 信息需要逐步传递
Transformer 通过 Attention:
让序列中的任意位置可以直接建立关系,同时能够进行大规模并行计算。
四、Transformer 与 Decoder-only
1. Transformer
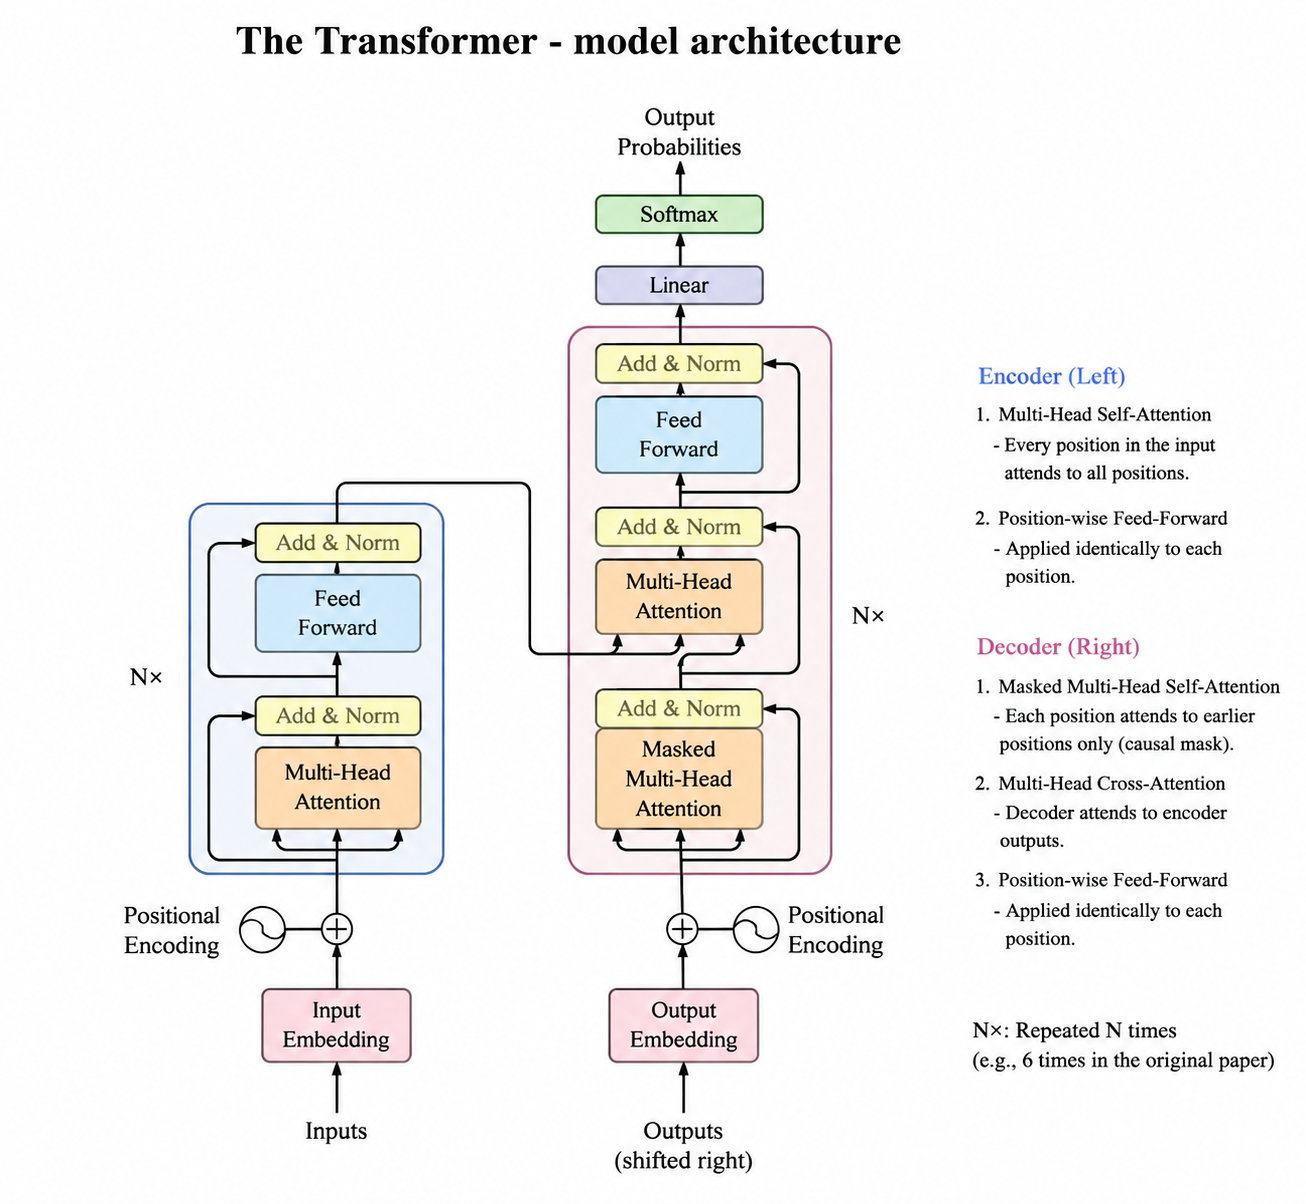
Transformer 是一种以 Self-Attention 为核心的神经网络架构。
它最核心的变化是:
不再依赖 RNN 一步一步传递信息,而是通过 Attention 直接计算不同 Token 之间的关系。
2017 年 Google 8位作者《Attention Is All You Need》 用 Self-Attention 为核心,摆脱 RNN/CNN 的序列建模方式 万恶之源 改变人类历史的一篇论文 让古法编程消失 用伟大两个字形容都苍白无力
例如:
我 喜欢 学习 人工智能

我   ←→ 喜欢
我   ←→ 人工智能
学习 ←→ 人工智能
每个 Token 都可以根据任务需要关注其他 Token。
Transformer 的核心组件包括:
- Self-Attention
- Multi-Head Attention
- Position Encoding / Position Embedding
- Feed Forward Network
- Residual Connection
- Layer Normalization
其中最核心的是 Self-Attention。
它可以回答:
“当前这个 Token 应该关注上下文中的哪些 Token,以及关注多少?”
2. Transformer 的三种架构
Transformer 后来形成了三种主要结构:
Encoder-only
只有 Encoder。
特点:
双向理解输入。
代表:
- BERT
- RoBERTa
- DeBERTa
常见场景:
- 文本分类
- NER
- 语义匹配
- Embedding
- 检索
Decoder-only
只有 Decoder。
特点:
使用 Causal / Masked Self-Attention,只看当前以及之前的 Token。
代表:
- GPT
- LLaMA
- Qwen
- DeepSeek
- Mistral
- Gemma
主要用于:
- 文本生成
- 对话
- 代码生成
- 推理
- Tool Calling
- Agent
Encoder-Decoder
同时使用 Encoder 和 Decoder。
输入
 ↓
Encoder
 ↓
理解输入
 ↓
Decoder
 ↓
生成输出
Decoder 可以通过 Cross-Attention 读取 Encoder 的表示。
代表:
- T5
- BART
- 原始 Transformer
适合:
- 翻译
- 摘要
- Seq2Seq
- 文本改写
3. 为什么 Decoder-only 成为 LLM 主流?
Decoder-only 的核心训练目标非常统一:
预测下一个 Token。
例如:
今天 天气 很
         ↓
       好
训练的时候:
今天 → 预测“天”
今天 天 → 预测“气”
今天 天气 → 预测“很”
今天 天气 很 → 预测“好”
因此可以使用海量互联网文本进行自监督训练。
整个过程不需要人工给每句话标注答案。
最终形成:
海量文本
   ↓
预测下一个 Token
   ↓
学习语言规律
   ↓
学习知识
   ↓
学习一定的推理与代码模式
   ↓
大语言模型 LLM
这就是现代 GPT、LLaMA、Qwen、DeepSeek 等模型的核心基础之一。
4. Decoder-only 的自回归生成
推理时,模型不是一次把整句话全部生成,而是:
输入:今天天气

        ↓

生成:很

        ↓

今天天气很

        ↓

生成:好

        ↓

今天天气很好

        ↓

生成:。
也就是:
根据已经出现的 Token,不断预测下一个 Token。
这就是自回归生成。
五、LLM 训练
LLM 的训练可以先理解成:
预训练
   ↓
获得基础模型
   ↓
后训练
   ↓
获得更符合人类使用方式的模型
1. 预训练
预训练的核心目标:
让模型通过海量数据学习通用语言能力、知识和模式。
Decoder-only 模型最经典的目标就是:
Next Token Prediction:预测下一个 Token。
例如:
人工智能正在改变
          ↓
        世界
训练过程中:
海量文本
 ↓
Tokenizer
 ↓
Token
 ↓
Transformer
 ↓
预测下一个 Token
 ↓
计算 Loss
 ↓
反向传播
 ↓
更新参数
预训练主要解决:
“让模型先学会语言和世界知识。”
2. 后训练
预训练完成后,模型虽然具备很强的语言能力,但不一定:
- 听得懂用户指令
- 按要求输出
- 遵循格式
- 符合人类偏好
- 安全地回答问题
因此需要后训练。
后训练主要包括:
SFT
 ↓
学习指令

偏好对齐
 ↓
学习什么样的回答更符合人类偏好
3. SFT
SFT,全称 Supervised Fine-Tuning,监督微调。
使用:
指令 + 高质量答案
训练模型。
{"instruction":"什么是Transformer?","output":"Transformer是一种以Self-Attention为核心的神经网络架构。"} {"instruction":"解释一下SVM","output":"SVM是一种通过最大化类别间隔来寻找分类超平面的机器学习算法。"}
例如:
User:
解释一下 Transformer。

Assistant:
Transformer 是一种……
它主要让模型学习:
- 如何理解指令
- 如何完成任务
- 如何按照要求回答
- 如何输出指定格式
所以:
SFT 解决的是“模型会不会按照人类要求做事”。
4. 偏好对齐:RLHF / PPO / DPO
SFT 后的模型已经会按照指令回答,但不同回答之间仍然存在质量差异。
例如:
回答 A:准确、简洁、有帮助

回答 B:啰嗦、错误、没有解决问题
偏好对齐希望模型:
更倾向于生成符合人类偏好的答案。
RLHF
RLHF:
Reinforcement Learning from Human Feedback
{ "prompt": "解释一下Transformer", "chosen": "Transformer是一种以Self-Attention为核心的架构……", "rejected": "Transformer就是一种神经网络……" }
或者
{ "prompt": "解释一下Transformer", "responses": [ "回答A……", "回答B……", "回答C……" ], "ranking": [2, 1, 3] }
经典流程:
人工偏好数据
     ↓
训练 Reward Model
     ↓
模型生成回答
     ↓
Reward Model 打分
     ↓
强化学习优化模型
PPO
PPO 是强化学习中的一种策略优化算法。
在经典 RLHF 中,可以使用 PPO:
                 ┌──────────────────────┐
                 │                      ↓
Prompt → LLM生成回答 → Reward Model打分 → Reward
   ↑                                      │
   │                                      ↓
   └──────────── PPO根据奖励更新LLM ───────┘
DPO
DPO:
Direct Preference Optimization
{ "prompt": "什么是Transformer?", "chosen": "Transformer是一种以Self-Attention为核心的神经网络架构,可以更好地建模序列中不同Token之间的关系。", "rejected": "Transformer就是一种神经网络,用来处理数据。" }
或
{ "prompt": [ { "role": "user", "content": "如何解释Transformer?" } ], "chosen": [ { "role": "assistant", "content": "Transformer是一种以Self-Attention为核心的神经网络架构。" } ], "rejected": [ { "role": "assistant", "content": "Transformer是一种普通的神经网络。" } ] }
直接利用偏好数据:
Prompt
 ├── chosen:更好的回答
 └── rejected:较差的回答
直接优化模型,让模型:
提高 preferred answer 的概率,降低 rejected answer 的概率。
相比经典 RLHF + PPO,DPO 流程更加直接。
5. 参数更新:全参数训练 / PEFT / LoRA / QLoRA
这里要特别注意:
SFT、DPO 是训练目标 / 方法;LoRA、QLoRA 是参数更新方式。
它们不是同一层面的分类。
全参数训练
更新模型全部参数:
Model
 ↓
所有参数都参与训练
优点:
- 模型调整能力强
缺点:
- 显存和计算成本高
- 训练成本高
PEFT
PEFT:
Parameter-Efficient Fine-Tuning
核心思想:
冻结大部分原始模型参数,只训练少量新增参数。
常见方法:
- LoRA
- QLoRA
LoRA
LoRA 不直接更新原始大矩阵,而是学习一个低秩增量:
W' = W + ΔW

ΔW = BA
其中:
W:原始参数ΔW:需要学习的参数B、A:低秩矩阵
这样可以大幅减少需要训练的参数量。
QLoRA
QLoRA 在 LoRA 的基础上进一步对基础模型进行量化。
可以简单理解为:
模型量化
   +
LoRA
主要目的是进一步降低显存需求,让较大模型能够在有限 GPU 资源上进行微调。
简单说:假设原模型权重是:
W = [1.2, 0.3, -0.7, 2.1] (Float Point 16)
LoRA:冻结 W,只训练一个小的 ΔW,最终 W + ΔW。
QLoRA:先把 W 从 FP16 量化成 4-bit,例如 [10, 5, 0, 15],冻结它;然后仍然只训练 LoRA 的 ΔW。
所以:QLoRA =更少bit 量化的基座模型 + LoRA。
6. 整个 LLM 训练链路
因此可以把训练整体记成:
                    LLM 训练
                       │
          ┌────────────┴────────────┐
          ↓                         ↓
        预训练                    后训练
          │                         │
          │              ┌──────────┴──────────┐
          │              ↓                     ↓
          │             SFT                  偏好对齐
          │                                    │
          │                              ┌─────┴─────┐
          │                              ↓           ↓
          │                             DPO       RLHF/PPO
          │
          └───────────────┬──────────────────────
                          ↓
                   参数更新方式
                    ┌─────┴─────┐
                    ↓           ↓
                  全参数       PEFT
                                │
                           ┌────┴────┐
                           ↓         ↓
                         LoRA      QLoRA
这里最重要的是记住:
预训练 / SFT / DPO / RLHF 是“训练什么”;全参数 / LoRA / QLoRA 是“怎么更新参数”。
六、LLM 推理
训练完成以后,模型参数基本固定。
用户真正使用模型时进入的是:
推理阶段。
整体流程:
用户 Prompt
    ↓
Tokenizer
    ↓
Prefill
    ↓
KV Cache
    ↓
Decode
    ↓
Detokenizer
    ↓
最终文本
1. Prefill
Prefill 可以理解为:
先把用户输入的整个 Prompt 读一遍。
例如:
请解释一下 Transformer 的工作原理
整个 Prompt 的 Token 会一次性进入模型。
这一阶段主要完成:
- 处理输入 Token
- 计算 Attention
- 生成 KV Cache
- 得到下一 Token 的预测结果
因为输入 Token 可以并行处理,所以 Prefill 的计算并行度较高。
2. KV Cache
Decode 阶段如果每次都重新计算历史 Token,会非常浪费。
因此模型会把历史 Token 的:
- Key
- Value
保存下来。
这就是:
KV Cache。
例如:
第一次:
A B C → 计算 K/V → 缓存

第二次生成 D:
复用 A B C 的 K/V
只处理新的部分
核心价值:
避免 Decode 阶段重复计算历史 Token。
代价:
需要占用 GPU 显存,而且上下文越长,KV Cache 通常越大。
3. Decode
Decode 阶段就是:
一个 Token 一个 Token 地生成答案。
例如:
Prompt:
今天天气

↓ Decode

很

↓ Decode

好

↓ Decode

。
每生成一个 Token,就把它加入上下文,然后继续预测下一个 Token。
常见生成策略:
- Greedy
- Temperature
- Top-K
- Top-P
- Beam Search
4. Prefill 和 Decode 的区别
| Prefill | Decode | |
|---|---|---|
| 输入 | 完整 Prompt | 已生成序列 |
| 处理方式 | 批量并行 | 逐 Token |
| 主要任务 | 处理上下文 | 生成答案 |
| KV Cache | 建立 | 持续复用和追加 |
| 典型瓶颈 | 计算 | 显存带宽 / 单 Token 延迟 |
可以记成:
Prefill:
“先把问题读完”

KV Cache:
“把读过的信息缓存起来”

Decode:
“利用缓存,一个 Token 一个 Token 地回答”
七、从 LLM 到 Agent
到这里,我们已经走完了:
传统算法
   ↓
机器学习
   ↓
深度学习
   ↓
Transformer
   ↓
Decoder-only
   ↓
LLM
   ↓
训练
   ↓
推理
但是一个普通 LLM 仍然主要是在:
根据上下文预测和生成 Token。
它本身并不知道:
- 当前公司数据库里有什么数据
- 用户订单是什么状态
- 今天的天气是什么
- 如何调用企业内部 API
- 如何操作浏览器
- 如何执行一个复杂业务流程
于是就产生了 Agent。
1. Agent 是什么?
可以简单理解:
Agent = LLM + 工具 + 状态 / 记忆 + 环境交互 + 决策执行。
普通 LLM:
Prompt
 ↓
LLM
 ↓
Answer
Agent:
User
 ↓
LLM
 ↓
理解任务
 ↓
判断下一步行动
 ↓
调用 Tool
 ↓
获得结果
 ↓
继续思考
 ↓
再次调用 Tool
 ↓
最终回答
因此 Agent 的核心变化是:
从“生成文本”走向“感知 → 决策 → 行动 → 观察 → 再决策”。
2. Agent 为什么需要这些能力?
Tool Calling
解决:
让 LLM 能够调用外部能力。
例如:
LLM
 ↓
调用天气 API
 ↓
获得天气
 ↓
生成回答
RAG
解决:
让模型访问外部知识,而不是只依赖参数中已经学到的知识。
用户问题
 ↓
检索知识库
 ↓
相关文档
 ↓
Prompt
 ↓
LLM
 ↓
回答
Memory
解决:
让 Agent 能够保存和利用历史信息。
例如:
第一次:
“我叫小福”

↓

第二次:
“我叫什么?”

↓

Agent Memory
↓

“小福”
MCP
解决:
以标准化协议连接模型与外部 Tool / Resource / Prompt 等能力。
可以理解成:
Agent / LLM
     ↓
    MCP
     ↓
┌────┼────┐
↓    ↓    ↓
Tool Resource Prompt
↓
外部系统
这样 Agent 就不需要针对每一个外部系统都重新设计一套连接方式。
八、整条技术链路
最终可以把整个知识体系压缩成这一张图:
                    Agent 工程师算法知识链路
                              │
                              ↓
                         传统算法
                              │
              ┌───────────────┼───────────────┐
              ↓               ↓               ↓
             搜索            图算法           排序
              ↓               ↓               ↓
             动态规划         贪心            优化
                              │
                              ↓
                         机器学习
                              │
              ┌───────────────┴───────────────┐
              ↓                               ↓
          学习方式                         模型方法
              │                               │
     ┌────────┼────────┐              ┌──────┴──────┐
     ↓        ↓        ↓              ↓             ↓
   监督     无监督   强化学习       传统机器学习   深度学习
     │        │                       │             │
     └────────┴───────┐               │             │
                      ↓               │             ↓
                  数据驱动学习         │           MLP
                                      │             ↓
                        线性回归/决策树/SVM      CNN
                        K-Means/XGBoost            ↓
                                                   RNN
                                                   ↓
                                               LSTM / GRU
                                                   ↓
                                              Transformer
                                                   │
                              ┌────────────────────┼──────────────────┐
                              ↓                    ↓                  ↓
                        Encoder-only         Decoder-only      Encoder-Decoder
                                                   │
                                                   ↓
                                                 LLM
                                                   │
                                      ┌────────────┴────────────┐
                                      ↓                         ↓
                                    训练                       推理
                                      │                         │
                           ┌──────────┴──────────┐              │
                           ↓                     ↓              │
                         预训练                 后训练           │
                                                 │              │
                                      ┌──────────┴──────────┐   │
                                      ↓                     ↓   │
                                     SFT                 偏好对齐 │
                                                            │   │
                                                    DPO / RLHF   │
                                                         │      │
                                              全参数 / PEFT      │
                                                   │             │
                                             LoRA / QLoRA        │
                                                                 │
                                                   Prefill       │
                                                       ↓        │
                                                   KV Cache      │
                                                       ↓        │
                                                    Decode       │
                                                       │        │
                                                       └────────┘
                                                          ↓
                                                        Agent
                                                          │
                         ┌────────────────────────────────┼────────────────────┐
                         ↓                ↓               ↓                    ↓
                     Tool Calling        RAG           Memory                 MCP
                         ↓                ↓               ↓                    ↓
                       行动            知识获取        历史状态            外部能力接入
最后,用一句话理解整个演进
其实你这个视频真正要讲的,不是“把所有算法讲一遍”,而是讲清楚为什么今天的 Agent 会长成这个样子:
传统算法
人写规则
   ↓
机器学习
机器从数据学习规律
   ↓
深度学习
机器自动学习特征表示
   ↓
Transformer
通过 Attention 建模全局关系
   ↓
Decoder-only
统一为下一个 Token 预测
   ↓
LLM
通过预训练获得通用语言能力
   ↓
后训练
学会遵循指令、符合人类偏好
   ↓
LLM 推理
Prefill + KV Cache + Decode
   ↓
Agent
让 LLM 进一步获得
Tool / RAG / Memory / MCP 等外部能力
   ↓
从“会生成”
走向“会思考、会调用、会执行”
这条链路才是你这个 MD 最核心的主线。
这样整理以后,前面的传统算法、机器学习、CNN/RNN、SVM 等虽然都讲到了定义和作用,但不会抢走 Transformer、Decoder-only、训练、推理和 Agent 的篇幅。后半部分自然成为重点,也更符合你这个视频真正面向的 Agent 工程师视角。