Agent 评测体系
一、体系架构
Agent 评测 = 三层分类(评什么) × 一条流程(怎么评)

三层分类:① 端到端 → ② 轨迹 → ③ 表现
一条流程:① 定数据集 → ② 定标准 → ③ 跑测试 → ④ 看指标归因 → ⑤ 持续迭代
和 RAG 评测的关系:RAG 评测评的是"一问一答",Agent 评测评的是"一条多步执行的轨迹"。所以 Agent 评测要回答三个问题——做成了没、怎么做的、代价多大,对应三层分类;而不管评哪一层,流程都是同一条五步。
三层分类和流程是正交的:任何一次具体评测,都落在"某一层 × 某一步"的交叉点上。
二、详解
2.1 三层分类(评什么)
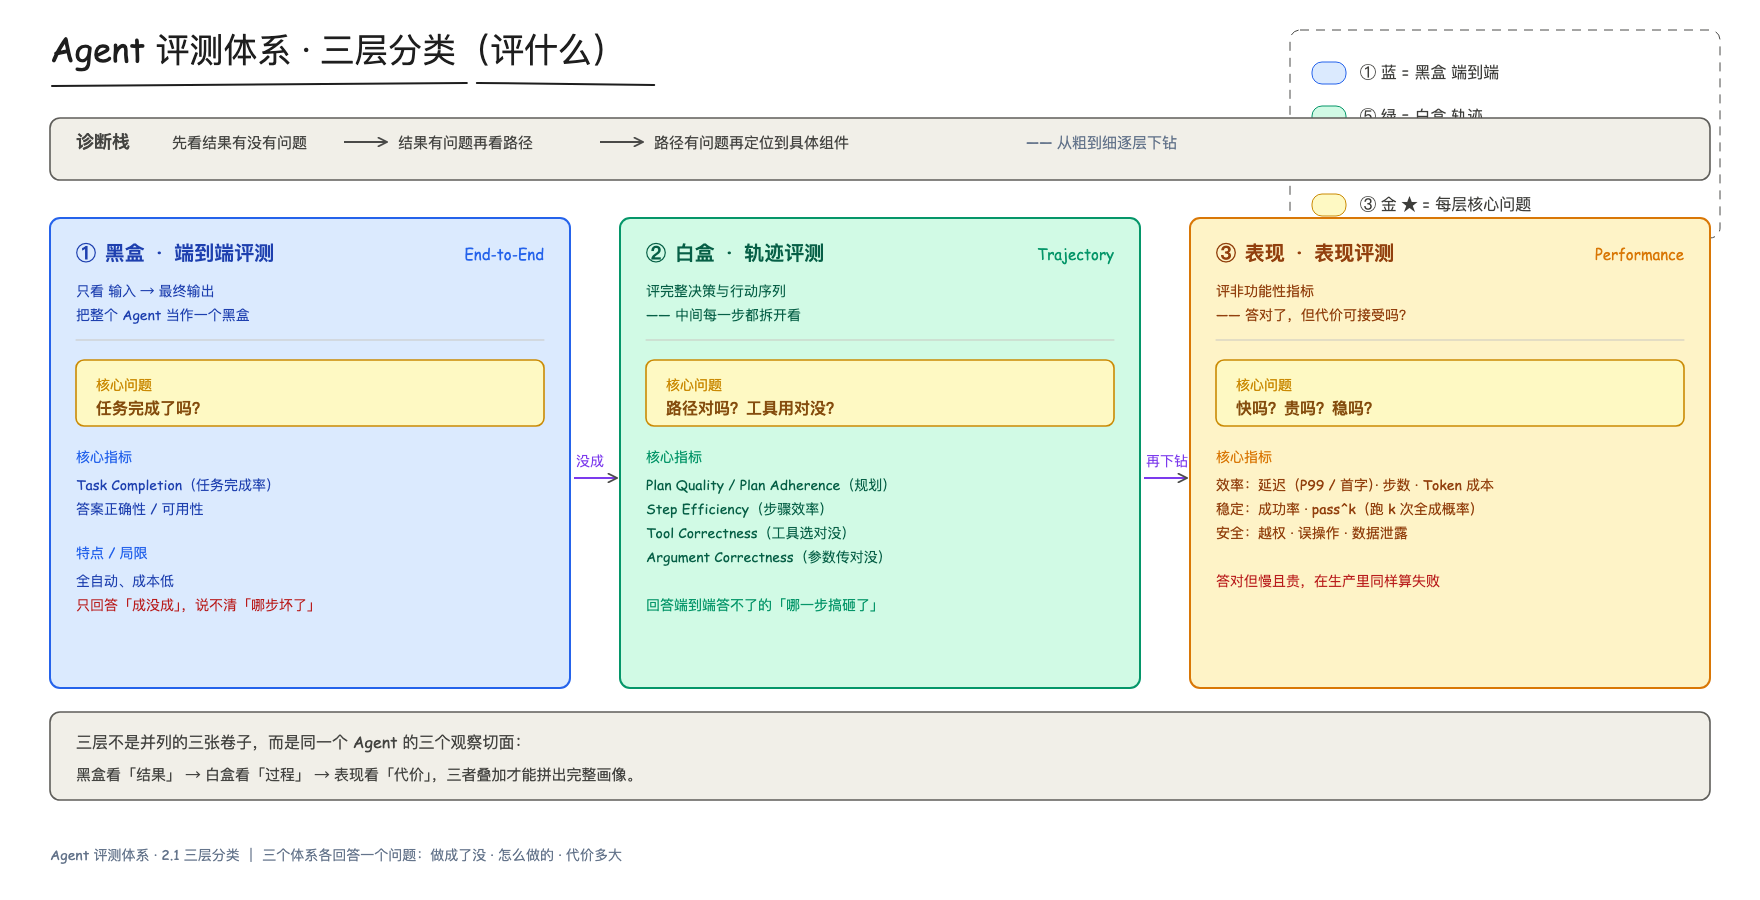
| 层 | 官方术语 | 评什么 | 核心问题 |
|---|---|---|---|
| ① | 端到端评测(End-to-End) | 最终结果 | 任务完成了吗 |
| ② | 轨迹评测(Trajectory) | 执行过程 | 路径对吗、工具用对没 |
| ③ | 表现评测(Performance) | 运行时指标 | 快吗、贵吗、稳吗 |
三层不是并列的三张卷子,而是一个诊断栈:先看结果有没有问题 → 结果有问题再看路径 → 路径有问题再定位到具体组件。
2.1.1 端到端评测
- 是什么:把整个 Agent 当黑盒,只看输入 → 最终输出。
- 核心指标:Task Completion(任务完成率)、答案正确性 / 可用性。
- 特点:全自动、成本低;只回答"成没成",不回答"为什么"。
- 局限:完成率从 68% 掉到 55%,它能拉响警报,但说不清哪一步坏了。
- 典型做法:给 Agent 一个任务,跑完看终态对不对(如 τ-bench 比对会话结束时的数据库状态与目标状态)。
2.1.2 轨迹评测
- 是什么:评 Agent 的完整决策与行动序列——中间每一步。
- 为什么需要:端到端只知道"没做成",轨迹才能回答"哪一步搞砸了"。
- 评三个方面:
| 维度 | 指标 | 含义 |
|---|---|---|
| 规划 | Plan Quality / Plan Adherence | 计划合理吗 / 按计划走了吗 |
| 步骤 | Step Efficiency | 有没有绕路、无效步骤 |
| 工具调用 | Tool Correctness | 工具选对没 |
| Argument Correctness | 参数传对没 |
- 注意区分:
trace是采集到的执行记录,trajectory是 trace 里那串有序动作序列(评测的对象)。
2.1.3 表现评测
- 是什么:评非功能性指标——回答"答对了,但代价可接受吗"。
- 三类:
- 效率:延迟(P99 / 首字)、步数、Token 成本
- 稳定:成功率、pass^k(同一任务跑 k 次全成功的概率)
- 安全:越权、误操作、数据泄露
- 原则:答对但慢且贵,在生产里同样算失败。
2.2 生产里看哪几个指标(重点)
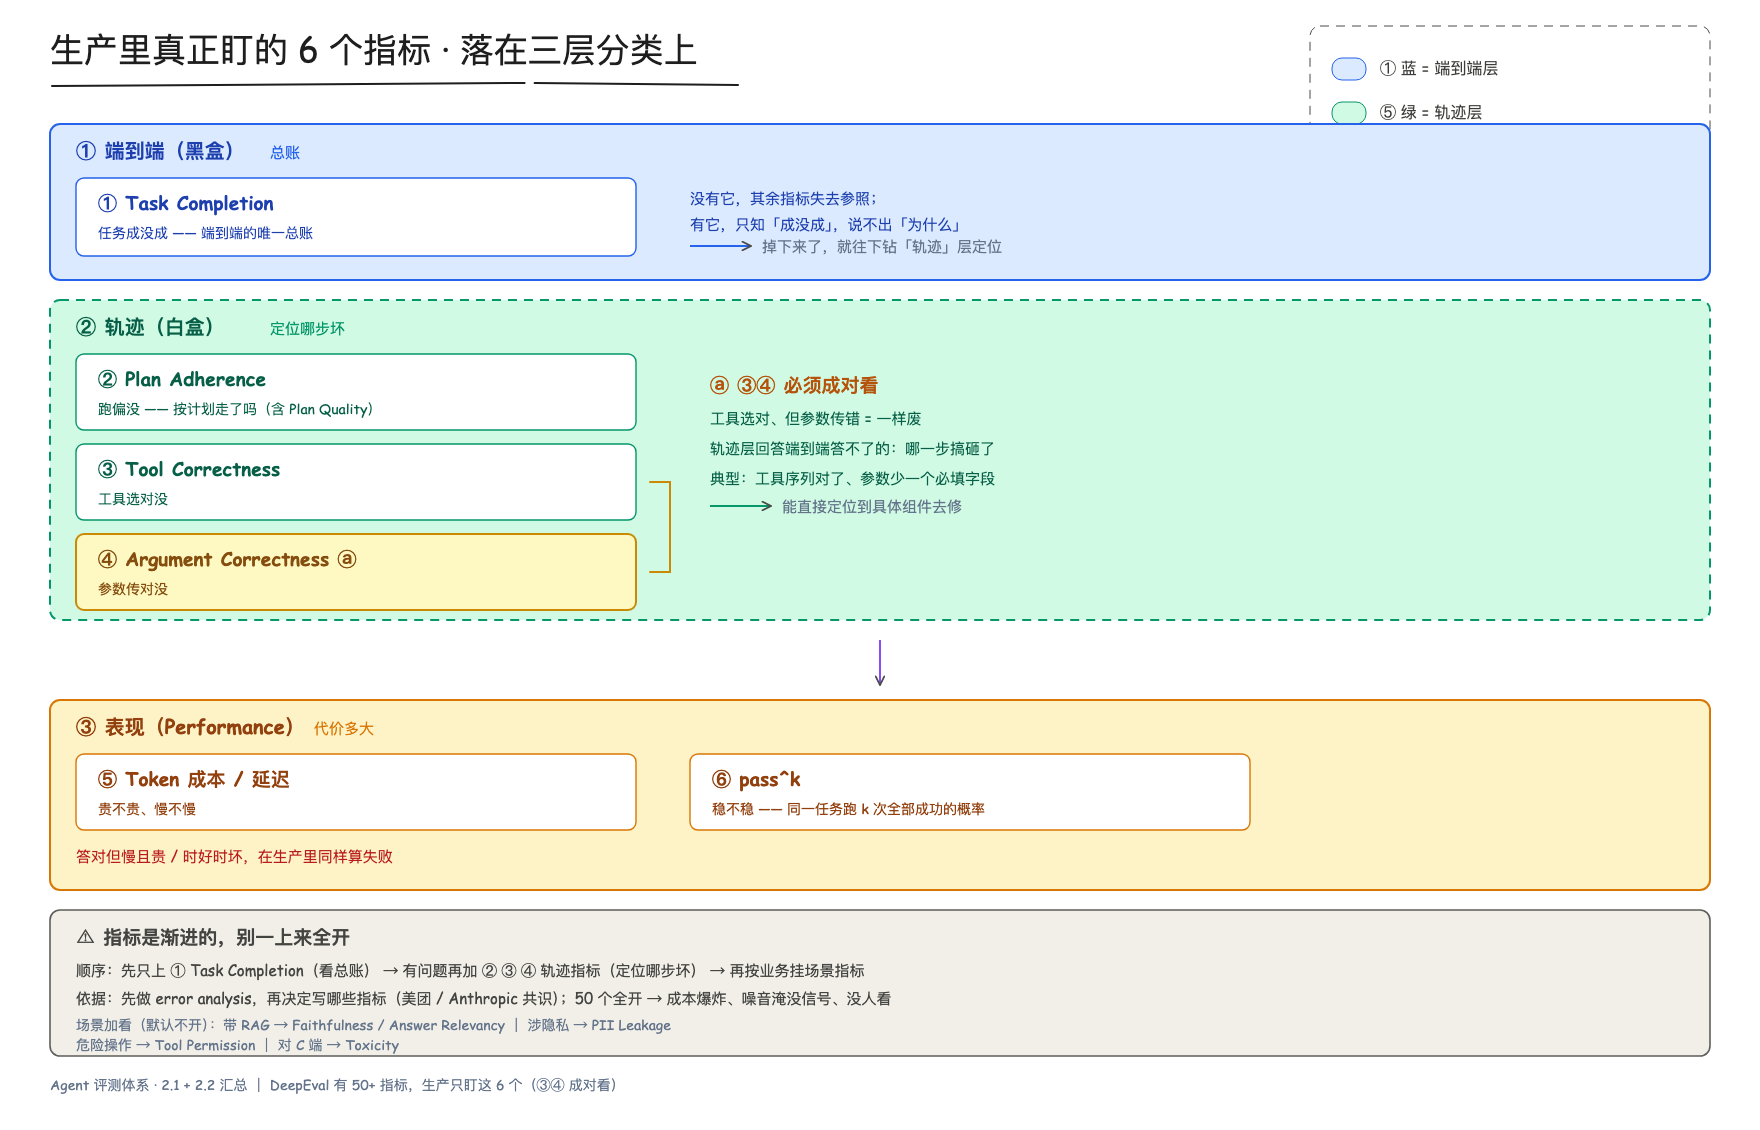
DeepEval 有 50+ 指标,但生产不是全看。实际盯的就 6 个:
| # | 指标 | 层 | 看什么 |
|---|---|---|---|
| ① | Task Completion | 端到端 | 总账——任务成没成 |
| ② | Plan Adherence(含 Plan Quality) | 轨迹 | 跑偏没——按计划走了吗 |
| ③ | Tool Correctness | 轨迹 | 工具选对没 |
| ④ | Argument Correctness | 轨迹 | 参数传对没 ✳️ |
| ⑤ | Token 成本 / 延迟 | 表现 | 贵不贵、慢不慢 |
| ⑥ | pass^k | 表现 | 稳不稳——同任务跑 k 次全成的概率 |
✳️ ③④ 必须成对看:工具选对但参数传错 = 一样废。
场景加看(默认不开):
| 触发条件 | 加看 |
|---|---|
| 带 RAG | Faithfulness、Answer Relevancy |
| 涉用户隐私 | PII Leakage |
| 有危险操作(转账/删库) | Tool Permission、Misuse |
| 对 C 端 | Toxicity、Bias |
⚠️ 核心原则:指标是渐进的,别一上来全开。
- 顺序:先只上 Task Completion(看总账)→ 有问题再加轨迹指标(定位哪步坏)→ 再按业务挂场景指标。
- 依据:先做 error analysis,再决定写哪些指标(美团/Anthropic 共识)。
- 反例:50 个指标全开 → 成本爆炸、噪音淹没信号、没人看。
2.3 一条流程(怎么评)
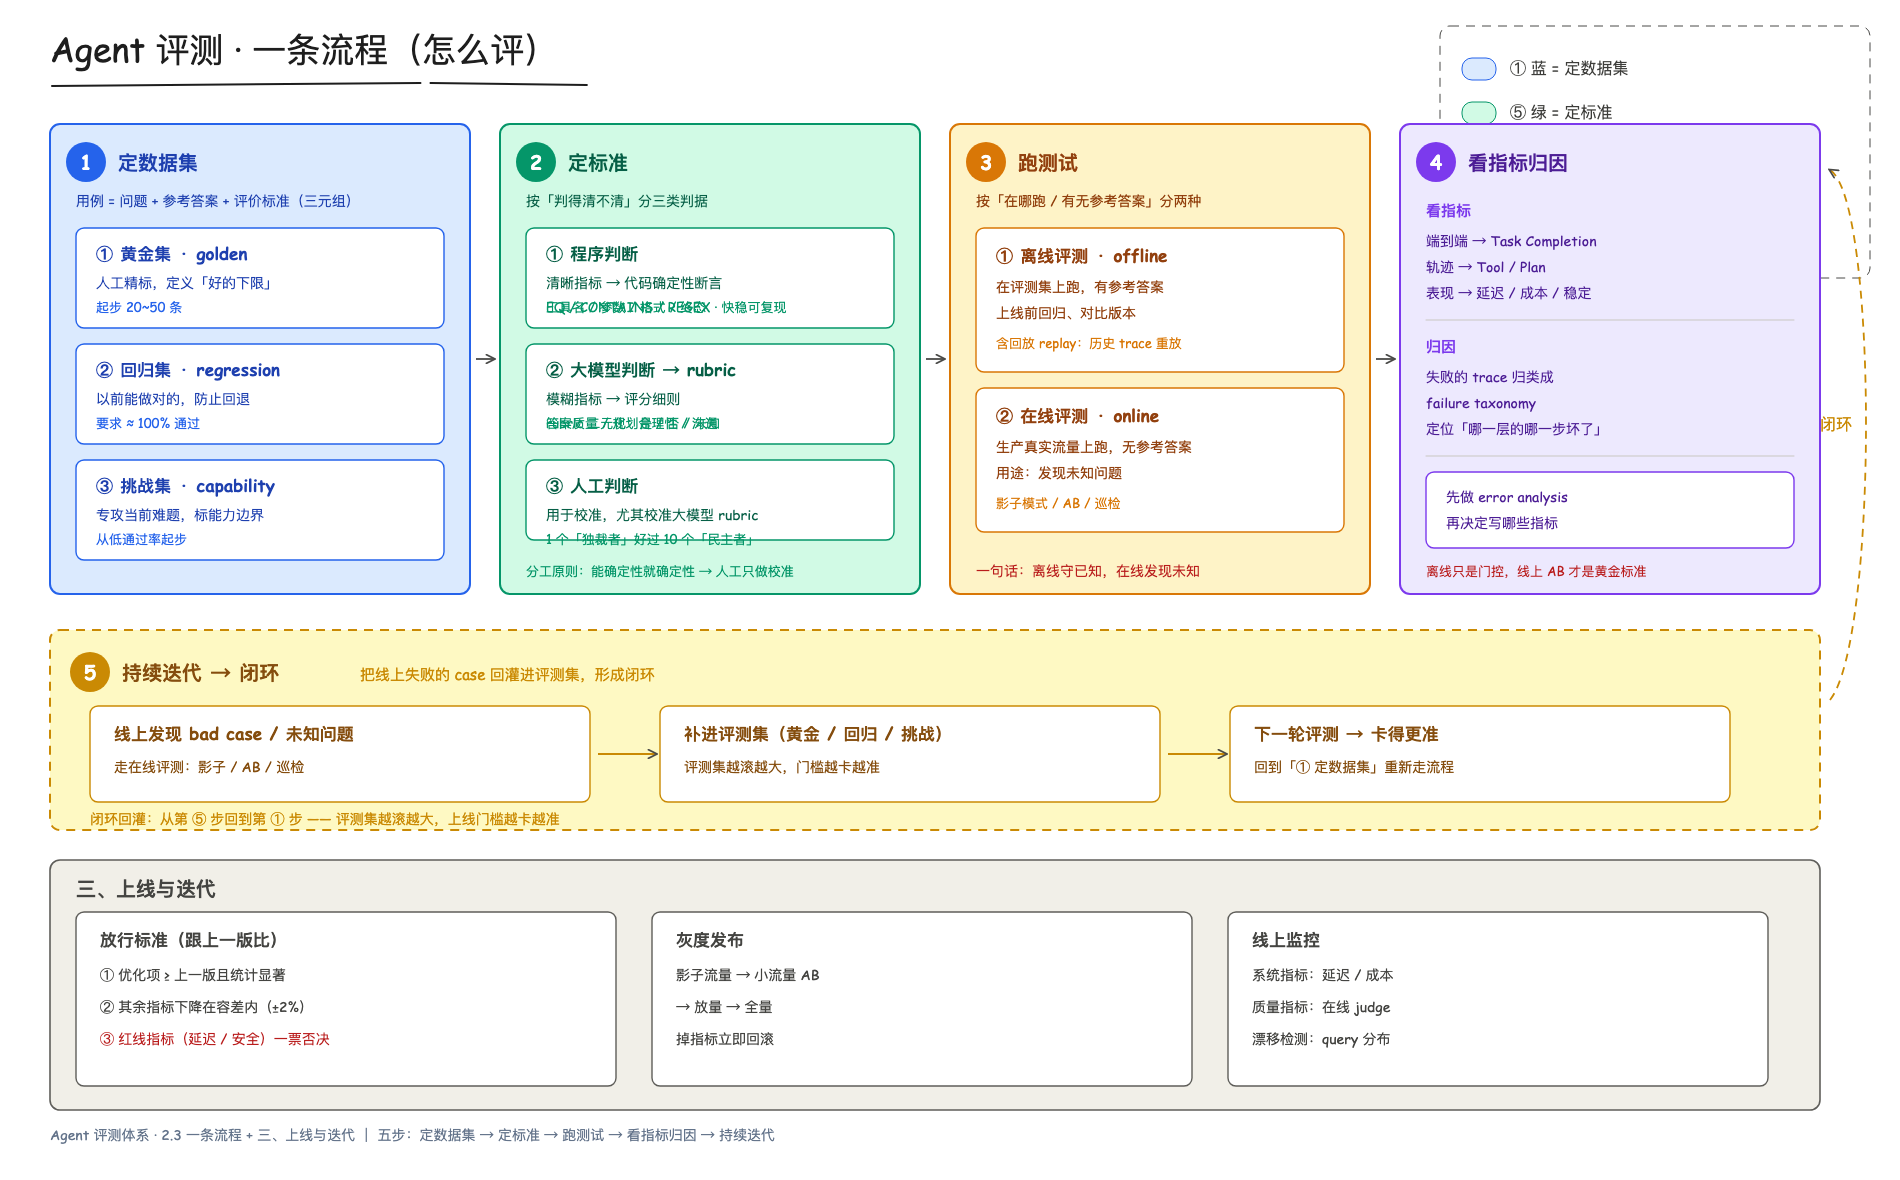
不管评哪一层,流程都是同一条:
① 定数据集 → ② 定标准 → ③ 跑测试 → ④ 看指标归因 → ⑤ 持续迭代
① 定数据集
一个用例 = 三元组:问题 + 参考答案 + 评价标准。
按用途分三类:
| 类型 | 英文 | 作用 | 通过率 |
|---|---|---|---|
| 黄金集 | golden set | 人工精标,定义"好的下限" | 起步 20~50 条 |
| 回归集 | regression set | 以前能做对的,防止回退 | 要求 ≈100% |
| 挑战集 | capability set | 专攻当前难题,标定能力边界 | 从低起步 |
② 定标准
标准按"判得清不清"分三类,对应三种判据:
| 判据 | 适用 | 怎么判 | 特点 |
|---|---|---|---|
| 程序判断 | 清晰的指标(工具名、参数、格式、终态状态) | 代码确定性断言(EQ / CONTAINS / REGEX) | 快、稳、可复现 |
| 大模型判断 | 模糊的指标(答案质量、规划合理性、沟通质量) | rubric(评分细则,尽量二元化:是/否/未知) | 懂语义,但需与人工校准 |
| 人工判断 | 需要校准时 | 人评结构化打分 | 金标准,贵、慢 |
分工原则:能确定性就确定性——清晰的就用程序,模糊的才上 rubric,人工用来校准。
① 程序判断(清晰指标)
- 判什么:工具名 / 参数 / 格式 / 环境终态。
- 例:
ToolCorrectness→ 实际工具序列 == 期望序列(== 1.0 通过)。
② 大模型判断(模糊指标 → rubric)
- 判什么:无唯一正确答案的质量维度。
- 关键:rubric 二元化 —— 把模糊概念拆成一组"是 / 否 / 未知"的具体检查项。
- 例:
AnswerCorrectness→ rubric(0-2 错 / 3-6 大体对 / 7-9 漏细节 / 10 全对)→ 阈值 ≥ 7。 - 前提:人机一致率达标(机器评测与人工评测一致),否则只能算"机器标注",不算自动化评测。
③ 人工判断
- 用途:校准前面两者,尤其校准大模型 rubric。
- 原则:1 个"独裁者"好过 10 个"民主者"——统一口径,由一个人拍板。
③ 跑测试
按"在哪跑、有没有参考答案"分两种:
| 场景 | 在哪跑 | 有参考答案吗 | 用途 |
|---|---|---|---|
| 离线评测(offline) | 评测集上 | 有(reference-based) | 上线前回归、对比版本 |
| 在线评测(online) | 生产真实流量 | 无(reference-free) | 发现未知问题 |
- 离线的实现:跑评测集(含回放 replay —— 用历史 trace 重放验证新版本)。
- 在线的实现:影子模式(上线前用真实流量兜底)、AB(上线后确认业务价值)、巡检(日常盯基本盘)。
一句话:离线守已知,在线发现未知。
④ 看指标归因
- 看指标:端到端看 Task Completion,轨迹看 Tool Correctness / Plan Adherence,表现看延迟 / 成本 / 稳定/安全。
- 归因:把失败的 trace 归类成 failure taxonomy,定位"哪一层的哪一步坏了"。
- 原则:先做 error analysis,再决定写哪些指标。
- 关键认知:离线只是门控,线上 AB 看业务指标才是黄金标准。
⑤ 持续迭代
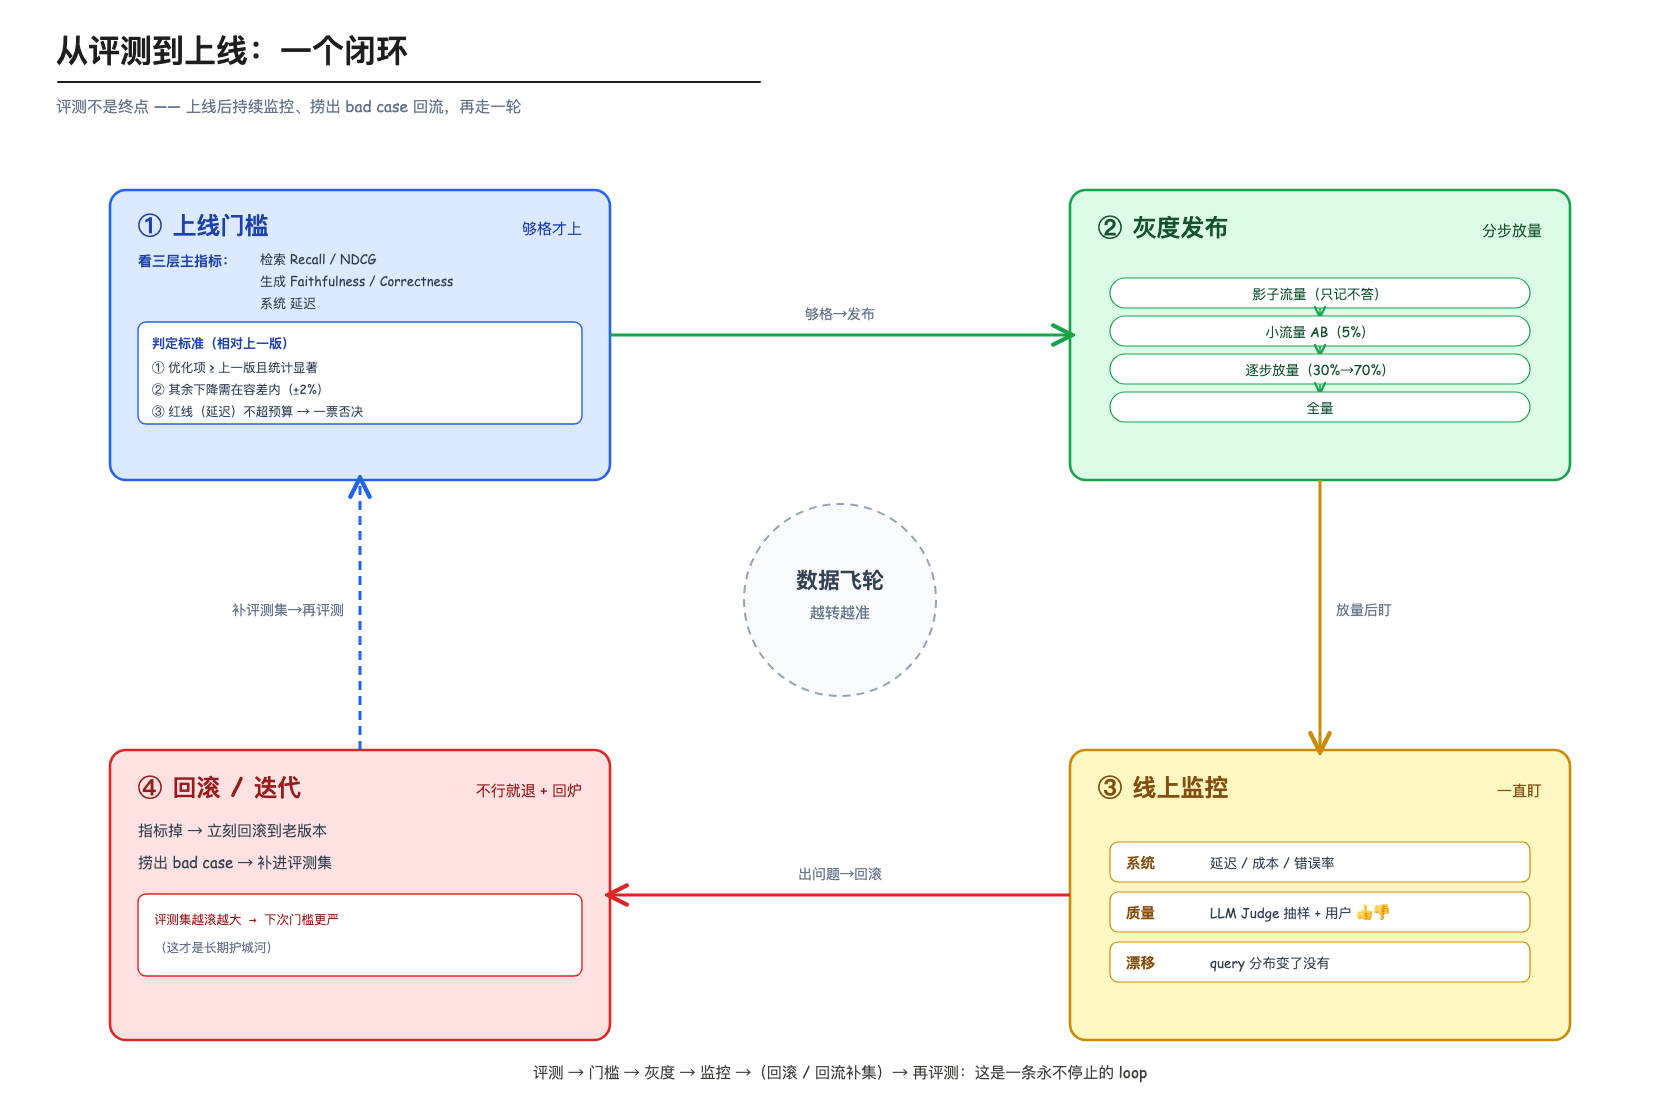
把线上失败的 case 回灌进评测集,形成闭环——评测集越滚越大,门槛越卡越准。
三、上线与迭代
流程跑通后,评测要接进研发流程才有约束力。
放行标准(跟上一版比):
- ① 优化项 ≥ 上一版,且统计显著
- ② 其余指标下降需在容差内(如 ±2%)
- ③ 红线指标(延迟、安全)不超预算 → 一票否决
灰度发布:影子流量 → 小流量 AB → 放量 → 全量。
线上监控:系统指标(延迟 / 成本)、质量指标(在线 judge)、漂移检测(query 分布)。
回滚 / 迭代:掉指标立即回滚;bad case 回流补评测集,形成闭环。