DeepAgent:从普通 Agent 到复杂任务执行框架
名称说明:LangChain 官方名称为 Deep Agents;本文为保持前后一致,正文统一写作 DeepAgent。
第一章 什么是 DeepAgent?
在介绍 DeepAgent 之前,我们先从 LangGraph 和 LangChain 讲起。
这三个东西都来自 LangChain 生态,但它们解决的问题不完全一样。我们可以把它们理解为:从底层流程编排,到通用大模型应用开发,再到开箱即用的复杂 Agent 构建,抽象层次逐步提高,封装也越来越多。
1.1 LangGraph:解决 Agent 的流程编排问题
首先是 LangGraph。
我们知道,大模型本身主要负责理解和生成内容。但如果要让它真正完成复杂任务,通常需要让模型调用工具、接收工具结果、判断下一步做什么,甚至循环执行多轮操作。
例如,我们要构建一个故障排查 Agent:
用户提出故障
    ↓
分析问题
    ↓
查询系统日志
    ↓
判断是否找到原因
    ├── 是 → 生成排查报告
    └── 否 → 查询监控指标
                 ↓
              继续分析
这里就不再是简单的一次模型调用,而是涉及多个步骤之间的状态传递、条件分支、循环执行,以及必要时的中断和恢复。
如果我们完全自己实现,就需要编写大量代码来维护执行状态、控制流程,并处理每一步的执行结果。
LangGraph 的核心作用,就是提供一套面向状态和图结构的流程编排机制。
我们可以将任务拆分成不同的节点,通过边连接节点,再利用条件边决定下一步执行什么。与此同时,LangGraph 还提供了状态管理、检查点持久化,以及中断和恢复等能力。
所以,什么时候使用 LangGraph?
当我们需要精确控制 Agent 的执行流程时,例如:
- 有明确的业务步骤和条件分支。
- 需要循环执行,直到满足某个条件。
- 需要人工审核、暂停和恢复。
- 需要保存执行状态,实现长流程任务的断点恢复。
这些场景都适合使用 LangGraph。
当然,LangGraph 并不局限于固定流程,它同样可以编排具有动态决策能力的 Agent。它的特点是让开发者能够显式地控制和组织执行过程。
1.2 LangChain:解决大模型应用开发问题
接下来是 LangChain。
如果说 LangGraph 更关注任务怎么执行,那么 LangChain 进一步关注的是:如何方便地构建大模型应用。
例如,我们要开发一个企业知识问答系统,可能需要完成以下工作:
用户问题
    ↓
构造 Prompt
    ↓
调用大模型
    ↓
解析模型输出
    ↓
返回结果
如果还要加入企业知识库,就需要对接文档加载、文本切分、向量检索和模型生成等组件。
如果还要让模型调用外部工具,就需要处理模型的工具调用请求、执行工具,并将结果交还给模型。
LangChain 将这些常见能力封装成了可以组合使用的组件,例如模型接口、Prompt 模板、输出解析器、Retriever 和 Tool 等。
开发者不必每次都从零实现这些通用能力,而是可以根据业务需要进行组合。
那么,什么时候使用 LangChain?
当我们需要快速构建大模型应用,并灵活组合模型、提示词、检索和工具等组件时,LangChain 就很适合。
例如:
- 普通知识问答应用。
- RAG 检索增强生成系统。
- 文本分类、信息抽取和内容生成。
- 需要组合多个模型与工具的 LLM 应用。
这里需要注意,LangChain 本身也能构建 Agent,并不只是用于简单的模型调用。只是当应用涉及复杂的流程控制时,可以结合 LangGraph 来实现更精细的编排。
1.3 DeepAgent:进一步封装复杂 Agent 的工程机制
最后,我们来看今天的主角——DeepAgent。
前面我们已经有了 LangChain,可以调用模型、使用工具;也有了 LangGraph,可以组织执行流程。
但当我们真正构建一个需要持续工作、能够自主完成复杂任务的 Agent 时,还会遇到另一类问题。
例如,用户提出一个复杂的需求:
“帮我分析线上订单服务的响应延迟,查找可能的原因,检查相关发布记录,最后生成一份排查报告。”
这个任务可能需要 Agent 自己规划步骤、连续调用多个工具、保存中间结果,必要时把不同子任务交给不同的 Agent,并在执行过程中管理不断增长的对话上下文。
如果只使用基础模型调用和工具调用,我们仍然需要自行设计和实现这些机制。
DeepAgent 的定位,就是在 LangChain 等基础能力之上,进一步封装构建复杂 Agent 时经常需要的工程机制。
它提供了一组开箱即用的 Middleware,例如:
- To-Do List:将复杂任务拆解成多个步骤,并跟踪执行进度。
- File System:通过文件读写保存中间结果,避免所有内容都堆积在对话上下文中。
- Sub-Agent:将适合独立执行的子任务委派给专门的 Agent。
- Summarization:在对话历史不断增长时,对上下文进行摘要和管理。
这些机制并不是说基础的 LangChain 或 LangGraph 无法实现,而是 DeepAgent 将其中一些常见的复杂 Agent 能力进一步封装起来,减少开发者重复造轮子的工作。
那么,什么时候使用 DeepAgent?
当我们需要构建一个能够自主规划、持续执行、管理中间产物,并且能够根据任务需要委派子任务的复杂 Agent 时,就可以考虑 DeepAgent。
例如:
- 需要连续调用多个工具的研究型 Agent。
- 需要读取大量文档、分析代码或排查问题的 Agent。
- 需要拆分任务并委派给多个子 Agent 的系统。
- 执行过程较长,需要管理上下文和中间结果的 Agent。
不过,DeepAgent 并不意味着一定要使用多 Agent,也不意味着任务越复杂就一定越应该使用它。如果任务本身很简单,直接使用 LangChain 就足够了;如果业务要求严格控制每一步的执行路径,使用 LangGraph 编排也可能更合适。
1.4 三者定位对比
我们可以用一句话概括:
| 框架 | 核心关注点 | 适合解决的问题 |
|---|---|---|
| LangGraph | 流程编排与状态管理 | 任务按什么流程执行,如何分支、循环、中断和恢复 |
| LangChain | 大模型应用组件与集成 | 如何组合模型、Prompt、检索器和工具来构建应用 |
| DeepAgent | 复杂 Agent 的高层封装 | 如何规划复杂任务、管理中间结果、委派子任务和维护上下文 |
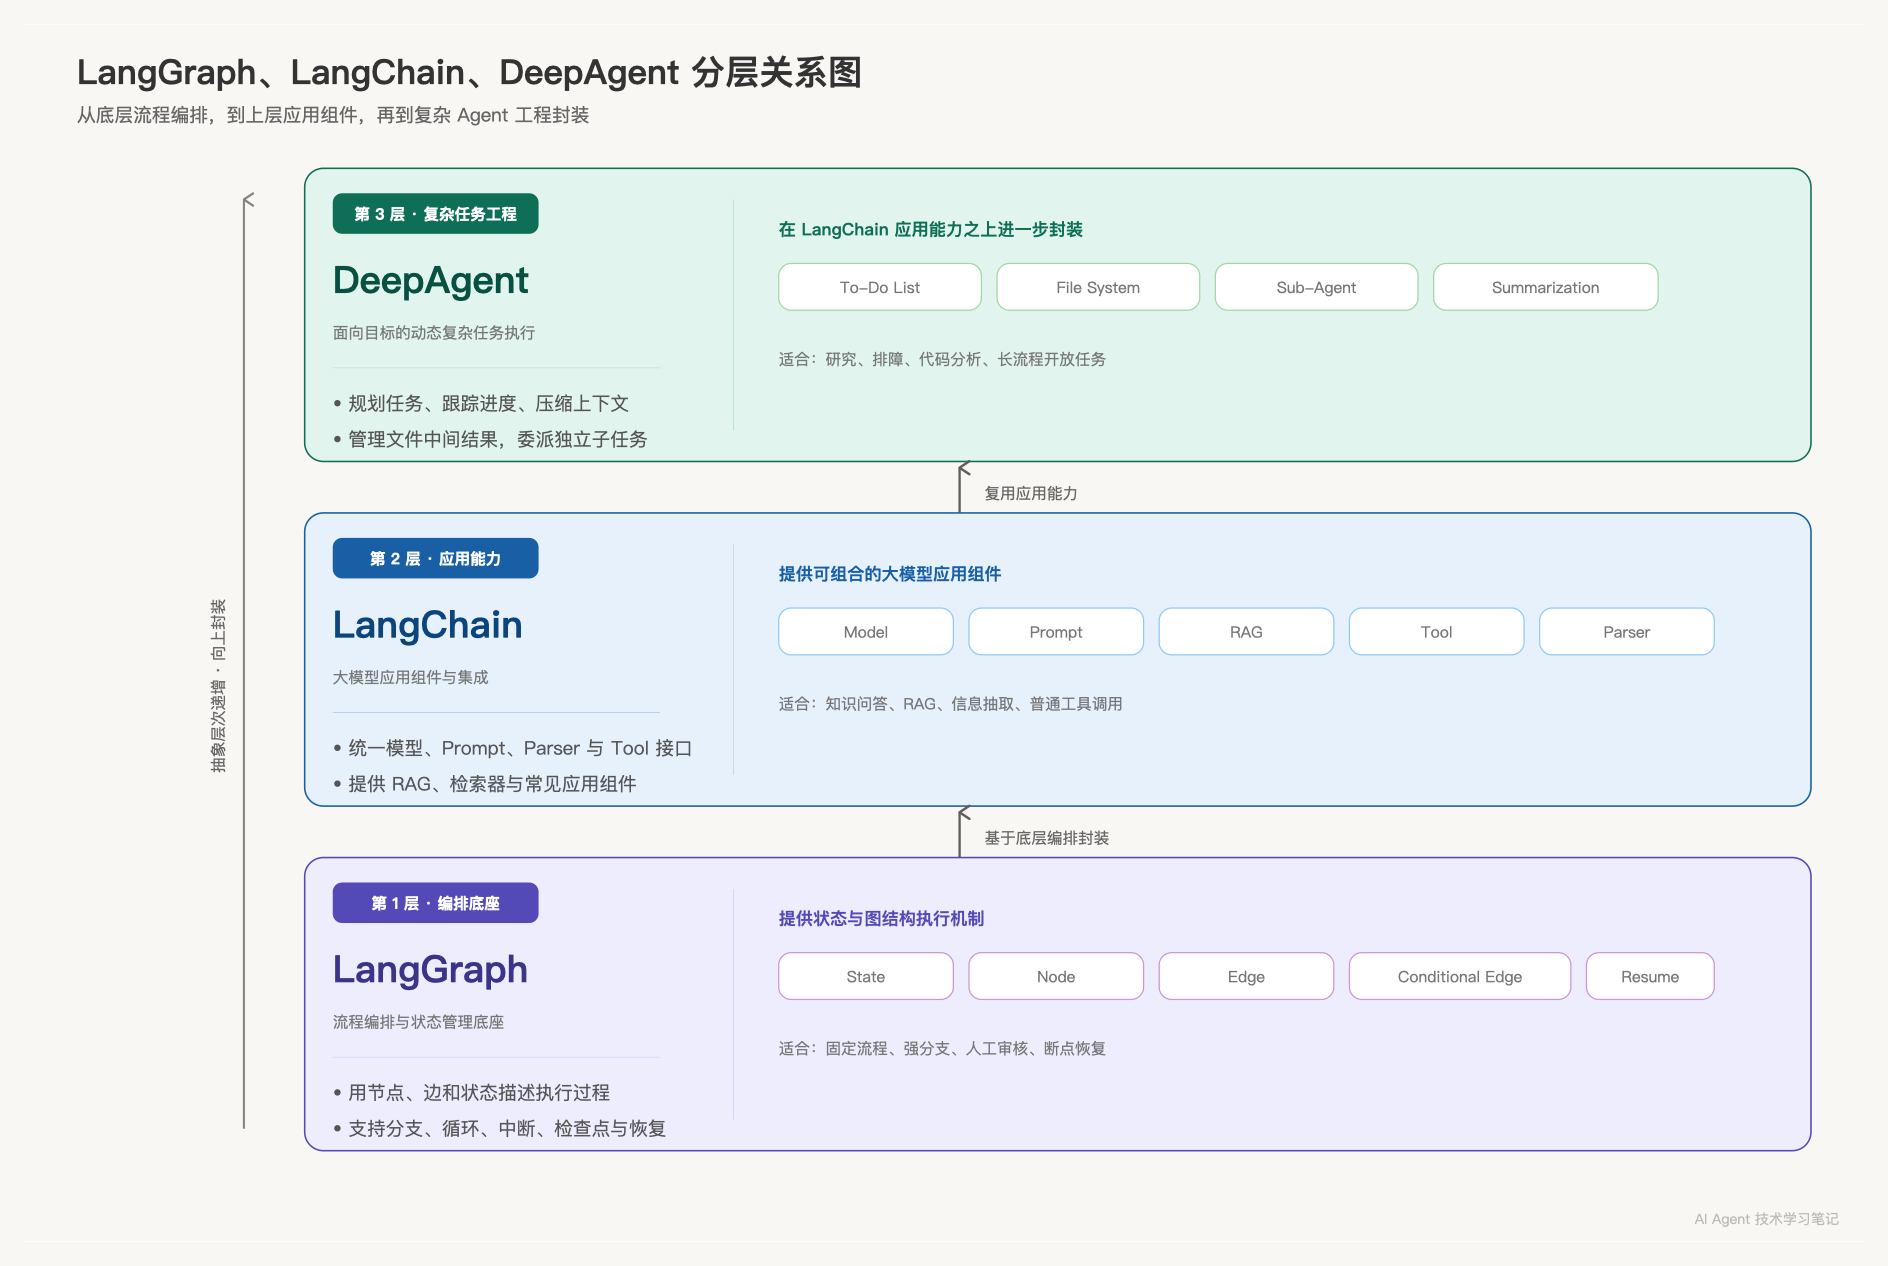
图 1 从底层向上看:LangGraph 提供流程编排与状态底座;LangChain 在其上提供模型、RAG、工具等应用能力;DeepAgent 再向上封装任务规划、文件管理、子 Agent 与上下文压缩。
这里不是说三者互相替代,而是说它们解决的问题侧重点不同,也可以组合使用。
例如,我们可以使用 LangChain 提供的模型和工具组件,使用 LangGraph 编排业务流程,再在需要自主完成复杂任务的环节中使用 DeepAgent。
所以,理解 DeepAgent 的关键,不是认为它比 LangGraph 或 LangChain 更高级,而是理解:当我们从简单的大模型应用走向复杂、长时间运行的 Agent 时,需要处理的问题越来越多,DeepAgent 将其中一部分常见机制封装成了可以直接使用的能力。
那么,封装程度越高,是不是就越好呢?
其实并不是。
封装越高,通常意味着开箱即用的能力越多,开发门槛越低;但与此同时,我们对底层执行过程的控制空间,也可能受到一定限制。
所以,如果你需要完全自定义执行流程,可以考虑 LangGraph;如果你想灵活组合模型、工具和 Agent 能力,可以选择 LangChain;如果你想快速构建能够自主规划、执行复杂任务的 Agent,那么 Deep Agents 就值得了解。
接下来,我们就从它的核心机制入手,看看 Deep Agents 到底帮我们封装了什么,以及这些机制是如何协同工作的。
第二章 DeepAgent 四大核心 Middleware +自定义Middleware的实现原理
本章是视频的技术核心。
每个组件都从五个方面展开:
- 解决什么问题。
- 提供哪些工具。
- 数据结构是什么样的。
- 具体如何执行。
- 默认配置、触发条件与实际价值是什么。
2.1 To-Do List Middleware:复杂任务如何拆解与跟踪?
2.1.1 核心工具
介绍 write_todos,解释 Agent 如何通过这个工具创建和更新任务清单。
需要结合所选版本源码核对工具名称与参数 Schema。
2.1.2 任务拆解与数据结构
以研究 LangGraph、DeepAgent 和 CrewAI,并生成技术报告为例。
任务清单可以示意为:
{
  "todos": [
    {
      "content": "收集 LangGraph 的架构资料",
      "status": "completed"
    },
    {
      "content": "收集 DeepAgent 的架构资料",
      "status": "in_progress"
    },
    {
      "content": "对比三个框架的优缺点",
      "status": "pending"
    },
    {
      "content": "生成技术报告",
      "status": "pending"
    }
  ]
}
解释三个状态:
pending:尚未开始。in_progress:正在执行。completed:已经完成。
该数据仅用于展示任务清单的基本思想,正式稿需要按照所选版本的实际 Schema 核对。
2.1.3 完整执行流程
用户提出任务 → 模型拆解任务 → 调用 write_todos → 执行任务 → 更新任务状态 → 继续执行。
重点说明:
- 模型负责生成和调整计划。
- 工具负责维护任务清单。
- Agent 根据执行结果推进后续步骤。
- 任务清单提供显式的进度跟踪,但不是确定性的工作流引擎。
2.2 File System Middleware:大型工具结果如何从上下文中卸载?
2.2.1 为什么需要文件系统?
假设 Agent 正在分析线上故障,调用日志查询工具后,返回了大量日志。
如果完整日志一直保留在对话历史中,后续模型请求可能继续携带这些内容,增加 Token 消耗与上下文负担。
DeepAgent 的文件系统不仅提供文件读写能力,还能将符合条件的大型工具返回结果保存到文件后端,并用较短的预览和文件引用替代原始的长文本。
2.2.2 默认阈值与配置
官方 FilesystemMiddleware 的默认参数:
tool_token_limit_before_evict = 20000
含义:大型工具结果的文件化阈值为 20,000 Token。
超过阈值后,框架会尝试将工具结果写入配置的后端,并替换为截断后的预览和文件引用。
需要注意:
- 这是工具返回结果的阈值,不是工具调用次数。
- 它不是整个 Agent Context 的统一阈值。
- 20,000 Token 是默认值,并非不可修改的固定限制。
- 直接配置
FilesystemMiddleware时,可以通过tool_token_limit_before_evict调整阈值。 - 如果通过
create_deep_agent使用内置 Middleware,则应核对所选版本的配置入口,不能假设可以直接传入同名参数。
2.2.3 文件系统提供哪些工具?
重点介绍:
| 工具 | 作用 |
|---|---|
ls |
列出文件与目录 |
read_file |
读取文件 |
write_file |
写入文件 |
edit_file |
编辑文件 |
glob |
按模式查找文件 |
grep |
搜索文件内容 |
execute |
执行命令,需要支持相应执行能力的后端 |
其中,execute 是否可用取决于配置的后端是否支持执行能力,不能简单理解为所有文件系统后端都能执行 Shell 命令。
2.2.4 真实场景:一段长日志如何从 Context 中卸载?
以线上订单服务故障为例。
用户要求:
“帮我分析最近一次订单服务响应时间突然升高的原因。”
Agent 调用日志查询工具,返回一段较长的日志。以下使用具有代表性的模拟日志展示处理过程。
第一步:工具返回完整日志。
2026-10-09 10:21:01 INFO  OrderService - request received, traceId=tr-001
2026-10-09 10:21:01 INFO  OrderService - validating order, orderId=O10001
2026-10-09 10:21:02 INFO  OrderService - loading customer profile
2026-10-09 10:21:02 INFO  OrderService - customer profile loaded, cost=812ms
2026-10-09 10:21:03 WARN  OrderService - database query latency elevated, cost=1840ms
2026-10-09 10:21:03 INFO  OrderService - querying inventory, sku=SKU-1001
2026-10-09 10:21:04 WARN  InventoryClient - downstream request timeout, retry=1
2026-10-09 10:21:05 WARN  InventoryClient - downstream request timeout, retry=2
2026-10-09 10:21:06 INFO  OrderService - inventory query completed, cost=2980ms
2026-10-09 10:21:06 WARN  OrderService - request total duration=5120ms
...
实际返回可能包含数千行甚至更多日志,累计超过 20,000 Token。
文件化之前,Context 中的工具返回消息可能是:
HumanMessage:
帮我分析最近一次订单服务响应时间突然升高的原因。

AIMessage:
调用 query_logs 查询订单服务日志。

ToolMessage:
[完整日志内容,约 28,000 Token]
如果继续将完整日志放在工具返回消息中,后续模型调用可能需要携带大量日志内容。
第二步:超过阈值后,框架尝试将工具结果写入文件后端。
假设文件后端将结果保存为一个可读取的文件,并返回文件引用。
文件化之后,Context 中的工具返回消息可能变为:
HumanMessage:
帮我分析最近一次订单服务响应时间突然升高的原因。

AIMessage:
调用 query_logs 查询订单服务日志。

ToolMessage:
[日志预览]
2026-10-09 10:21:01 INFO OrderService - request received...
2026-10-09 10:21:03 WARN OrderService - database query latency elevated...
2026-10-09 10:21:04 WARN InventoryClient - downstream request timeout...

完整结果已保存至:
/large_tool_results/trace-tr-001.txt
这里的路径和提示文本仅为示意,实际文件名、预览格式及引用方式取决于具体实现。
第三步:Agent 根据预览决定下一步操作。
例如,Agent 发现数据库查询延迟和下游超时可能与故障有关,于是调用文件工具继续分析。
调用 grep:
搜索包含 "database query latency" 的日志。

调用 read_file:
读取对应日志片段。

分析结果:
数据库查询耗时约 1840ms;
库存服务出现连续超时;
请求总耗时约 5120ms。
于是,Agent 可以根据需要读取完整结果或定位相关片段,而不必在每一轮推理时都携带完整日志。
这个过程解决了什么问题?
原来:完整的大型工具返回结果直接进入对话历史。
现在:符合条件的大型结果被文件化,当前工具返回消息保留预览和引用,模型可以按需读取详细内容。
需要强调,文件化不意味着原始日志从所有存储位置中永久删除,也不意味着文件引用一定会在所有后续模型请求中自动展开。
2.2.5 文件系统的本质
File System Middleware 解决两个问题:
- 中间结果管理: 支持读取、写入、编辑和搜索文件。
- 上下文控制: 对符合条件的大型工具返回结果进行文件化处理,减少当前工具返回消息携带的内容。
2.3 Sub-Agent Middleware:如何创建不同的 Agent 并委派任务?
2.3.1 为什么需要 Sub-Agent?
假设一个企业旅游客服 Agent 同时具备:
- 航班查询。
- 票价查询。
- 酒店订单查询。
- 退款规则查询。
- 景点搜索。
- 旅游攻略检索。
- 会员管理。
- 发票查询。
当任务越来越复杂时,让单个 Agent 处理所有领域的任务,可能增加工具选择难度和上下文负担。
Sub-Agent 提供了另一种方式:根据职责将工具分配给不同的子 Agent,再由主 Agent 根据任务需要委派工作。
2.3.2 子 Agent 的创建方式
使用 create_deep_agent 时,可以通过子 Agent 配置指定不同 Agent 的名称、描述、工具和模型。
下面使用旅游客服作为例子。
from deepagents import create_deep_agent

flight_agent = {
    "name": "flight_agent",
    "description": (
        "负责查询航班、起降时间、票价和余票信息。"
        "适用于机票查询任务。"
    ),
    "tools": [
        search_flights,
        query_flight_price,
    ],
}

hotel_agent = {
    "name": "hotel_agent",
    "description": (
        "负责查询酒店订单、入住信息和退款规则。"
        "适用于酒店订单与退款咨询。"
    ),
    "tools": [
        query_hotel_order,
        query_refund_policy,
    ],
}

travel_agent = {
    "name": "travel_agent",
    "description": (
        "负责检索旅游景点、亲子活动和旅游攻略。"
        "适用于旅游路线与景点推荐任务。"
    ),
    "tools": [
        search_attractions,
        search_travel_guides,
    ],
}

agent = create_deep_agent(
    model=model,
    tools=[],
    subagents=[
        flight_agent,
        hotel_agent,
        travel_agent,
    ],
)
这段代码用于展示子 Agent 的职责和工具如何组织,正式稿需要根据固定版本核对实际 API、必填字段和配置方式。
重点讲解:
| 字段 | 作用 |
|---|---|
name |
子 Agent 的名称 |
description |
说明子 Agent 的职责和适用任务 |
tools |
指定子 Agent 可使用的工具 |
model |
可配置的模型 |
system_prompt |
可配置的行为指令 |
middleware |
可配置的扩展机制 |
具体字段是否必填,以及模型、提示词和 Middleware 的继承规则,需要以所选版本的 SubAgent 配置定义为准。
2.3.3 主 Agent 如何委派任务?
DeepAgent 提供 task 工具,用于启动子 Agent 执行指定任务。
示例:
{
  "description": "查询明天上海到北京的航班,整理起飞时间、票价和余票情况。",
  "subagent_type": "flight_agent"
}
其中:
description:需要执行的具体任务。subagent_type:要调用的子 Agent 类型。
正式稿需要按所选版本的实际工具 Schema 核对参数名称。
2.3.4 拆分之后,每个 Agent 有什么不同?
| Agent | 职责 | 可用工具 |
|---|---|---|
| 主 Agent | 理解需求、拆解任务、汇总结果 | 主 Agent 自身工具及任务委派工具 |
flight_agent |
查询航班 | search_flights、query_flight_price |
hotel_agent |
查询酒店订单与退款规则 | query_hotel_order、query_refund_policy |
travel_agent |
查询景点与旅游攻略 | search_attractions、search_travel_guides |
核心区别是:
Superviosr!!!
主 Agent 负责整体任务的组织与协调,子 Agent 负责特定领域的执行。
子 Agent 的 description 让主 Agent 能够理解它适合处理什么任务,而 tools 则限制和定义它实际可用的工具集合。
2.3.5 为什么 Sub-Agent 能缓解上下文膨胀?
假设三个任务分别涉及航班查询、酒店退款和旅游景点推荐。
如果所有操作都在一个上下文中连续执行,工具调用记录和返回结果可能不断积累。
使用 Sub-Agent 后:
主 Agent
  │
  ├── task(flight_agent)
  │      └── 查询航班并整理结果
  │
  ├── task(hotel_agent)
  │      └── 查询酒店并整理结果
  │
  └── task(travel_agent)
         └── 搜索景点并整理结果
每个子 Agent 在自己的执行上下文中完成任务,再向主 Agent 返回结果。
这样,主 Agent 不必直接承载每个子任务的完整执行过程。
需要注意,子 Agent 不会自动让所有工具调用都被分流,也不保证总 Token 消耗一定下降。实际效果取决于任务划分、返回结果长度和模型调用次数。
2.4 Summarization Middleware:什么时候触发摘要,压缩后剩下什么?
2.4.1 为什么需要摘要压缩?
长时间执行的 Agent 可能积累大量历史信息:
- 用户需求。
- 模型推理消息。
- 工具调用记录。
- 工具返回结果。
- 阶段性结论。
随着历史不断增长,后续请求的输入 Token 也可能增加,甚至超过模型可用的上下文预算。
Summarization Middleware 的作用是对较早的历史消息进行摘要整理,并保留必要的近期消息,让 Agent 能够继续执行任务。
2.4.2 触发条件与默认阈值
摘要触发条件不是固定不变的。
DeepAgent 支持配置摘要触发条件,例如:
- 根据 Token 数量触发。
- 根据消息数量触发。
- 根据模型上下文窗口的比例触发。
示例配置:
trigger=("tokens", 100000)
这表示将 Token 阈值设置为 100,000;它是配置示例,不代表所有模型或版本的默认值。
也可以使用基于上下文窗口比例的配置:
trigger=("fraction", 0.8)
这表示按模型上下文窗口的 80% 设置触发条件,具体是否能准确计算取决于模型 Profile 是否提供相应限制信息。
因此,正式视频需要区分:
- 摘要触发阈值: 什么时候开始整理历史。
- 模型上下文限制: 模型最多能够接收多少输入。
- 摘要输入预算: 送去生成摘要的旧历史最多保留多少内容。
- 保留策略: 摘要后哪些近期消息不被压缩。
这些配置可以按实际需求调整,不能把它们统一说成某个固定 Token 数。
2.4.3 摘要压缩的具体例子
假设 Agent 正在定位订单服务响应时间异常的问题。
随着执行不断推进,历史消息可能变成:
用户:
帮我定位订单服务响应时间异常的原因。

Agent:
查询服务日志。

Tool:
返回大量日志内容。

Agent:
查询数据库指标。

Tool:
返回大量监控数据。

Agent:
查询最近发布记录。

Tool:
返回大量发布信息。

Agent:
分析日志和数据库指标。

Tool:
返回进一步分析结果。

……
当上下文达到配置的触发条件后,框架会对符合条件的历史消息进行摘要整理。
摘要可能类似:
任务目标:
定位订单服务响应时间异常的原因。

已完成的检查:
1. 查询服务日志,发现请求耗时增加。
2. 检查数据库指标,发现查询延迟升高。
3. 检查发布记录,确认异常发生在最近一次发布之后。

当前判断:
数据库查询延迟可能与最近一次发布有关。

待完成的工作:
检查本次发布涉及的 SQL 变更,并验证是否导致查询性能下降。
这只是用于说明摘要效果的示例,并不是框架固定生成的数据结构。
2.4.4 压缩前后的 Context 有什么区别?
压缩前:
当前模型输入:
用户问题
+ 多轮推理消息
+ 大量工具调用记录
+ 大量工具返回结果
+ 阶段性分析
压缩后:
当前模型输入:
历史摘要
+ 最近保留的消息
+ 后续新产生的消息
DeepAgent 的摘要机制还可以将被移出的历史消息保存到配置的后端,并在摘要中保留历史文件引用;在文件系统能力可用时,Agent 可以通过 read_file 重新读取详细内容。
因此,摘要压缩不是简单地把旧消息删除,而是将当前执行所需的关键信息与较早的历史记录分开管理。
2.4.5 默认保留多少消息?
直接构造 SummarizationMiddleware 时,默认保留最近 20 条消息:
keep=("messages", 20)
这表示保留策略,不是摘要触发阈值。
同时,直接构造 Middleware 和使用 create_summarization_middleware 工厂函数时,其他默认参数也可能不同。
正式稿应根据固定版本核对工厂函数实际计算出的默认触发条件,并说明哪些参数能够自行配置。
2.4.6 摘要压缩的价值与局限
价值:
- 减少后续请求携带的历史信息。
- 控制长任务的上下文增长。
- 保留与当前任务相关的关键信息。
局限:
- 摘要可能丢失细节。
- 摘要可能遗漏或错误表达部分信息。
- 摘要不能完全替代原始历史记录。
文件系统和摘要机制可以配合使用:摘要负责提炼关键信息,文件系统负责保存和按需读取详细内容。
2.5 DeepAgent vs. DeepSeek Harness:插件化设计的差异
两者都采用模块化、可扩展的设计思想,但在扩展范围和抽象层次上有所不同。
2.5.1 DeepAgent:基于 Middleware 扩展 Agent 能力
DeepAgent 通过 Middleware 将任务规划、上下文摘要、文件操作、子 Agent 调度等能力封装成可组合的模块,并将其接入 Agent 的执行流程。
开发者可以复用已有 Middleware,也可以自定义 Middleware,扩展或修改特定阶段的处理逻辑。
例如,可以自定义一个 Middleware,在模型调用前检查上下文长度,并在满足条件时触发自定义摘要逻辑。
在 LangChain / DeepAgent 中,一种常见的 Middleware 定义方式如下:
from langchain.agents.middleware import AgentMiddleware

class CustomMiddleware(AgentMiddleware):
    def before_model(self, state, runtime):
        # 模型调用前执行自定义逻辑
        return None
这里:
AgentMiddleware:Middleware 的基类。before_model:模型调用前的钩子,可以在这里执行自定义处理。state:当前 Agent 的状态,例如消息历史。runtime:当前执行环境,可以访问运行时上下文。
上面只是展示扩展结构的简化示例。实际实现时,需要根据所使用的 LangChain / DeepAgent 版本,确认 Middleware 接口、状态修改方式及注册方法。
核心特点:以扩展 Agent 的能力和执行流程为主。
2.5.2 DeepSeek Harness:插件化覆盖整个运行系统
DeepSeek Harness 采用更广泛的插件化设计,不仅可以扩展具体功能,还可以将模型适配、工具注册、会话管理,甚至 Agent Loop(执行循环)设计为可替换的模块。
例如,传统 Agent Loop 采用“模型调用 → 工具执行 → 返回结果 → 再次调用模型”的循环。如果希望改成由模型生成代码、通过代码统一编排多个工具调用的 Code Mode,就可以替换相应的执行机制,而不必将所有逻辑耦合在固定的核心循环中。
核心特点:插件化不仅覆盖功能层,还可以深入核心执行机制。
2.5.3 本质区别
| 对比维度 | DeepAgent | DeepSeek Harness |
|---|---|---|
| 核心扩展机制 | Middleware | Plugin |
| 典型扩展对象 | 上下文管理、任务规划、工具调用等处理逻辑 | 模型适配、工具管理、会话管理、Agent Loop 等 |
| 是否可以自定义功能 | 可以 | 可以 |
| 是否支持修改执行流程 | 可以通过底层编排和自定义逻辑实现 | 可以通过可替换的 Agent Loop 等模块实现 |
| 设计侧重点 | 在 Agent 执行流程中组合、扩展能力 | 将整个 Agent 运行系统设计为可组合、可替换的模块 |
总结:两者的区别不在于一个能扩展、另一个不能扩展,而在于默认提供的扩展抽象不同。DeepAgent 的 Middleware 主要面向 Agent 能力和执行阶段的扩展;DeepSeek Harness 则进一步将插件化延伸到 Agent Loop 等核心运行机制,使执行策略本身也能够被替换。
需要注意,这不意味着 DeepAgent 无法修改底层执行机制,而是说这类修改通常需要利用其底层 LangGraph 编排能力或自行实现相应逻辑,而不是仅靠添加一个普通 Middleware 就能完成。
第三章 实战案例:DeepAgent 如何处理多意图客服请求?
3.1 用户请求与主 Agent 的输入
使用虚构的旅游客服场景:
帮我查一下明天从上海到北京的机票,看看我上周订的酒店能不能退,再给我推荐几个北京适合带孩子去的景点。
业务代码不会直接把“四个 Middleware”塞给主 Agent,通常只传入用户消息:
USER_REQUEST = (
    "帮我查一下明天从上海到北京的机票,"
    "看看我上周订的酒店能不能退,"
    "再给我推荐几个北京适合带孩子去的景点。"
)

main_input = {
    "messages": [
        {
            "role": "user",
            "content": USER_REQUEST,
        }
    ]
}
主 Agent 接收到的是 main_input。任务清单、子任务拆分和工具调用,由主 Agent 在执行过程中通过内置工具产生。
3.2 子 Agent 的定义与工具
下面是一个可运行的代码骨架,按 deepagents 0.7.x 的公开接口整理。工具函数使用模拟数据,重点展示数据如何进入 Agent、如何委派、如何返回结构化结果;版本升级时仍需以官方 API 为准。
from __future__ import annotations

from typing import Any

from deepagents import create_deep_agent
from pydantic import BaseModel, Field

# ---------- 机票子 Agent 的数据协议与工具 ----------

class FlightOption(BaseModel):
    flight_no: str = Field(description="航班号")
    departure: str = Field(description="起飞时间")
    arrival: str = Field(description="到达时间")
    price: float = Field(description="单人票价")
    seats: int = Field(description="剩余座位")

class FlightResult(BaseModel):
    origin: str
    destination: str
    depart_date: str
    options: list[FlightOption]
    summary: str

def search_flights(
    origin: str,
    destination: str,
    depart_date: str,
    passengers: int = 1,
) -> list[dict[str, Any]]:
    """查询指定日期、线路和乘客人数的航班。"""
    return [
        {
            "flight_no": "MU5101",
            "departure": "2026-10-10 08:00",
            "arrival": "2026-10-10 10:15",
            "price": 680.0,
            "seats": 8,
        },
        {
            "flight_no": "CA1832",
            "departure": "2026-10-10 12:30",
            "arrival": "2026-10-10 14:45",
            "price": 720.0,
            "seats": 5,
        },
    ]

FLIGHT_AGENT = {
    "name": "flight_agent",
    "description": (
        "查询和比较航班,返回航班号、起降时间、价格和余票。"
        "适用于机票查询任务。"
    ),
    "system_prompt": (
        "你是航班查询专员。只使用 search_flights 查询航班;"
        "必须按 FlightResult 返回结构化结果,包含可选航班和简明总结。"
    ),
    "tools": [search_flights],
    "response_format": FlightResult,
}

# ---------- 酒店子 Agent 的数据协议与工具 ----------

class HotelRefundResult(BaseModel):
    order_id: str
    refundable: bool
    refund_amount: float
    conditions: list[str]
    summary: str

def query_hotel_order(order_id: str) -> dict[str, Any]:
    """查询酒店订单基本信息。"""
    return {
        "order_id": order_id,
        "hotel_name": "北京故宫王府井酒店",
        "check_in": "2026-10-11",
        "check_out": "2026-10-13",
        "amount": 1280.0,
    }

def query_refund_policy(order_id: str, check_in: str) -> dict[str, Any]:
    """查询酒店订单的退款规则。"""
    return {
        "order_id": order_id,
        "refundable": True,
        "refund_amount": 1024.0,
        "conditions": [
            "入住前 48 小时取消,可退 80%",
            "逾期取消,仅退未入住部分",
        ],
    }

HOTEL_AGENT = {
    "name": "hotel_agent",
    "description": (
        "查询酒店订单、入住信息和退款规则。"
        "适用于酒店订单与退款咨询。"
    ),
    "system_prompt": (
        "你是酒店订单专员。先查询订单,再查询退款规则;"
        "必须按 HotelRefundResult 返回结构化结果,不能猜测退款金额。"
    ),
    "tools": [query_hotel_order, query_refund_policy],
    "response_format": HotelRefundResult,
}

# ---------- 旅游子 Agent 的数据协议与工具 ----------

class Attraction(BaseModel):
    name: str
    reason: str
    suggested_duration: str

class TravelResult(BaseModel):
    destination: str
    audience: str
    recommendations: list[Attraction]
    summary: str

def search_family_attractions(city: str) -> list[dict[str, Any]]:
    """检索适合亲子的城市景点。"""
    return [
        {
            "name": "北京科学中心",
            "reason": "互动展项多,适合儿童探索",
            "suggested_duration": "3-4 小时",
        },
        {
            "name": "北京动物园",
            "reason": "路线轻松,动物种类丰富",
            "suggested_duration": "半天",
        },
    ]

TRAVEL_AGENT = {
    "name": "travel_agent",
    "description": (
        "检索旅游景点、亲子活动和旅游攻略。"
        "适用于旅游路线与景点推荐任务。"
    ),
    "system_prompt": (
        "你是亲子旅游推荐专员。只使用 search_family_attractions;"
        "必须按 TravelResult 返回结构化结果,说明推荐理由和建议时长。"
    ),
    "tools": [search_family_attractions],
    "response_format": TravelResult,
}
3.3 主 Agent 的定义
主 Agent 不直接绑定所有领域工具,而是负责识别意图、拆解任务、委派子 Agent,并汇总最终回复。
MAIN_AGENT_PROMPT = """
你是旅游客服总调度 Agent。

处理规则:
1. 先识别用户请求中的独立业务意图。
2. 使用 write_todos 建立任务清单,维护 pending、in_progress、completed 状态。
3. 对机票、酒店、景点等独立任务,使用 task 工具委派给对应子 Agent。
4. 子 Agent 返回结构化结果后,再统一汇总;不要编造缺失信息。
5. 最终回复用户时,分别说明机票、酒店退款和景点建议。
"""

main_agent = create_deep_agent(
    model="openai:gpt-5.5",  # 示例模型,可替换为任意受支持的模型
    system_prompt=MAIN_AGENT_PROMPT,
    subagents=[
        FLIGHT_AGENT,
        HOTEL_AGENT,
        TRAVEL_AGENT,
    ],
)

# 把前面定义的用户消息输入主 Agent。
result = main_agent.invoke(main_input)
print(result["messages"][-1].content)
3.4 主 Agent 如何拆解任务
主 Agent 完成规划后,内部的任务清单可以表示为:
{
  "todos": [
    {
      "content": "查询明天上海到北京的机票",
      "status": "in_progress"
    },
    {
      "content": "确认上周北京酒店订单能否退款",
      "status": "pending"
    },
    {
      "content": "推荐北京适合亲子的景点",
      "status": "pending"
    },
    {
      "content": "整合机票、酒店退款和景点建议",
      "status": "pending"
    }
  ]
}
随后,主 Agent 会产生三个独立的 task 工具调用。每个调用都包含目标子 Agent 和完整任务描述,因此子 Agent 不需要读取主 Agent 的完整上下文:
[
  {
    "name": "task",
    "args": {
      "subagent_type": "flight_agent",
      "description": "查询明天从上海到北京的航班,乘客 1 人。返回航班号、起降时间、票价和余票,并按 FlightResult 输出。"
    }
  },
  {
    "name": "task",
    "args": {
      "subagent_type": "hotel_agent",
      "description": "查询用户上周预订的北京酒店订单,确认最新退款规则、可退金额和限制条件,并按 HotelRefundResult 输出。"
    }
  },
  {
    "name": "task",
    "args": {
      "subagent_type": "travel_agent",
      "description": "推荐适合带孩子游玩的北京景点,给出推荐理由和建议游玩时长,并按 TravelResult 输出。"
    }
  }
]
隔离模式下,flight_agent 实际接收到的核心数据就是:
{
  "subagent_type": "flight_agent",
  "description": "查询明天从上海到北京的航班,乘客 1 人。返回航班号、起降时间、票价和余票,并按 FlightResult 输出。"
}
它只看到这段被委派的任务,不会自动看到主 Agent 的完整对话。需要跨任务共享的信息,必须在 description 中明确写清。
3.5 子 Agent 返回什么,主 Agent 又如何汇总
因为三个子 Agent 都配置了 response_format,主 Agent 最终接收的是可程序化处理的 JSON,而不是子 Agent 的中间工具调用记录。下面为便于阅读,把 ToolMessage.content 展示成 JSON 对象;实际传输时它是 JSON 字符串。
[
  {
    "subagent_type": "flight_agent",
    "content": {
      "origin": "上海",
      "destination": "北京",
      "depart_date": "2026-10-10",
      "options": [
        {
          "flight_no": "MU5101",
          "departure": "2026-10-10 08:00",
          "arrival": "2026-10-10 10:15",
          "price": 680.0,
          "seats": 8
        }
      ],
      "summary": "明天上午有一班余票充足的直飞航班。"
    }
  },
  {
    "subagent_type": "hotel_agent",
    "content": {
      "order_id": "HT20261007001",
      "refundable": true,
      "refund_amount": 1024.0,
      "conditions": ["入住前 48 小时取消,可退 80%"],
      "summary": "订单当前可退款,预计退款 1024 元。"
    }
  },
  {
    "subagent_type": "travel_agent",
    "content": {
      "destination": "北京",
      "audience": "亲子",
      "recommendations": [
        {
          "name": "北京科学中心",
          "reason": "互动展项多,适合儿童探索",
          "suggested_duration": "3-4 小时"
        }
      ],
      "summary": "建议优先安排科技互动类景点。"
    }
  }
]
主 Agent 最后把三份结果整合成面向用户的回答。子 Agent 执行过程中的工具参数、日志、失败重试和中间推理,不进入主 Agent 的最终结果。
3.6 四个 Middleware 如何协同?
- To-Do List: 跟踪三个业务任务及最终汇总任务的完成情况。
- File System: 在必要时保存较长的查询结果、分析材料或阶段性报告。
- Sub-Agent: 将机票、酒 店、旅游推荐等相对独立的任务分派给不同 Agent。
- Summarization: 当执行历史达到配置的压缩条件时,整理上下文中的重要信息,以便继续执行。
需要说明,这四种机制不一定在每个请求中全部触发。是否使用文件化、子任务委派或摘要压缩,取决于任务执行情况和具体配置。
多意图识别本身也不等于多 Agent。只有一个 Agent 难以同时维护领域规则、工具集合和上下文,或者这些子任务可以真正独立并行时,才有必要引入多个 Sub-Agent。
第四章 总结:DeepAgent 到底带来了什么?
4.1 从基础工具调用到复杂任务执行
普通 Agent 已经能够通过工具调用完成任务。
DeepAgent 进一步整合任务清单、文件管理、子任务委派和上下文压缩等机制,帮助 Agent 执行更复杂、持续时间更长的任务。
4.2 四种机制分别解决什么问题?
| 机制 | 核心问题 |
|---|---|
| To-Do List | 如何规划任务、跟踪进度 |
| File System | 如何保存和复用中间结果 |
| Sub-Agent | 如何分工处理相对独立的子任务 |
| Summarization | 如何管理不断增长的上下文 |
4.3 DeepAgent 与 Graph 如何配合?
Graph 更侧重流程组织和执行控制,DeepAgent 更侧重复杂任务的动态规划与执行。
两者可以结合,而不必相互替代。
最终结论:
DeepAgent 的价值,不在于让 Agent 多调用几个工具,而在于把复杂任务执行过程中需要的规划、存储、委派和上下文管理机制整合起来。