java.util.concurrent JUC
思路:单线程-多线程-线程池-异步编程
一、单线程
思路:线程创建 → 生命周期 → 常见区别 → 用户线程与守护线程
1. 线程创建
Java 中创建线程主要有四种方式。但本质都是new Thread.start()
(1)继承 Thread 类
继承 Thread 类,重写 run() 方法,调用 start() 启动线程。
class MyThread extends Thread{
    @Override
    public void run(){
        System.out.println("线程执行");
    }
}
new MyThread().start();
特点
- Java 是单继承,继承 Thread 后不能再继承其他类,因此扩展性较差
(2)实现 Runnable 接口
实现 Runnable 接口,重写 run() 方法,再交给 Thread 创建线程。
class MyRunnable implements Runnable{
    @Override
    public void run(){
        System.out.println("线程执行");
    }
}
new Thread(new MyRunnable()).start();
//线程与任务解耦
特点
- 一个 Runnable 可以被多个线程共享,避免单继承限制
- 实现线程与任务解耦
(3)实现 Callable 接口 + FutureTask
Callable 是 Runnable 的增强版,可以有返回值,也可以抛异常。
实现call方法
class MyCallable implements Callable<Integer> {
    @Override
    public Integer call() throws Exception {
        System.out.println("线程执行");
        return 100;
    }
}
// 将 Callable 包装成 FutureTask FutureTask<Integer>
task = new FutureTask<>(new MyCallable());
// 启动线程执行任务
new Thread(task).start();
// 获取任务返回值 Integer result =
task.get();
System.out.println("任务结果:" + result);
特点
- 支持返回值
- 支持抛异常
- get() 获取结果,会阻塞当前线程直到任务完成
- 具体见四、异步编程
⚠️ 注意「阻塞」二字:调用 get() 之后当前线程会停在原地等结果,等待期间什么也做不了,这就是同步编程。对应的异步编程是:发起后立即返回,任务在后台执行,结果出来再通知你。Java 的异步方案(Future → CompletableFuture)放在第四章,那里会讲它怎么解决 get() 阻塞的问题。
(4)线程池(企业开发主流)
企业开发几乎都采用线程池创建线程,避免频繁创建、销毁线程带来的性能开销。
2. 线程生命周期
Java 中线程一共有 6 种状态(Thread.State),整体流转如下:
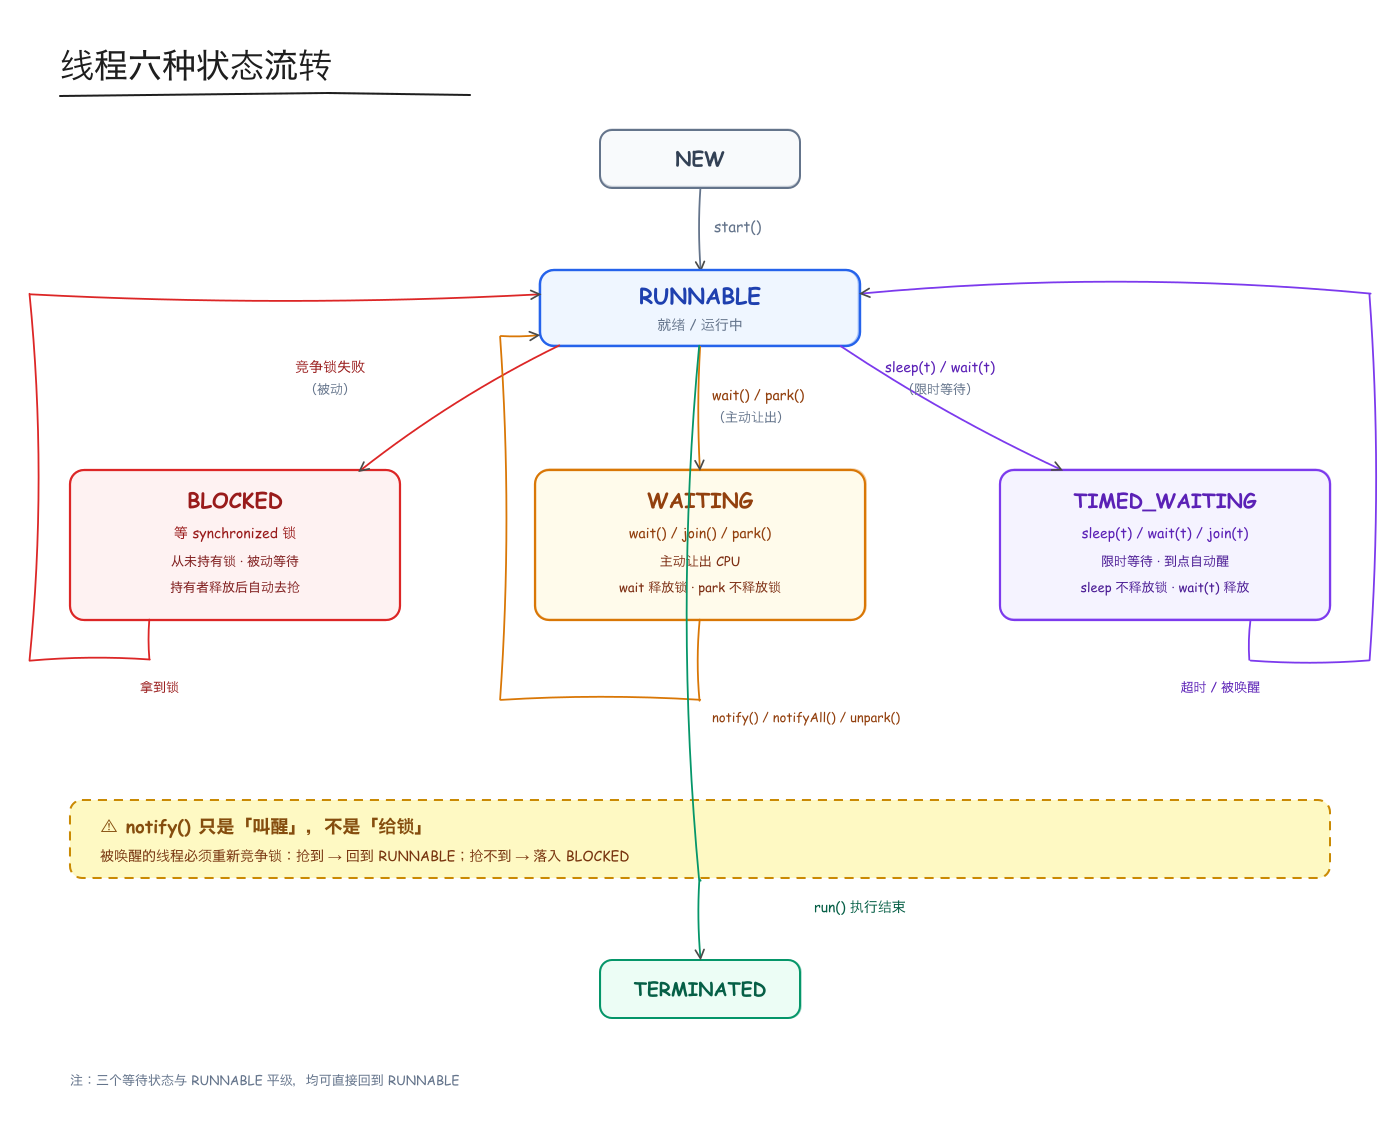
各状态的细节:
NEW(新建)
线程对象已经创建,但还没有调用 start()。
Thread t = new Thread();
RUNNABLE(可运行)
调用 start() 后进入 RUNNABLE。
需要注意:
Java 的 RUNNABLE 包含了操作系统中的:
- 就绪(Ready)
- 运行(Running)
真正什么时候运行,由 CPU 调度决定。
BLOCKED(阻塞)
等待获取 synchronized 锁时进入 BLOCKED 状态。
如果锁已经被其他线程持有,则当前线程进入 BLOCKED。
WAITING(无限等待)
线程主动进入等待状态,需要其他线程唤醒。
常见方法:
- wait()
- join()
- LockSupport.park()
必须依赖:
- notify()
- notifyAll()
- unpark()
或者等待目标线程结束,才能继续执行。
TIMED_WAITING(限时等待)
等待一段时间,到时间自动恢复。
常见方法:
- sleep(time)
- wait(time)
- join(time)
例如:
Thread.sleep(1000);
1 秒后自动恢复到 RUNNABLE。
TERMINATED(终止)
线程执行结束。
生命周期结束。
3. 常见区别
(1)run() 和 start()
run()普通方法调用。
thread.run();
不会创建新的线程。
仍然由当前线程执行。
start()
真正启动线程。
thread.start();
JVM 会创建新的线程,并交给操作系统调度。
最终自动调用 run()。
区别
| run() | start() |
|---|---|
| 普通方法 | 创建新线程 |
| 当前线程执行 | 新线程执行 |
| 不会并发 | 可以并发 |
| 可重复调用 | 一个线程只能调用一次 |
(2)wait() 和 sleep()
wait()Object 类的方法。
作用:
让线程进入等待状态。
特点:
- 释放锁
- 必须在 synchronized 中调用
- 需要 notify()/notifyAll() 唤醒
例如:
synchronized(lock){ lock.wait(); }
sleep()
Thread 类的静态方法。
作用:
让线程休眠一段时间。
特点:
- 不释放锁
- 任意地方都能调用
- 时间到了自动恢复
例如:
Thread.sleep(1000);
区别
| wait() | sleep() |
|---|---|
| Object 方法 | Thread 方法 |
| 释放锁 | 不释放锁 |
| 必须在 synchronized 中 | 任意位置 |
| notify 唤醒 | 时间到自动恢复 |
(3)notify() 和 notifyAll()
二者都是 Object 的方法,只能在 synchronized 中使用。
notify()随机唤醒一个waitSet等待线程。
例如:
lock.notify();
被唤醒的线程不会立即执行,而是先进入 EntryList 重新竞争锁。
notifyAll()
唤醒所有等待线程。
例如:
lock.notifyAll();
所有线程都会进入 EntryList,再重新竞争锁。
区别
| notify() | notifyAll() |
|---|---|
| 唤醒一个 | 唤醒全部 |
| 唤醒哪个不确定 | 所有线程重新竞争 |
4. 用户线程与守护线程
Java 中线程分为:
- 用户线程(User Thread)
- 守护线程(Daemon Thread)
用户线程
默认创建的线程都是用户线程。
特点:
只要还有一个用户线程没有结束,JVM 就不会退出。
例如:
- main 线程
- 业务线程
- Web 请求线程
守护线程
守护线程主要用于为其他线程提供服务。
例如:
- GC(垃圾回收)线程
- JVM 内部的一些后台线程
创建方式:
thread.setDaemon(true);
必须在 start() 之前设置。
用户线程与守护线程区别
| 用户线程 | 守护线程 |
|---|---|
| JVM 会等待执行结束 | 用户线程全部结束后自动退出 |
| 默认创建 | 需要手动设置 |
| 执行业务逻辑 | 提供后台服务 |
二、多线程
JMM = Java Memory Model,Java 内存模型 思路:JMM 内存模型(原子性 / 可见性 / 有序性 / 死锁活锁饥饿)→ 线程协作 → 线程安全集合
JMM内存模型
JMM(Java Memory Model)规定,每个线程拥有独立的工作内存,共享变量存放在主内存,线程操作变量时会先拷贝到工作内存,操作后再写回主内存,这种架构会引发并发问题。
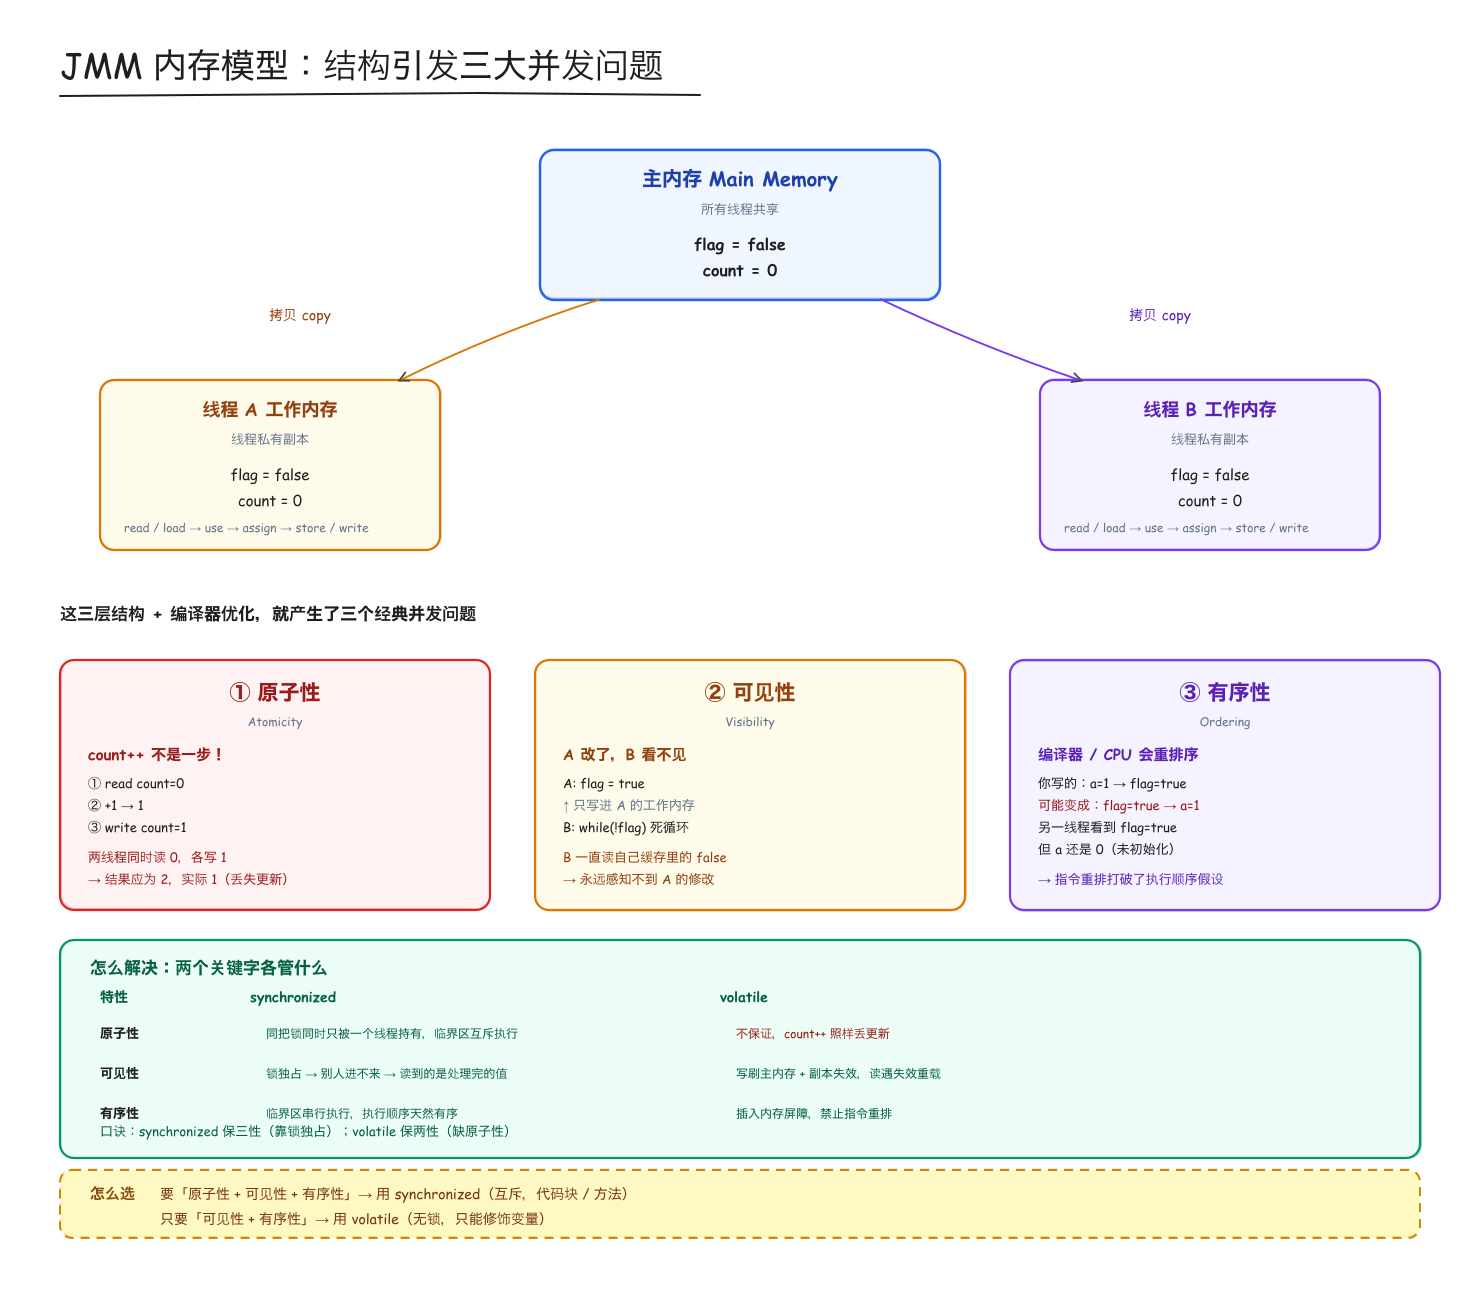
JMM的三大特性,也就是三大问题:原子性、可见性、有序性。
原子性
synchronized
概念synchronized 是 Java 提供的内置悲观锁,具有可重入、非公平的特点,可以修饰同步代码块、实例方法和静态方法。
- 修饰同步代码块:锁指定对象;
- 修饰实例方法:锁当前对象(this);
- 修饰静态方法:锁当前类的 Class 对象。
每个 Java 对象都包含:
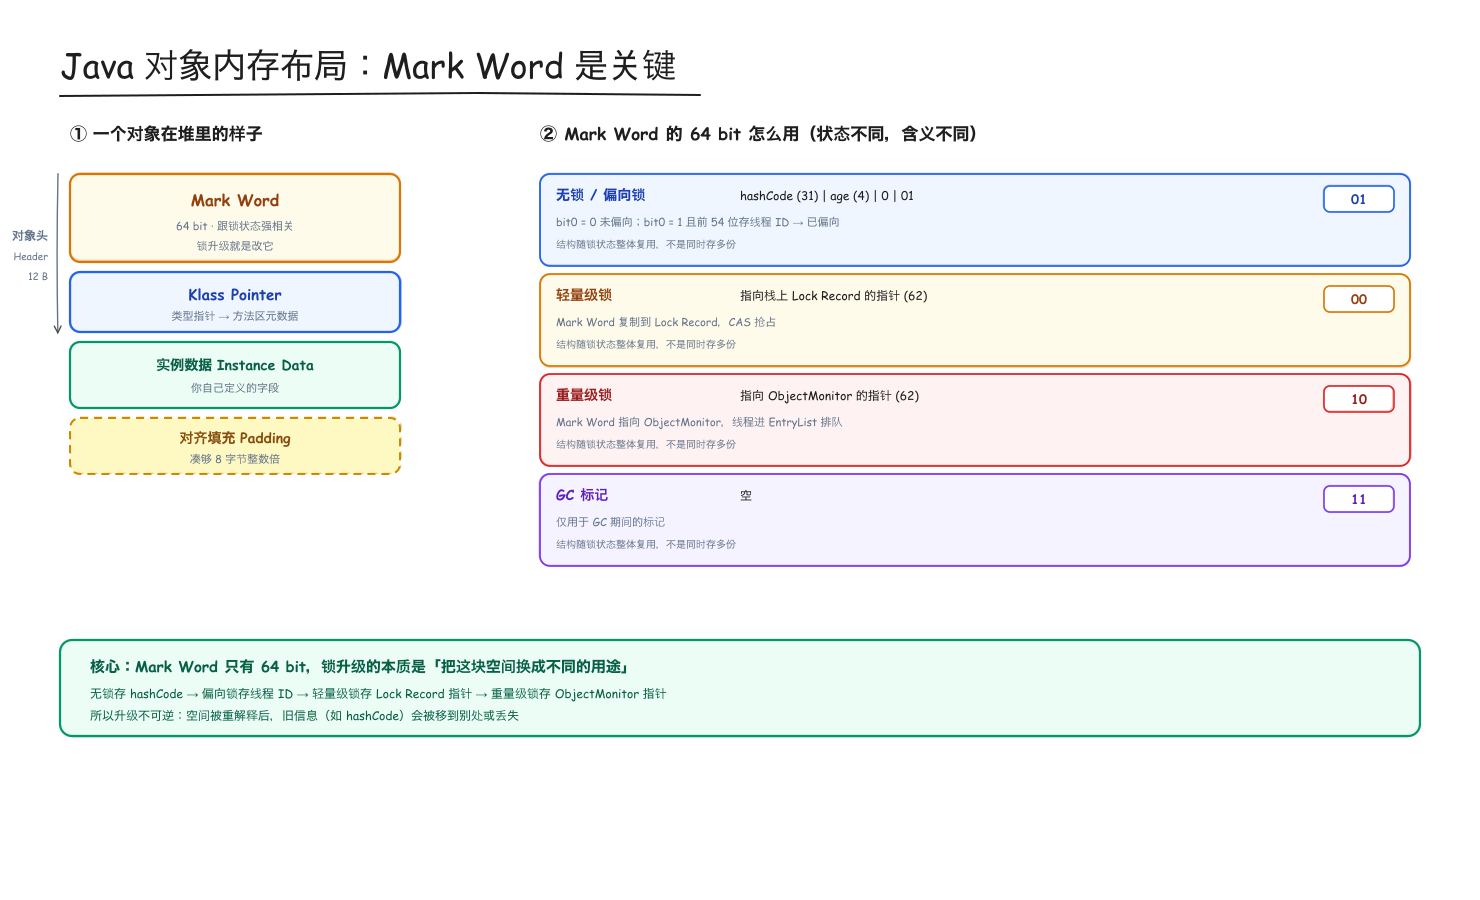
锁升级的本质,就是 Mark Word 存储内容不断发生变化。
无锁 ↓ 单线程重复获取锁 偏向锁 ↓ 多线程竞争,但不激烈 轻量级锁(Mark Word → Lock Record) ↓ 多线程同时竞争同一把锁 重量级锁(Mark Word → ObjectMonitor)
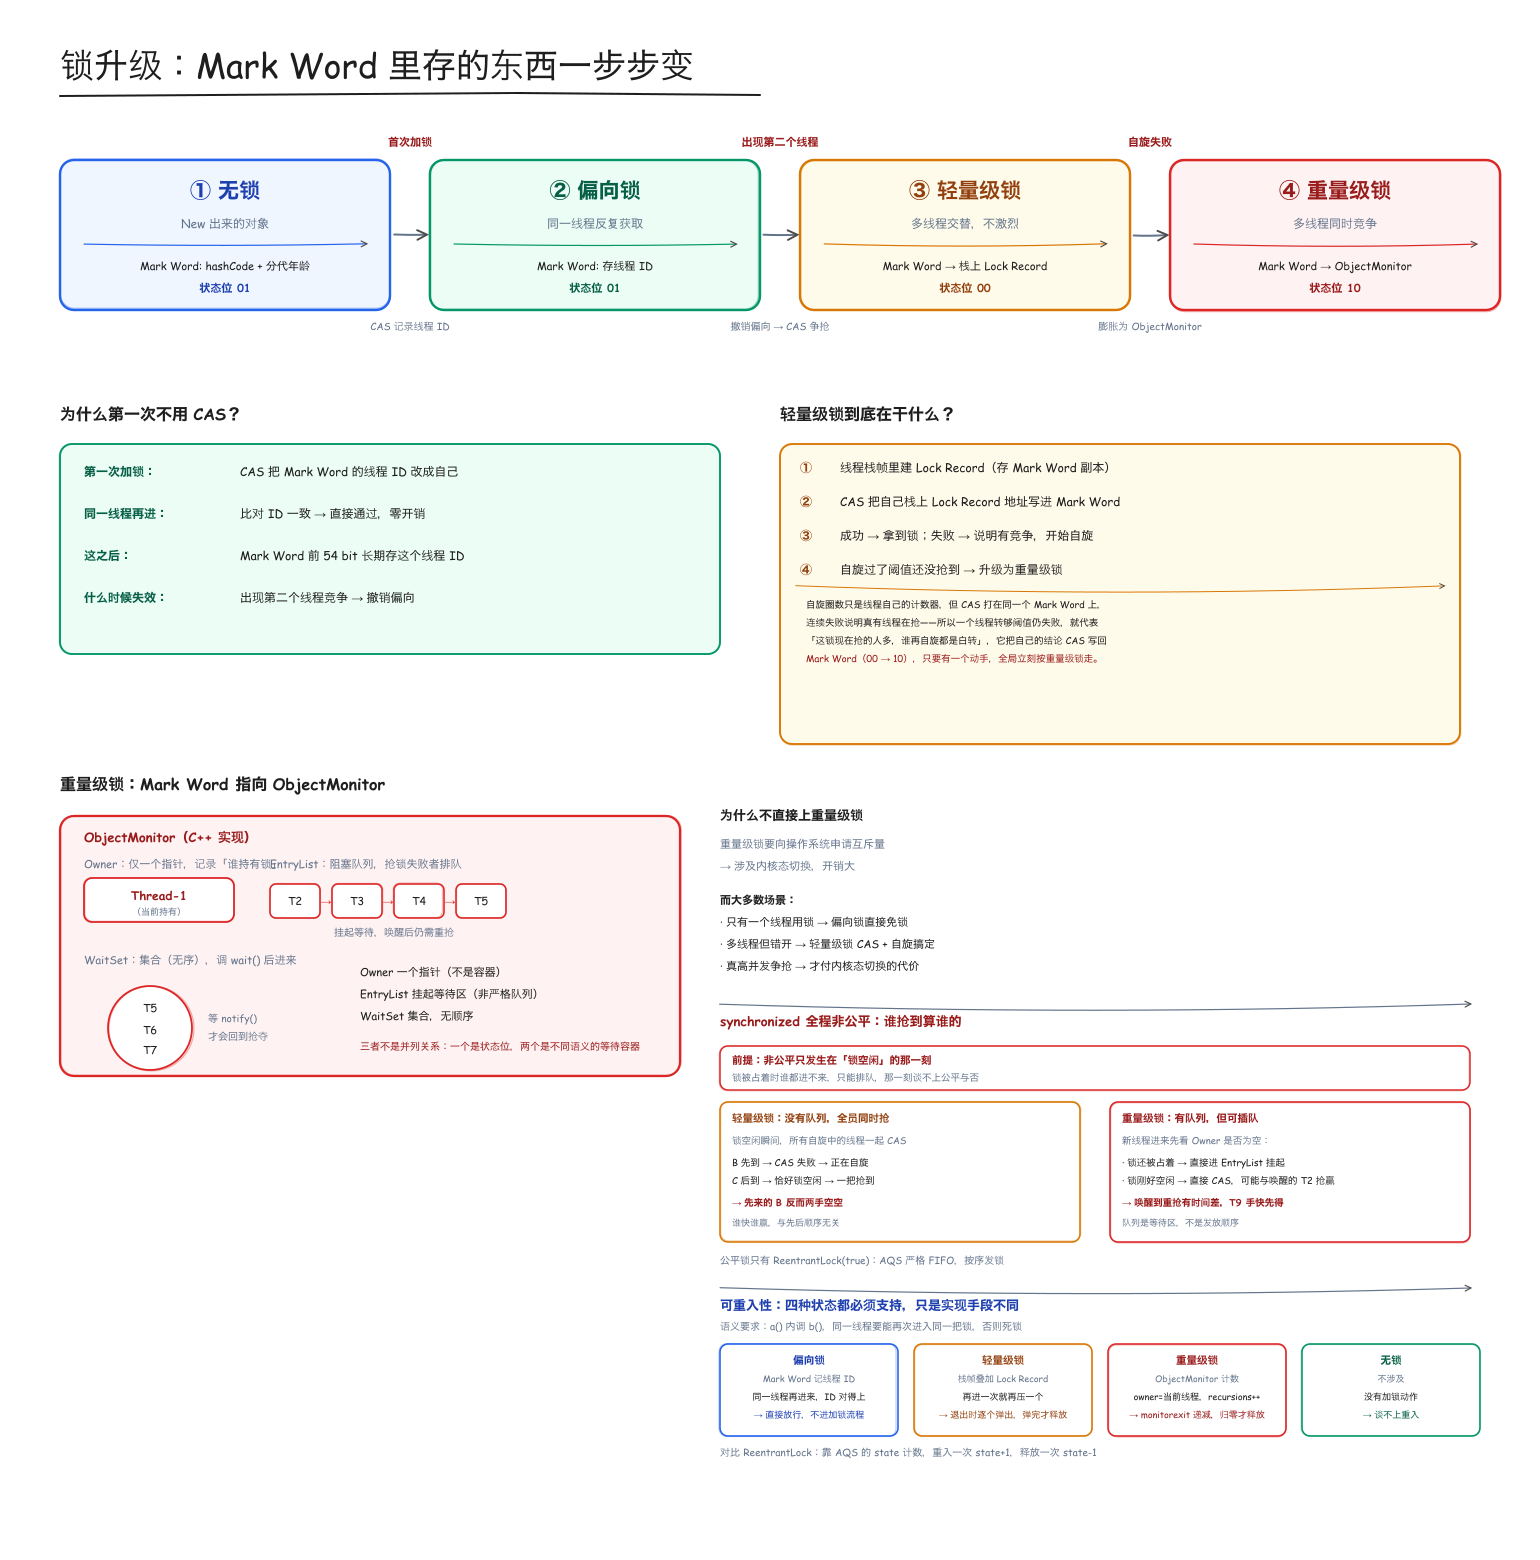
- 无锁
Mark Word存hashcode、gc等与锁无关的信息。
- 偏向锁
适用于,单线程反复获取同一把锁,没有竞争
原理:
第一次获取锁后,Mark Word 直接记录线程 ID。
以后同一线程再次进入,无需 CAS,也无需真正加锁。
如果出现第二个线程竞争,撤销偏向锁,升级为轻量级锁。
- 轻量级锁
适用于,多线程交替执行,但竞争不激烈
原理:
线程进入 synchronized 时,JVM 会在当前线程栈帧中创建一个 Lock Record(锁记录)。
然后,利用 CAS 将 Mark Word 替换为Lock Record 地址
如果 CAS 成功,获取锁成功;如果失败,说明发生竞争,开始自旋。如果自旋一段时间还没有抢到锁,升级为重量级锁。
- 重量级锁(重点)
适用于,多线程同时竞争同一把锁
原理:
Mark Word指向本地内存里的ObjectMonitor(ObjectMonitor 是 HotSpot JVM 使用 C++ 实现的 Monitor管程对象),包含三大核心模块:
◦ Owner:记录当前持有锁的线程;
◦ EntryList:抢锁失败的线程进入该队列阻塞排队;
◦ WaitSet:持有锁的线程调用wait()后,会主动释放锁并进入该集合等待。
竞争过程:
第一个获取锁的线程成为 Owner;其他竞争失败的线程进入 EntryList 阻塞等待;
Owner 释放锁后,JVM 唤醒 EntryList头线程和新进入的线程重新竞争锁。
调用 wait() 的线程会释放锁并进入 WaitSet,notify()/notifyAll() 只是将线程从 WaitSet 移动到 EntryList,最终仍需重新竞争锁才能继续执行。
非公平锁的原因当锁释放后,新到来的线程会先尝试CAS抢锁,有可能插队成功;而EntryList中排队已久的线程反而无法获取锁,因此synchronized是非公平锁。
ReentrantLock
概念ReentrantLock 是 JDK 提供的显式锁,实现了lock 接口。
底层基于 AQS+ CAS 实现。
特点支持可重入锁;
支持**公平锁、非公平锁(**构造方法传入true为公平锁(严格FIFO,禁止插队),默认非公平);
支持中断:
lockInterruptibly() 可中断线程抢锁;
支持限时:
- tryLock() 无视公平性,不管是公平锁还是非公平锁,都尝试抢锁,抢不到直接返回false,而不进行等待;
- tryLock(超时) 限时等待,遵循公平/非公平,单位时间内获取不到再返回false;
支持条件:可创建多个 Condition 条件队列,实现精准分组唤醒。
AQSReentrantLock 的核心是 AQS(抽象队列同步器)。
AQS 内部主要维护三部分:state+CLH双向等待队列(队列中的每个元素封装为Node节点)+Condition条件队列。
(类比 synchronized重量级锁中的owner+entryList+waitSet)
AQS实现的有:
独占式:
ReentrantLock,
共享式:
ReentrantReadWriteLock(可重入读写锁),
CountDownLatch(倒计时门闩),CyclicBarrier(循环栅栏),
Semaphore(信号量)
state同步状态。
对于 ReentrantLock:
- state = 0:没有线程持有锁
- state = 1:已经有线程持有锁
- state > 1:发生锁重入,记录重入次数
每个等待线程会被封装为一个 Node 节点,节点中保存线程引用(thread)、节点状态(waitStatus)、前驱节点(prev)和后继节点(next)等信息。
waitStatus 五个取值:
1 CANCELLED:节点已取消(超时/中断),唤醒时要跳过它-1 SIGNAL:后继在等我,我释放锁时必须 unpark 它-2 CONDITION:在 Condition 条件队列里等 signal-3 PROPAGATE:共享模式下唤醒要向后传播(如读锁)0 INITIAL:新入队的默认值,暂时没有需要照顾的后继
存放竞争失败的线程节点,head队首、tail队尾。
懒加载,只有出现第一个竞争失败的线程,才会初始化。
head——>node——>node——>tail
head 是虚节点,不存线程;真正等待的线程从 head.next 开始。节点之间靠 prev / next 双向指针串起来。
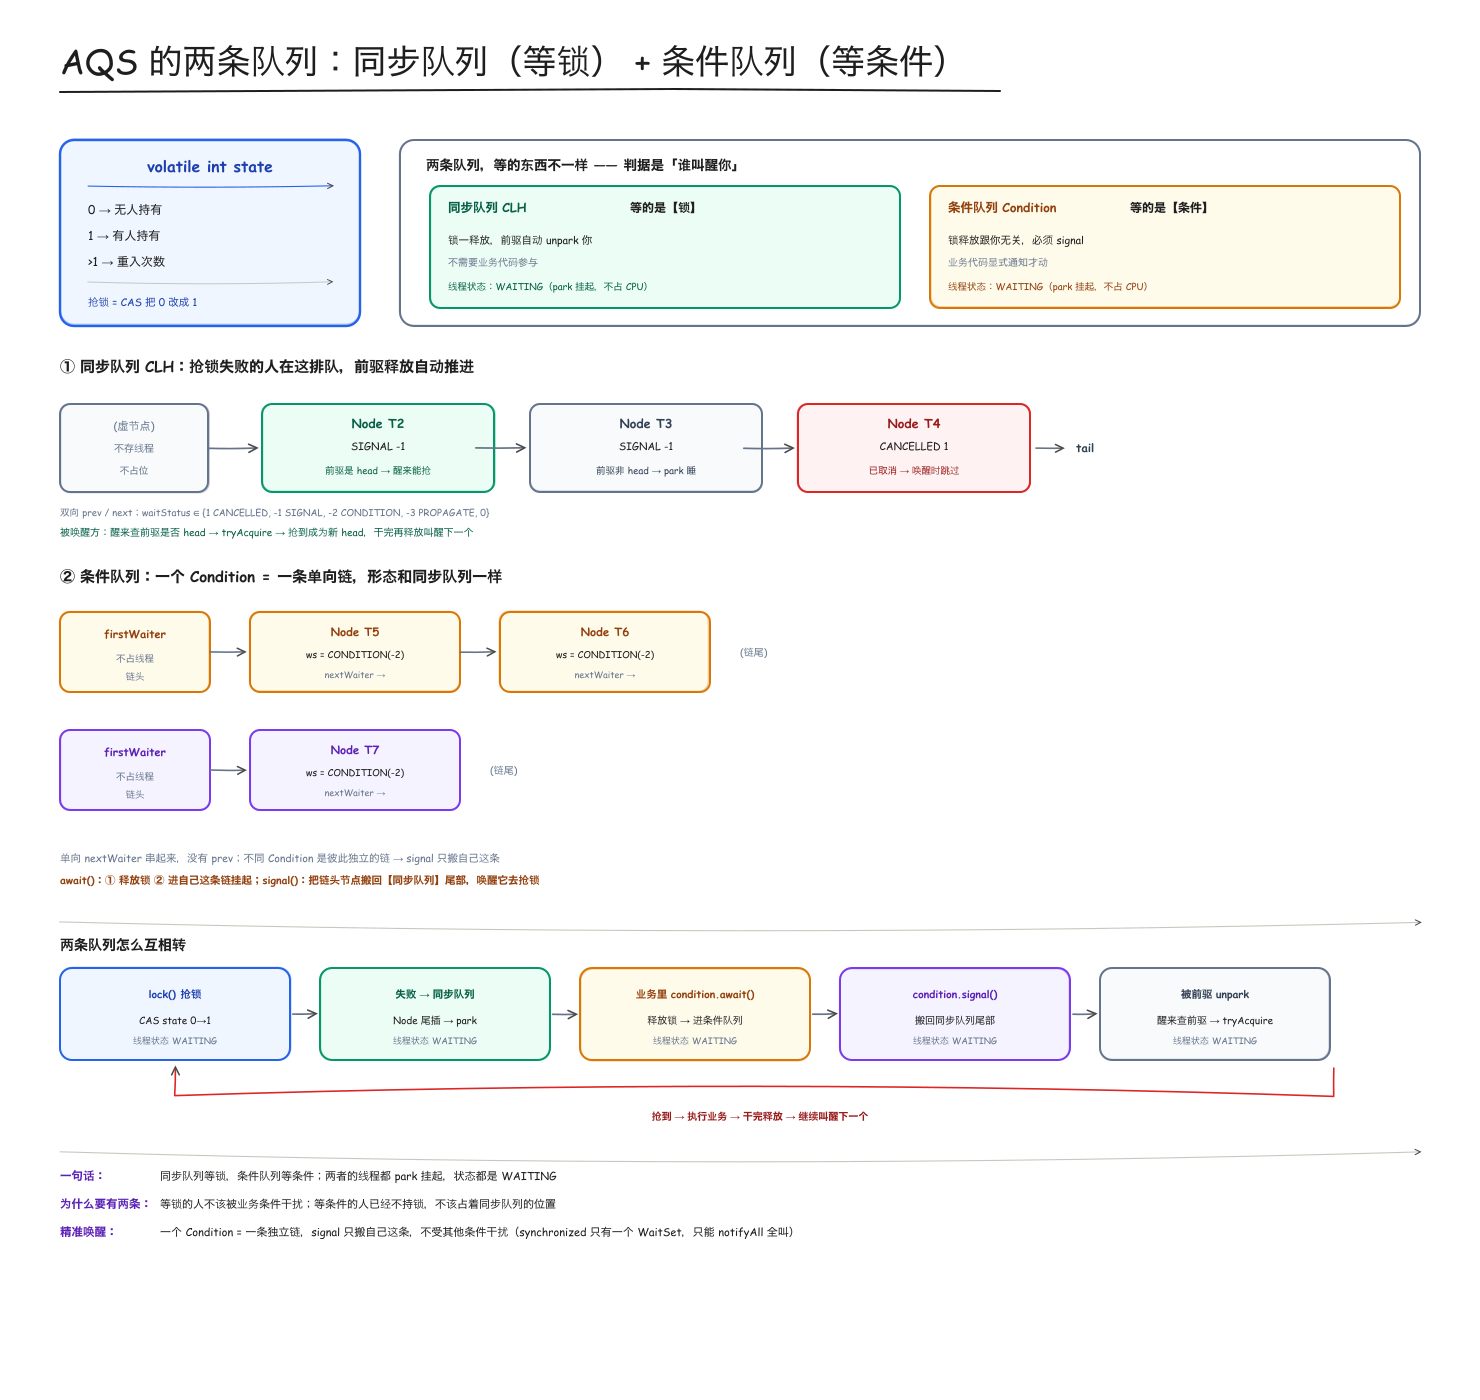
-
线程进来,尝试通过 CAS 修改 state 抢锁。
- 如果 state=0,CAS 改成 1,抢锁成功,线程正常执行业务逻辑。(非公平的体现)
- 如果 state>0,CAS 失败,线程竞争失败,被封装为 Node 节点,通过 CAS 自旋插入到同步队列尾部。
-
入队后:线程调用
LockSupport.park()挂起,不轮询、不自旋、不持续检查任何状态,完全不占 CPU。只有当前驱节点释放锁、调用
unpark唤醒它时,线程才醒来检查一次前驱是否为 head:- 是 head:说明前面已无排队者(自己就是队首之后第一个),调用
tryAcquire()尝试抢锁(仅一次 CAS,抢不到不空转) - 不是 head:说明前面还有人,直接再次
park()继续挂起
- 是 head:说明前面已无排队者(自己就是队首之后第一个),调用
-
持有锁的线程执行完毕,调用
unlock()→tryRelease把 state 减到 0;unparkSuccessor()从 head 往后找第一个waitStatus <= 0的有效节点(跳过 CANCELLED),调用LockSupport.unpark()只叫醒这一个。 -
被唤醒的线程醒来检查前驱是否 head、再
tryAcquire抢锁;抢到就把自己设为新 head(旧 head 出队)、把 state 改成 1,然后执行业务。 -
这个线程干完再释放、再唤醒下一个,一环扣一环推下去,直到队列空了、锁无人持有。
一句话:通知方负责"叫一个",被唤醒方负责"确认自己是不是该动"——先唤醒,再检查,最后抢,全程不自旋。
完整链路:lock 抢锁 → 失败入队 → park 睡下 → 持有者释放 → unpark 叫醒 head.next → 醒来查前驱抢锁 → 抢到出队成为新 head → 干活 → 再释放叫醒下一个。
synchronized和ReetrantLock的区别
实现层面- synchronized Java 关键字,由 JVM 底层实现,属于隐式锁;依托对象头、监视器(Monitor)工作。
- ReentrantLock JDK 提供的 API 显示锁,底层基于 AQS 独占模式。
- synchronized 可修饰代码块、方法;进入作用域自动加锁,退出 / 发生异常自动释放锁,不会出现锁泄漏。
- ReentrantLock 手动调用 lock() 加锁、unlock() 解锁;unlock 必须放在 finally 代码块,否则异常会导致锁无法释放。
- 可重入:两者都支持可重入,同一线程多次加锁不会死锁。
- 公平:synchronized 只支持非公平锁;ReentrantLock 可构造指定公平 / 非公平模式,默认非公平。
- 唤醒粒度:synchronized 依靠 wait/notify/notifyAll,仅有单个等待集合,唤醒粒度粗; ReentrantLock 可创建多个 Condition 条件队列,await/signal实现精准分组唤醒。
- JDK 1.6 之前:synchronized 为重量级锁,性能远落后于 ReentrantLock。
- JDK 1.6 及之后:JVM 引入锁升级(偏向锁→轻量级锁→重量级锁),两者性能基本持平。
CAS
思路:概念 → 原理 → 执行流程 → 自旋 → ABA问题
概念CAS(Compare And Swap,比较并交换)是一种无锁的原子操作,也是乐观锁的一种实现方式。
需要注意的是:
- CAS 保证的是单个共享变量的原子操作。
- 无法像 synchronized、ReentrantLock 一样保证整个代码块或多个共享变量的原子性。
(乐观锁是一种思想,CAS 和版本号都是乐观锁的实现方式。之所以称为”乐观”,是因为它假设线程之间发生冲突的概率较低,因此不加锁,而是在更新数据时检测是否发生冲突。与之对应,Java 中的 synchronized、ReentrantLock,以及 MySQL 中的行锁都属于悲观锁。)
执行流程
- 线程先读取共享变量的当前值,并保存为预期值(Expected)。
- 执行 CAS 时,CPU 会再次读取共享变量的当前值,并与线程保存的预期值进行比较。
- 如果两者相等,说明共享变量在此期间没有被其他线程修改,则以原子方式将共享变量更新为新值。
- 如果两者不相等,说明共享变量已经被其他线程修改,本次更新失败,通常会重新读取最新值并再次执行 CAS(CAS + 自旋)。
整个比较和更新过程由 CPU 一条原子指令完成,中间不会被其他线程打断。
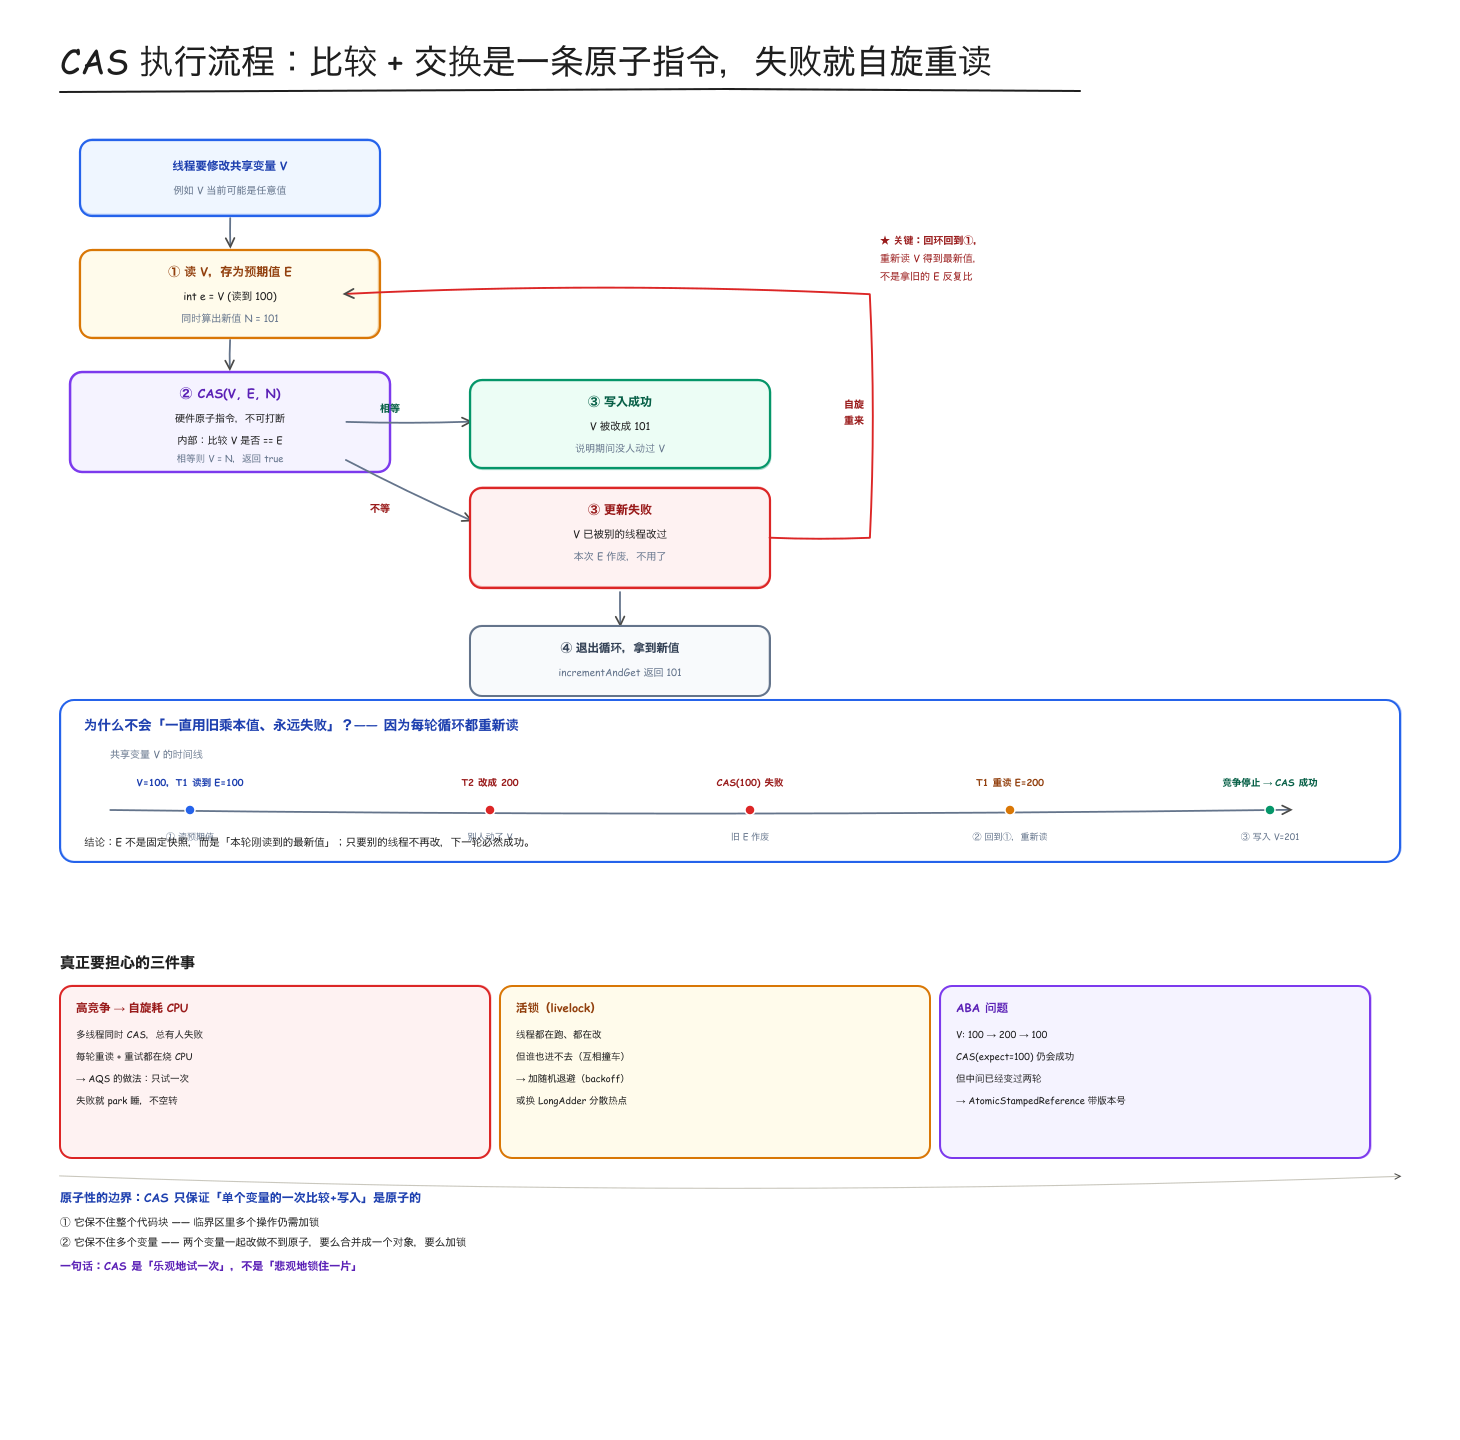
关键澄清:预期值不是固定快照。
第 4 步的"重新读取最新值"很重要——真实代码的 for(;;) 里,每一轮都会重新 get() 一次,把预期值刷新成本轮读到的最新值:
public final int incrementAndGet() {
    for (;;) {
        int current = get();              // 每轮都重新读,不是只读一次
        int next = current + 1;
        if (compareAndSet(current, next)) // 用刚读到的值当预期值
            return next;
    }
}
所以不会出现"拿最初的旧值反复比较、永远失败"的情况。真正需要警惕的是另外三件事:高竞争下自旋烧 CPU、活锁(互相撞车谁也进不去)、ABA(值改回原样,CAS 察觉不到)。
自旋
CAS 更新失败时,并不会立即阻塞线程,而是不断重新读取最新值,再次执行 CAS 操作,直到成功。
这个不断重试的过程称为自旋(Spin)。
这种方式避免了线程阻塞和唤醒带来的上下文切换,因此在低竞争场景下性能较高。
但如果竞争过于激烈,大量线程不断自旋,会持续占用 CPU,因此 CAS 并不适合高竞争场景。
ABA 问题
CAS 的经典问题就是 ABA 问题。
概念CAS 只比较当前值是否等于预期值,而不会关心这个值在中间是否被其他线程修改过。
例如:
银行账户余额初始为 100 元。
- 线程 A 读取余额为 100 元,准备通过 CAS 将余额修改为 0 元。
- 此时线程 A 被挂起。
- 线程 B 先存入 100 元,余额变为 200 元;随后又取出 100 元,余额重新变回 100 元。
- 线程 A 恢复执行,发现余额仍然是 100 元,于是 CAS 更新成功。
虽然余额最终仍然是 100 元,但它已经不是线程 A 最初读取时的那个状态了,中间实际上发生过两次修改。
如果业务要求数据在操作期间不能被其他线程修改,那么这次更新本应失败,但 CAS 无法识别,因此产生了 ABA 问题。
解决方案
解决 ABA 问题的方法是使用 AtomicStampedReference。
它在数据之外增加了一个版本号(Stamp)。
每次修改数据时:
- 数据更新;
- 版本号同时递增。
CAS 时不仅比较数据,还会比较版本号。
ThreadLocal
底层结构它并不是保证共享变量的原子性,而是通过线程隔离规避并发竞争。
底层每个线程内部都会维护一个专属的ThreadLocalMap,key为当前 ThreadLocal 对象本身,value为存储的数据。每个线程只能操作自己的副本,线程之间互不干扰,从根源上解决多线程竞争问题。
而不是ThreadLocal对象本身是一个Map。
Thread
  └─ ThreadLocalMap
       ├─ Entry1
       │    ├─ key:   ThreadLocal对象A
       │    └─ value: 数据A
       ├─ Entry2
       │    ├─ key:   ThreadLocal对象B
       │    └─ value: 数据B
       └─ Entry3
            ├─ key:   ThreadLocal对象C
            └─ value: 数据C
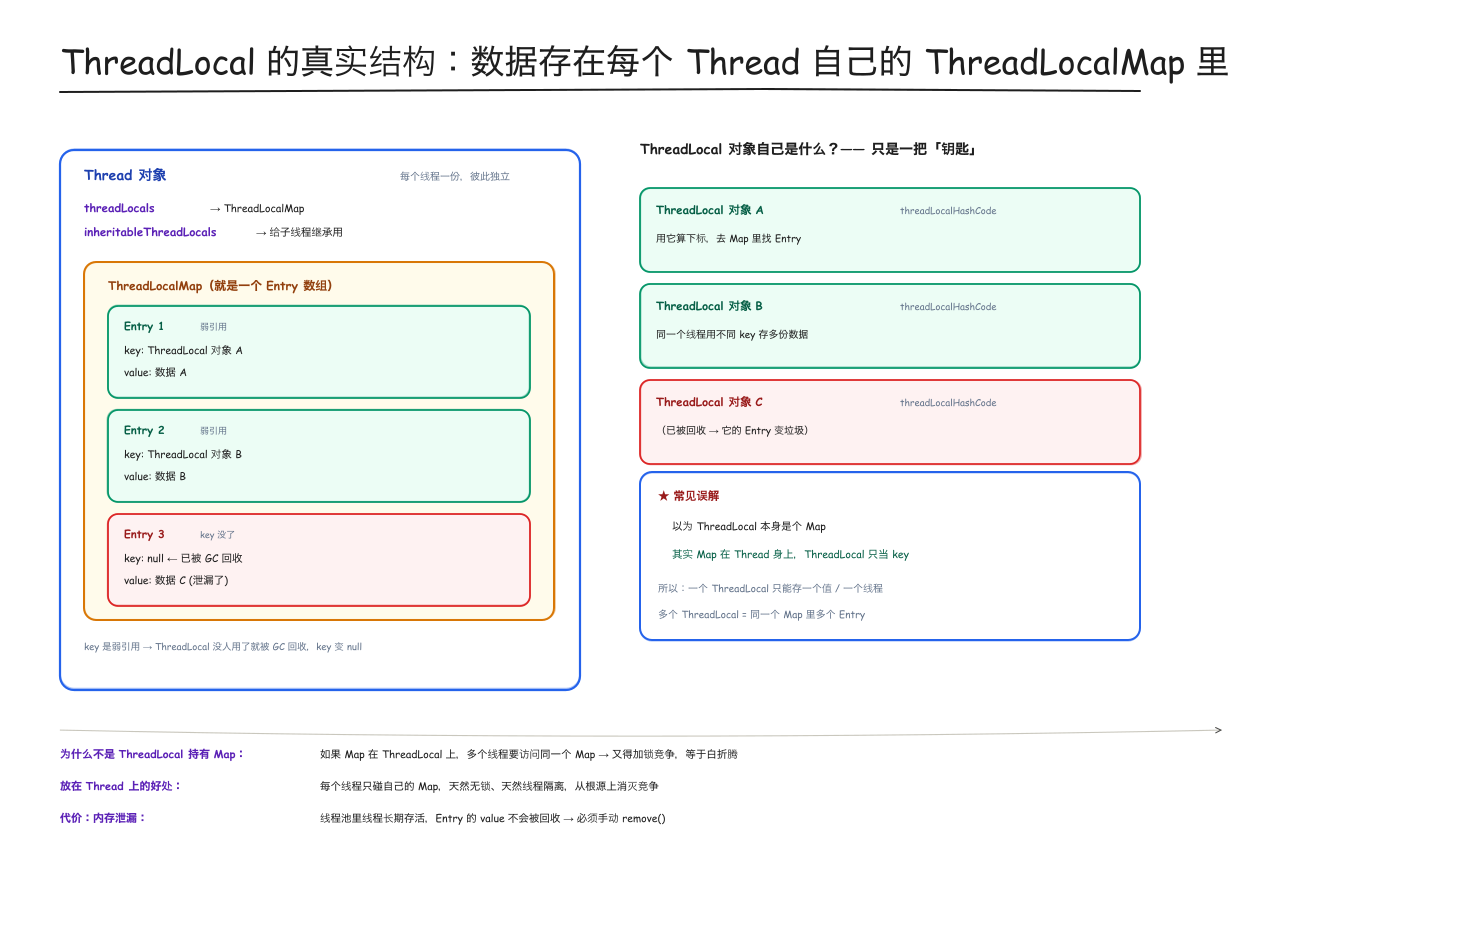
正确理解:ThreadLocal 对象自己只是一把「钥匙」,真正的数据存在 Thread 身上的 ThreadLocalMap 里。所以一个 ThreadLocal 在一个线程里只能存一个值,多个 ThreadLocal 就是同一个 Map 里的多个 Entry。
最核心的隐患。
ThreadLocalMap 的 Entry 继承自 WeakReference。
- Key (ThreadLocal):是弱引用。
- Value (数据):是强引用。
- 假设你在方法里定义了一个 ThreadLocal,用完后方法结束了,栈上的引用断开了。
- GC 发生时:因为 Key 是弱引用,ThreadLocal 对象会被回收,Key 变成了 null。
- 僵尸对象:此时 Map 里出现了一条 [null : Value] 的记录。
- 问题:虽然 Key 没了,但 Value 还在!而且因为线程(Thread)本身还没结束(比如在线程池里),Thread 引用着 Map,Map 引用着 Entry,Entry 引用着 Value。
- 结果:这个 Value 永远无法被访问(Key 是 null),但也永远无法被 GC 回收。这就是内存泄漏。
务必遵守“谁使用,谁清理”的原则。
在使用完 ThreadLocal 后,必须显式调用 remove()方法。
try { userContext.set(currentUser); // 执行业务逻辑 } finally { // 必须清理,防止内存泄漏和线程池复用导致的数据污染 userContext.remove(); }
可见性
synchronized,ReentrantLock,volatile都能保证,这里主要说volatile。
volatile
当volatile修饰的变量被线程修改后,会立即刷新回主内存,同时让其他线程工作内存中的该变量副本失效,其他线程下次读取时必须重新从主内存加载最新值,解决多线程间变量不可见的问题。
有序性
synchronized,ReentrantLock,volatile都能保证,这里主要说volatile。
volatile
CPU和编译器为了提升执行效率会进行指令重排序,多线程下重排序会引发逻辑错乱。volatile通过内存屏障禁止特定指令重排序,保障代码执行顺序符合预期。
指令重排序CPU 和编译器为了提高执行效率,默认是允许指令重排序的。
重排序会遵循一个原则:不能改变单线程程序的执行结果(as-if-serial 语义)。因此,在单线程下通常没有问题,但在多线程环境下,如果一个线程提前看到了另一个线程尚未完全初始化的数据,就可能出现线程安全问题。
经典问题:双重检查锁实现单例模式public class Singleton {
private static volatile Singleton instance;
public static Singleton getInstance() {
if (instance == null) {
// A B C
synchronized (Singleton.class) {
//C
if (instance == null) {
instance = new Singleton();
// 这一步非原子操作,实际可以拆为三步:
// 1. 分配对象内存。
// 2. 调用构造方法,初始化对象。
// 3. 将 instance 指向这块内存。
}
}
}
return instance;
}
}
正常情况下1-2-3,指令重排序的时候1-3-2;
现在线程 A 执行到第 3 步,还没来得及初始化对象,线程 B 调用 getInstance(),发现:instance != null,就会直接返回这个对象。但是实际上对象还没有初始化完成,那么使用的时候就可能会就可能抛出 NullPointerException。
补充:双重检查锁的目的?
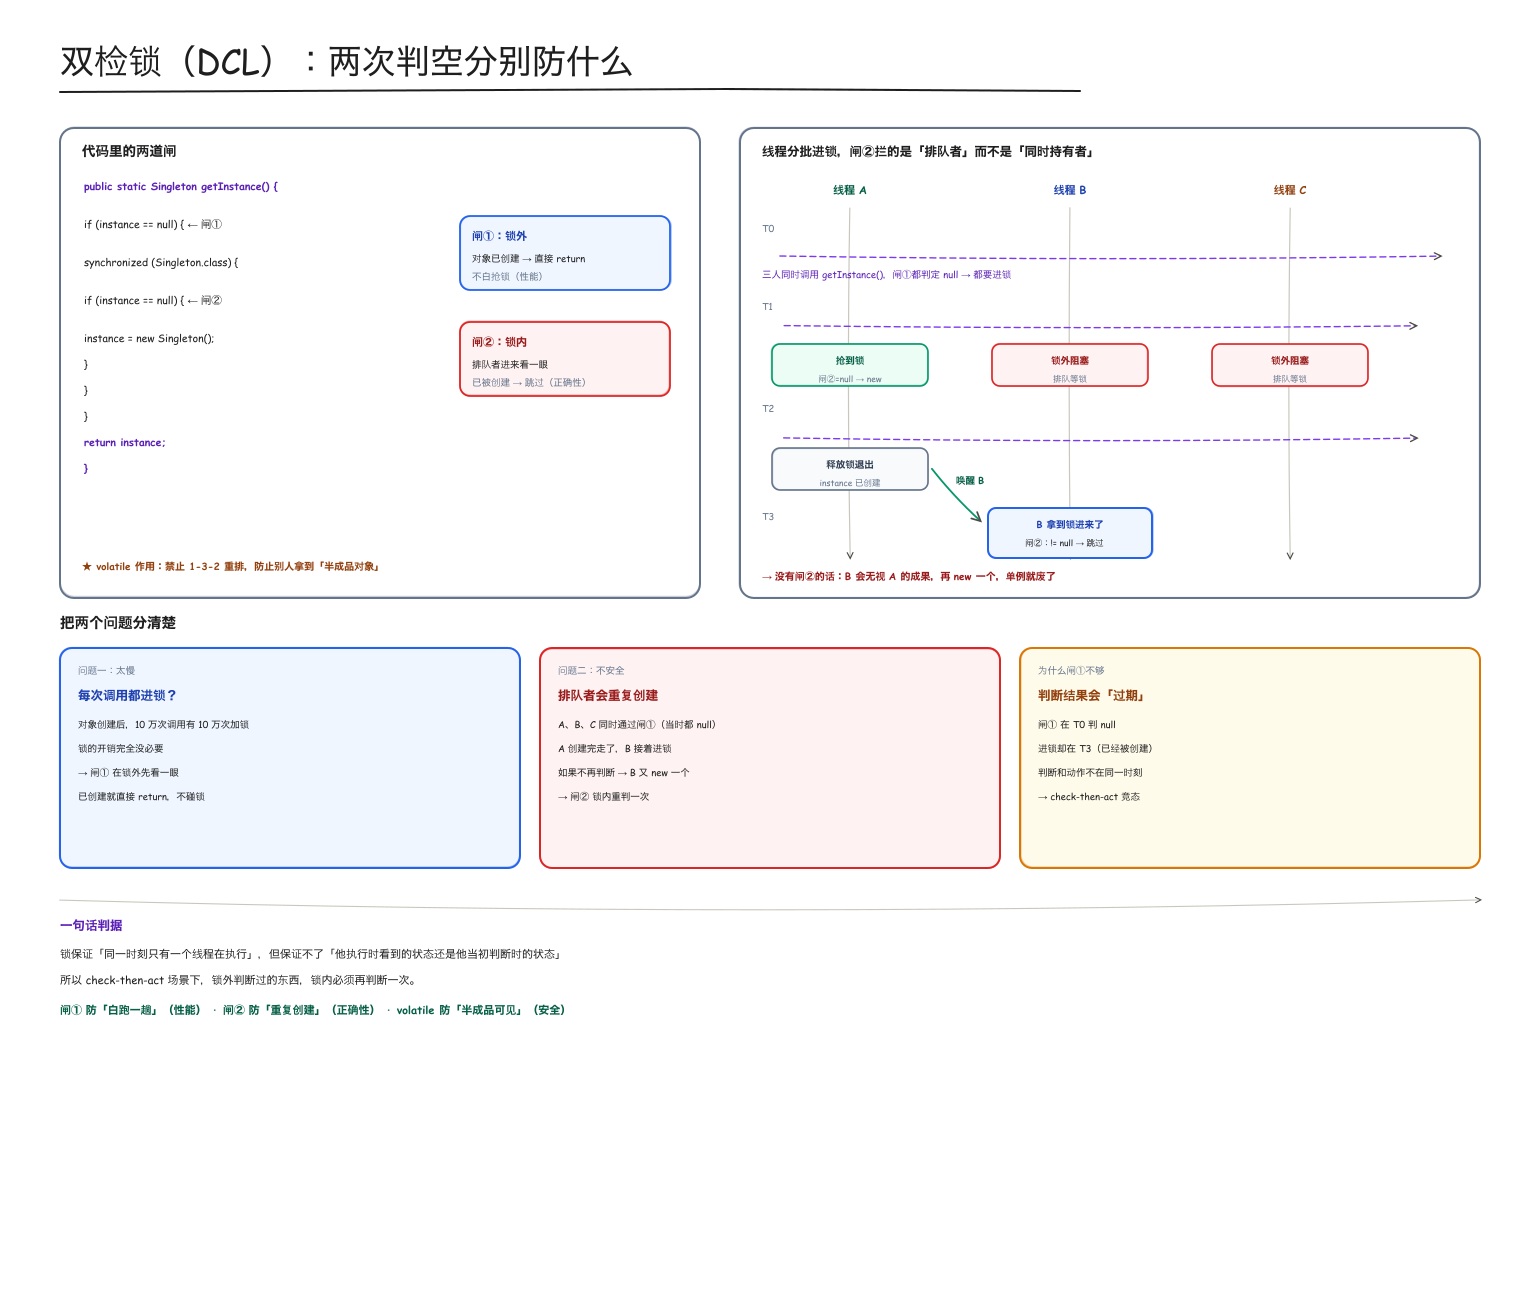
双重检查锁的目的,是既保证线程安全,又减少加锁开销。
具体来说:
- 第一次 if (instance == null):避免每次获取单例都进入 synchronized,对象创建完成后,大部分请求都会直接返回,提高性能。
- 第二次 if (instance == null):防止排队等锁的线程进来后重复创建。注意它防的不是"同时持有锁"——持有锁的永远只有一个;防的是"当初都通过了第一次判空、此时在锁外排队的线程",第一个线程创建完释放锁后,它们会依次进锁,必须再确认一次。
关键区分:第一次判空防的是"白跑一趟"(性能),第二次判空防的是"重复创建"(正确性),volatile 防的是"半成品对象被看到"(安全)。
为什么第一次判空不够:它的判断结果会过期。A、B、C 在 T0 同时判 null 都成立,但 B 实际进锁是在 T3(此时已被创建)。锁只能保证"同一时刻一个人执行",保证不了"他执行时看到的状态还是当初判断时的状态"——这就是 check-then-act 竞态。
死锁、活锁、饥饿
多线程竞争锁时,容易出现三类典型问题:
- 死锁
多个线程互相持有对方需要的锁,并且无限等待对方释放锁。
死锁四大必要条件(同时满足才会产生,破坏任意一个即可解决):互斥、请求并持有、不可剥夺、循环等待。
- 资源互斥-资源只能给一个线程
- 请求保持-已经持有但不释放继续申请新的资源
- 不可剥夺-不能被其他线程抢夺,除非主动释放
- 循环等待-多个线程互相等待对方持有的资源
生产环境排查:使用jps查看Java进程PID,再通过jstack 进程PID打印线程栈,定位死锁线程。
- 活锁
线程不会阻塞,但会不断主动释放资源、互相谦让,反复轮询却始终无法执行业务代码,线程一直处于运行态。
- 饥饿
部分线程长期无法获取CPU资源和锁资源,一直得不到执行机会。大多出现在非公平锁、线程优先级设置不合理的场景中。
线程协作
线程之间除了竞争(锁),还要协作(等待 / 汇合 / 限流)。JUC 提供了四类协作工具,前三个基于 AQS,Exchanger 基于 CAS:
CountDownLatch(倒计时门闩)
计数器递减,一个线程等待多个线程执行完成,计数器归0后唤醒等待线程,一次性使用,不可复用。
CyclicBarrier(循环屏障)
多个线程互相等待,直到所有线程都到达屏障点后,再统一执行后续逻辑,支持循环复用。
Semaphore(信号量)
通过许可证机制控制最大并发线程数,常用于接口限流、数据库连接池等场景。
Exchanger(交换器)
用于两个成对线程之间交换数据,一个线程等待另一个线程到达后,互相传递数据。
线程安全集合
HashMap 的数据结构
先说清 HashMap 自己,再谈谁替代它——因为 ConcurrentHashMap 1.8 的结构和 HashMap 完全一致。
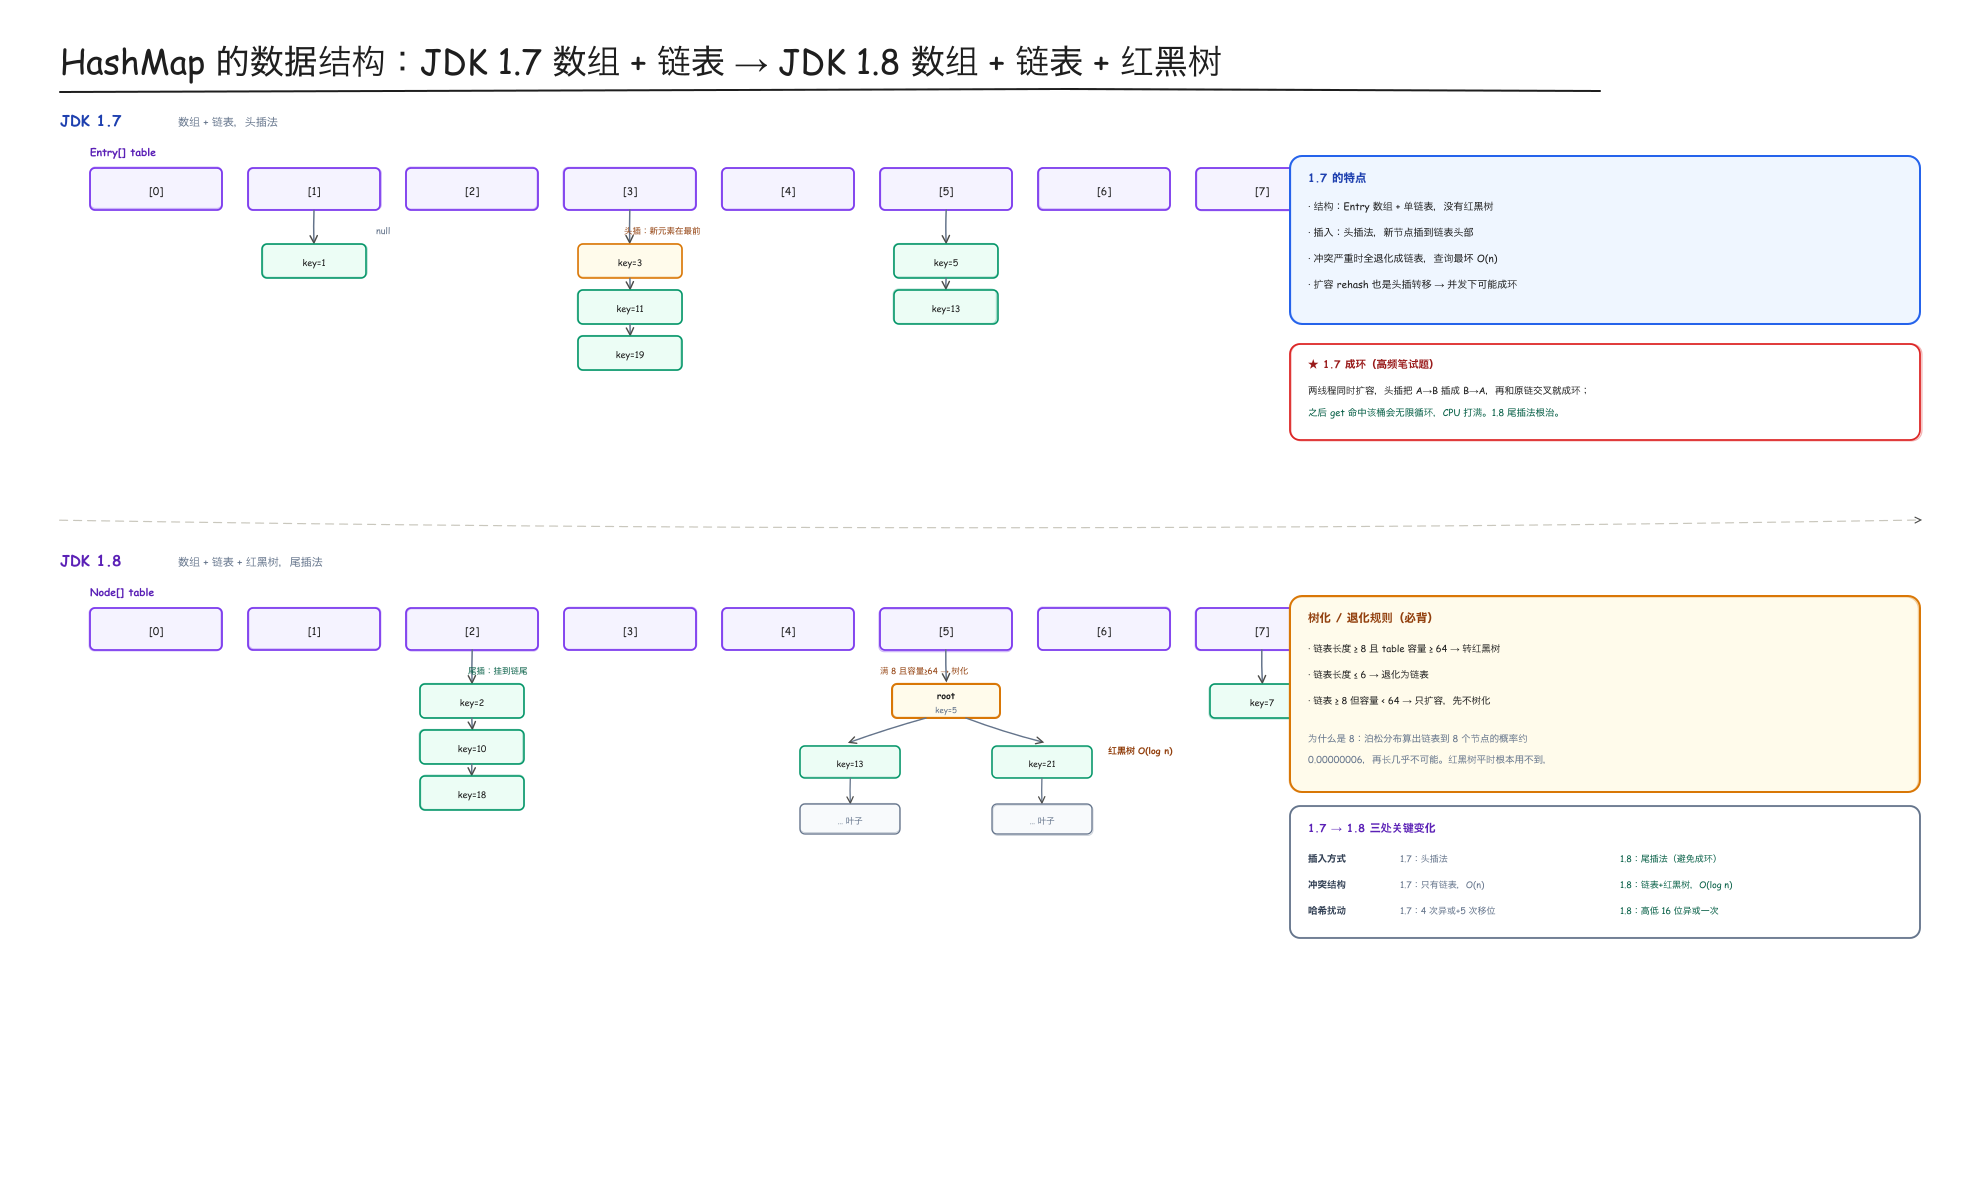
JDK 1.7:数组 + 链表(头插法)
数组每个槽位叫一个桶(bucket),冲突的元素挂成一条单链表,新元素插在链表头部。
JDK 1.8:数组 + 链表 + 红黑树(尾插法)
冲突少时还是链表;链表长度 ≥ 8 且数组容量 ≥ 64 时转红黑树,长度 ≤ 6 时退化为链表。链表 ≥ 8 但容量 < 64 时只扩容不树化。
为什么阈值是 8:按泊松分布,链表长度达到 8 的概率约 0.00000006,再长几乎不可能。所以红黑树平时根本用不到,它只是极端冲突下的兜底——但把最坏查询从 O(n) 降到 O(log n)。
1.7 → 1.8 三处关键变化:
| 变化点 | 1.7 | 1.8 |
|---|---|---|
| 插入方式 | 头插法 | 尾插法(避免并发扩容成环) |
| 冲突结构 | 只有链表,最坏 O(n) | 链表 + 红黑树,最坏 O(log n) |
| 哈希扰动 | 4 次异或 + 5 次移位 | 高 16 位异或低 16 位(一次) |
1.7 成环是怎么回事(高频笔试题):两个线程同时扩容,头插法会把 A→B 插成 B→A,再和原链交叉就形成环;之后 get 命中这个桶会无限循环,CPU 打满。1.8 改成尾插法,从根上消除了这个问题。
为什么 HashMap 不安全
并发 put 可能覆盖数据、扩容时链表成环(JDK1.7 头插法)、size 计算不准。所以多线程下必须换用线程安全集合。
ConcurrentHashMap
ConcurrentHashMap是高并发场景下替代HashMap的线程安全集合,JDK不同版本实现差异很大:
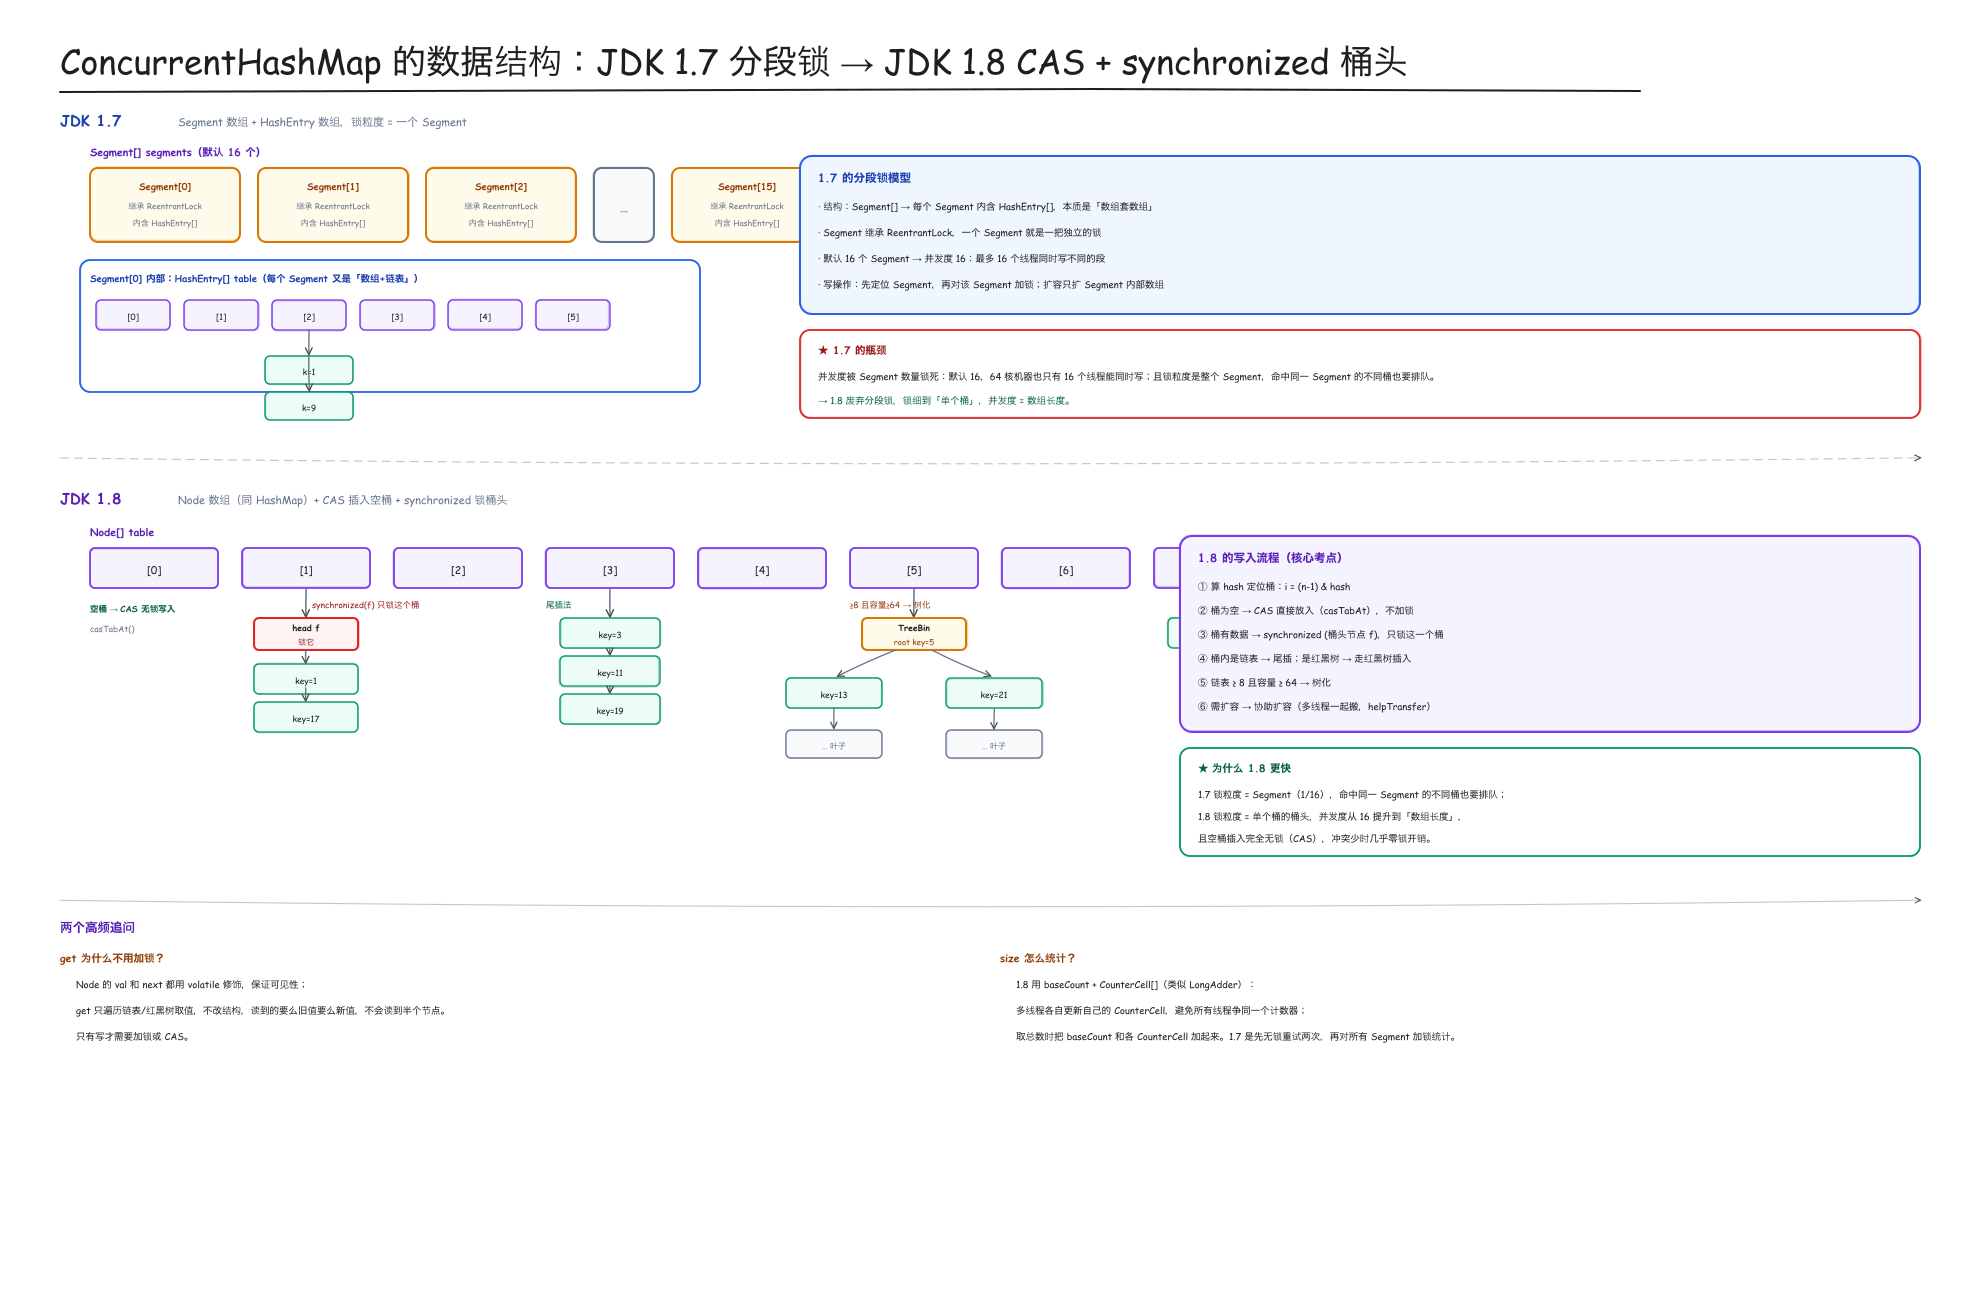
- JDK1.7:数据结构为数组+链表,采用Segment分段锁,默认划分16个分段,锁的粒度为一个Segment,并发度有限。
- JDK1.8:废弃分段锁,数据结构升级为数组+链表+红黑树,和HashMap结构一致;锁粒度优化为数组桶的头节点:
◦ 桶位为空:使用CAS无锁插入数据;
◦ 桶位已有数据:使用synchronized锁定桶头节点,保障并发安全。
树化规则:链表长度 ≥8 且数组容量 ≥64 时,链表转为红黑树;链表长度 ≤6 时,红黑树退化为链表。
锁粒度大幅降低,并发性能远优于1.7版本。
三、线程池
思路:为什么需要线程池 → 七大核心参数 → 执行流程 → 阻塞队列 → 拒绝策略 → 常见线程池 → Executors为什么不推荐
1. 为什么需要线程池?
池化思想:频繁创建、销毁线程会带来巨大开销,工程中统一使用线程池管理线程。
2. 七大核心参数
核心线程数、最大线程数、非核心线程空闲超时时间、时间单位、阻塞队列、线程工厂(工厂模式创建对象)、拒绝策略。
3. 核心线程数配置参考
• CPU密集型任务:建议设置为 CPU核心数 + 1,充分利用CPU,预留一个线程兜底;
• IO密集型任务:线程大量时间阻塞在IO操作上,建议设置为 CPU核心数 * 2;
注:以上仅为参考值,最终需结合线上压测调整。
4. 线程池执行流程
- 提交新任务,当前线程数 < 核心线程数 → 创建核心线程执行任务;
- 核心线程已满 → 任务存入阻塞队列;
- 队列已满 → 创建非核心线程执行任务;
- 总线程数达到最大线程数 → 触发拒绝策略;
- 非核心线程空闲超过指定时长,自动销毁,仅保留核心线程。
5. 四种阻塞队列
每种队列的底层结构决定了它的特性,记结构就记住了全部:
- ArrayBlockingQueue → 数组 → 唯一一个强制有界,FIFO
- LinkedBlockingQueue → 链表 → 无界(默认 Integer.MAX_VALUE,可指定容量),FIFO
- SynchronousQueue → 不存储元素,容量为 0 → 同步阻塞,生产一个必须消费一个,
CachedThreadPool就用的它 - PriorityBlockingQueue → 堆 → 无界,按优先级出队(不是 FIFO)
6. 四大拒绝策略
AbortPolicy(默认):直接拒绝任务,并抛出运行时异常;
DiscardPolicy:静默丢弃任务,不抛出任何异常;
DiscardOldestPolicy:丢弃队列中最旧(队头)的任务,并把新任务放到队尾;
CallerRunsPolicy:将任务回交给提交任务的调用者线程执行。
7. 四种线程池:都是反面教材
Executors 提供的四个工厂方法,阿里开发规约明确禁止使用。原因不用记实现,只需记住一句话:四个都有"无界"隐患,无界就是 OOM 或线程爆炸。
| 工厂方法 | 核心/最大线程 | 队列 | 致命伤 |
|---|---|---|---|
newFixedThreadPool |
n / n | LinkedBlockingQueue | 队列默认 Integer.MAX_VALUE → 任务堆积 → Heap OOM |
newSingleThreadExecutor |
1 / 1 | LinkedBlockingQueue | 同上,且只有一个线程,处理更慢 → 积压更快 |
newCachedThreadPool |
0 / Integer.MAX_VALUE |
SynchronousQueue | 线程数无上限,来多少任务建多少线程 → CPU 100% / OOM |
newScheduledThreadPool |
core / Integer.MAX_VALUE |
DelayedWorkQueue | 双重风险:最大线程无界 + 任务队列无界 |
记忆要点:判断一个线程池安不安全,只看两个参数——最大线程数是否有限、队列是否有界。四个全部踩雷。
规范做法:手写 new ThreadPoolExecutor(...),七个参数全部自己指定,队列用有界队列,拒绝策略明确。
// 生产可用的写法
ThreadPoolExecutor pool = new ThreadPoolExecutor(
    8,                                          // 核心线程数
    16,                                         // 最大线程数(必须有界)
    60L, TimeUnit.SECONDS,                      // 非核心线程空闲存活时间
    new ArrayBlockingQueue<>(200),              // 有界队列(关键)
    new ThreadFactoryBuilder().setNameFormat("order-pool-%d").build(),
    new ThreadPoolExecutor.CallerRunsPolicy()   // 拒绝策略,明确指定
);
面试延伸:
newFixedThreadPool的唯一用处是"教学对照",让你讲清无界队列的危害。真实项目一律手写。
8. 线程池最佳实践
合理设置线程数
CPU密集型任务- 线程数 = CPU核心数 + 1
- 避免过多线程导致上下文切换
- 线程数 = CPU核心数 * 2
- 或使用公式:线程数 = CPU核心数 / (1 - 阻塞系数)
- 阻塞系数通常在0.8-0.9之间
- 尽可能拆分为CPU密集型和IO密集型
- 分别使用不同的线程池
根据单个任务执行的平均时长 配置你的并发的数量 计算 判断出最合理的线程数
但这只是估计,实际还要进行压测。
合理设置队列大小
- 不要使用无界队列,容易OOM
- 根据业务特点设置合理的队列容量
- 考虑使用有界队列 + 合理的拒绝策略(推荐做法)
自定义线程工厂
- 设置有意义的线程名称,便于排查问题
- 设置合理的优先级
- 设置UncaughtExceptionHandler处理异常
线程池中的异常怎么处理
我们在自定义线程池的时候 然后使用了自定义的异常拦截器 ,这种处理方式仅限于 execute 方式提交任务
ThreadFactory factory = new ThreadFactoryBuilder()
    .setNameFormat("my-pool-%d")
    .setDaemon(false)
    .setPriority(Thread.NORM_PRIORITY)
    .setUncaughtExceptionHandler((t, e) -> {
        log.error("线程" + t.getName() + "发生异常", e);
    })
    .build();
异常处理
executeexecute 这种方式提交的任务如果抛出了异常 执行任务的子线程会因为异常退出 控制台会有报错
但是也仅仅是会结束这个线程的生命周期 线程池会创建一个新的线程来替补 主线程是无法感知的
package com.lyf;
import java.util.concurrent.*;
public class Demo1_Execute_NoHandling {
    public static void main(String[] args) {
        // 创建一个固定大小为1的线程池,方便观察线程名称的变化
        ExecutorService pool = Executors.newFixedThreadPool(1);
        System.out.println("=== 1. 使用 execute 提交,不处理异常 ===");
        // execute 这种方式添加的任务 是没有返回值
        // 线程池内部会捕获异常并打印到控制台,但不会影响线程池中的线程继续工作
        // 子线程中的异常不会传递到主线程
        // 子线程中的异常是不能向上抛到主线程的
        pool.execute(() -> {
            System.out.println("线程 [" + Thread.currentThread().getName() + "] 开始执行任务...");
            // 模拟异常
            int i = 1 / 0;
        });
        // 稍微等待一下,让子线程先跑
        try {
            Thread.sleep(100);
        }
        catch (InterruptedException e) {
        }
        // 再次提交一个任务,观察线程名称是否改变(如果改变,说明上一个线程因为异常死掉了)
        pool.execute(() -> {
            System.out.println("线程 [" + Thread.currentThread().getName() + "] 执行第二个任务(注意看线程名是否变了)");
        });
        pool.shutdown();
    }
}
submit这种方式提交的任务 也会抛出异常 但是异常会被吞没 静悄悄的失败
没有任何报错信息 因为异常被捕获并封装到了Future对象中 如果你不主动去调用 get()方法 这个异常就永远消失了
package com.lyf;
import java.util.concurrent.*;
public class Demo2_Submit_NoHandling {
    public static void main(String[] args) {
        ExecutorService pool = Executors.newFixedThreadPool(1);
        System.out.println("=== 2. 使用 submit 提交,不处理异常 ===");
        // 提交任务
        // 通过submit提交的任务,如果不处理返回的 Future
        // 子线程中的异常同样不会传递到主线程
        // 主线程中是看不到子线程的异常的 也是无法感知的
        pool.submit(() -> {
            System.out.println("线程 [" + Thread.currentThread().getName() + "] 开始执行...");
            // 模拟异常
            int i = 1 / 0;
            System.out.println("这句话永远不会打印");
        });
        // 稍微等待,观察控制台
        try {
            Thread.sleep(1000);
        }
        catch (InterruptedException e) {
        }
        System.out.println("=== 主线程结束。你看到上面的异常报错了吗?没看到就是被吞了! ===");
        pool.shutdown();
    }
}
对应子线程中执行的任务我们可以手动进行 try catch 捕获异常
这种方式是最通用的 也是最推荐的 不区分是 execute submit 都可以使用
package com.lyf;
import java.util.concurrent.*;
public class Demo3_Handle_TryCatch {
    public static void main(String[] args) {
        ExecutorService pool = Executors.newFixedThreadPool(1);
        System.out.println("=== 3. 方式一:任务内部 Try-Catch ===");
        pool.execute(() -> {
            try {
                System.out.println("执行业务逻辑...");
                int i = 1 / 0;
                // 模拟异常
            }
            catch (Exception e) {
                // 自己处理异常,记录日志
                System.err.println(">>> 捕获到异常了: " + e.getMessage());
            }
        });
        pool.shutdown();
    }
}
优雅关闭
shutdown(推荐)温柔的关闭。不再接收新任务,但会把队列里已有的任务执行完才真正停止。
shutdownNow暴力的关闭。不再接收新任务,尝试中断正在执行的任务,并把队列里还没执行的任务返回给你。
9. JUC 全景图
Java 并发工具
├── 原子类 Atomic
│   ├── AtomicInteger
│   ├── AtomicLong
│   └── AtomicReference
├── 同步器
│   ├── CountDownLatch
│   ├── CyclicBarrier
│   └── Semaphore
├── 锁
│   ├── synchronized
│   ├── ReentrantLock
│   └── ReadWriteLock
└── 并发容器
    ├── ConcurrentHashMap
    ├── CopyOnWriteArrayList
    └── BlockingQueue
四类工具的分工:原子类解决单变量原子更新;同步器解决线程间协作(等齐 / 放行 / 汇合);锁解决临界区互斥;并发容器解决集合在多线程下的安全与性能。
四、异步编程
思路:Future → CompletableFuture
Java异步任务处理主要分为两个阶段:
Future / FutureTask
早期异步方案,虽然可以异步获取线程执行结果,但get()方法是阻塞调用,无法实现异步回调,也不支持任务链式组合。
sequenceDiagram
    participant M as 主线程
    participant W as 线程池工作线程
    M->>W: submit(Callable)
    Note over W: 执行任务,耗时 3 秒
    M->>M: 打印:主线程继续执行其他任务
    M->>M: 执行其他逻辑
    M->>M: future.get() 阻塞等待
    W-->>M: 任务完成,返回 100
    Note over M: get() 返回 100
submit() 提交任务后,主线程不需要等待任务执行完成。
- 工作线程在后台执行 Callable。
- 主线程可以继续执行其他逻辑。
- 只有当主线程调用
get(),且任务尚未完成时,主线程才会阻塞等待。
CompletableFuture(JDK1.8)
Future的增强实现,同时实现了CompletionStage接口。支持异步回调、链式调用、多任务串行/并行组合、异常处理,是目前Java异步编程的主流方案。
// 异步执行任务,返回一个 CompletableFuture
CompletableFuture<Integer> future = CompletableFuture.supplyAsync(() -> {
    System.out.println("执行任务");
    return 100;
});
future.thenAccept(result -> {
    // 表示任务完成后,触发后续的结果处理逻辑。
    System.out.println("异步处理结果:" + result);
});
System.out.println("主线程继续执行");
sequenceDiagram
    participant M as 主线程
    participant W as 线程池工作线程
    M->>W: supplyAsync(任务) 立即返回
    Note over W: 后台异步执行任务
    M->>M: 注册 thenAccept 回调,不阻塞
    Note over M: 主线程继续执行其他逻辑
    W-->>W: 任务完成,返回 100
    W->>M: 触发回调 thenAccept(100)
    Note over M: 打印:异步处理结果:100
这里主线程不需要调用 get(),也不需要阻塞等待结果。
当然,CompletableFuture 也有 get() 和 join(),它们仍然是阻塞式的结果获取方法。
CompletableFuture 的核心价值不是取消阻塞式 get,而是提供了任务完成后的回调、异步任务编排和组合能力。