LLM / Agent 推理链路延迟优化
核心问题:如何减少不必要的计算、重复计算以及串行等待,从而降低 Agent 整条推理链路的延迟。
优化主线:减少计算 × 减少等待 × 复用计算。
一、这是一个什么问题?
1.1 Agent 请求不是一次 LLM 调用
生产环境中的 Agent 请求,通常是一条完整的推理链路:
用户请求
   ↓
意图识别 / Router
   ↓
RAG 检索
   ↓
LLM 推理
   ↓
Tool / MCP 调用
   ↓
LLM 再次推理
   ↓
最终回答
尤其是在 Agent 场景中,一次请求可能触发:
- 多次 LLM 调用;
- 多次 Tool / MCP 调用;
- 多轮“推理 → 调工具 → 再推理”的循环。
1.2 用户感受到的是整条链路的累计延迟
总延迟
≈
LLM 推理
+ RAG
+ Tool / MCP
+ Agent 编排
+ 网络通信
+ 排队等待
因此,优化时不能只盯着单次模型调用,而要观察整条链路中:
- 哪些计算是不必要的;
- 哪些计算被重复执行了;
- 哪些步骤本来可以并行,却仍然串行等待。
1.3 优化目标
减少不必要的计算、重复计算以及串行等待,降低 Agent 端到端延迟。
二、从哪些方面解决?
整体可以拆成三个方向:
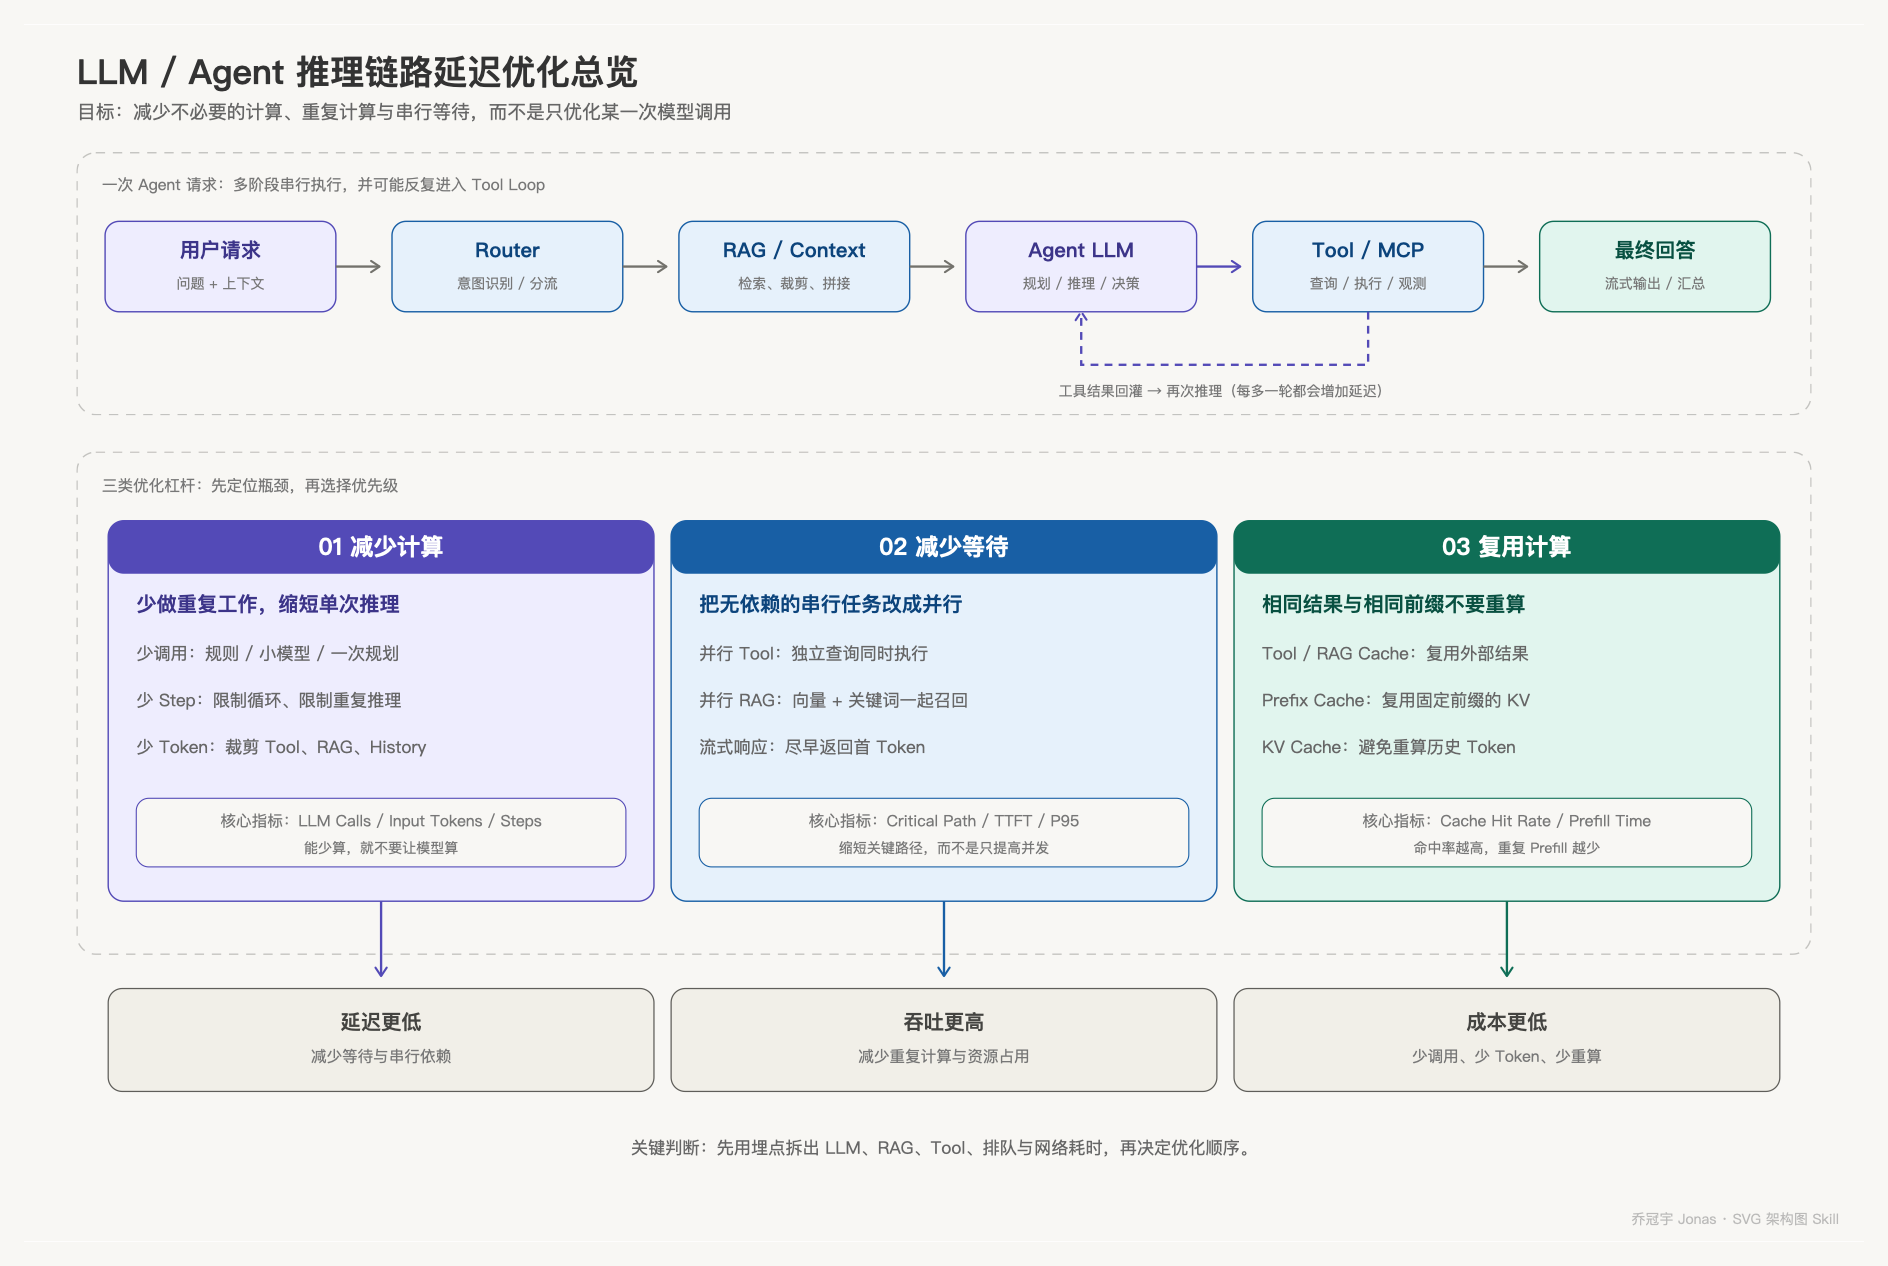
图 1:Agent 推理链路的典型执行路径,以及“减少计算、减少等待、复用计算”三类优化杠杆。
| 优化方向 | 核心目标 | 常见手段 | 重点关注指标 |
|---|---|---|---|
| 减少计算 | 让每一步少算、少调用 | 规则、小模型、限制 Step、裁剪 Context | LLM Calls、Input Tokens、Steps |
| 减少等待 | 缩短关键路径 | Tool 并行、RAG 并行、流式输出 | Critical Path、TTFT、P95 |
| 复用计算 | 相同结果不要重算 | Tool Cache、RAG Cache、Prefix / KV Cache | Cache Hit Rate、Prefill Time |
2.1 减少计算量
核心思想:
调用次数 × 输入 Token 数。
能少计算,就不要让模型计算。
2.1.1 减少 LLM 调用和 Agent Step
例如,原本需要经过多次 LLM 调用:
Router LLM
   ↓
Query Rewrite LLM
   ↓
Reranker LLM
	 ↓
Agent LLM
   ↓
Tool
   ↓
Agent LLM
如果能通过规则、小模型或者一次规划解决,就可以减少不必要的 LLM 调用。
同时要控制 Agent 的:
- 推理 Step;
- Tool Call 次数;
- 无意义循环;
- 重复推理。
因为每增加一次:
LLM → Tool → LLM
都会增加额外延迟。
2.1.2 减少输入 Token
LLM 每次推理都需要处理输入 Context,因此 Prompt 越长,Prefill 的计算量通常越大。
生产环境常见的 Context 裁剪方式:
Tool Schema
    ↓
只保留相关 Tool

Conversation
    ↓
摘要 / 截断

RAG
    ↓
控制 TopK + 去重TopN

Prompt
    ↓
精简固定指令
本质上就是:
让模型每次少读一些东西。
2.2 减少等待时间
有些延迟并不是“计算慢”,而是因为系统在串行等待。
2.2.1 Tool 并行
串行执行:
Tool A
 ↓
Tool B
 ↓
Tool C
如果三个 Tool 互相没有依赖关系,就可以改成并行:
        ┌→ Tool A ─┐
Agent ──┼→ Tool B ─┼→ 汇总
        └→ Tool C ─┘
目标是缩短关键路径,而不是简单把多个节点放进同一个执行阶段。
2.2.2 RAG 并行
同样,在 RAG 中:
Vector Search
Keyword Search
如果没有依赖关系,也可以并行执行。
2.2.3 适用判断
适合并行的任务通常满足:
- 输入相互独立;
- 执行过程不依赖其他任务的结果;
- 最终只在下游统一汇总。
因此,生产系统经常会把:
没有依赖关系的任务从串行改成并行。
这类优化对 Agent 特别重要,因为 Agent 本身就是一个由多个步骤组成的执行链。
2.3 复用已经计算过的结果
核心思想:
相同的东西不要重复计算。
最常见的是缓存。整体可以沿这条链路理解:
Prefill → KV Cache → Prefix Cache → Decode
其中,“提高缓存命中率”主要是在提高 Prefix Cache / KV Cache 的复用率,从而减少重复 Prefill 计算。
2.3.1 Prefill 与 Decode 是大模型生成的两个阶段
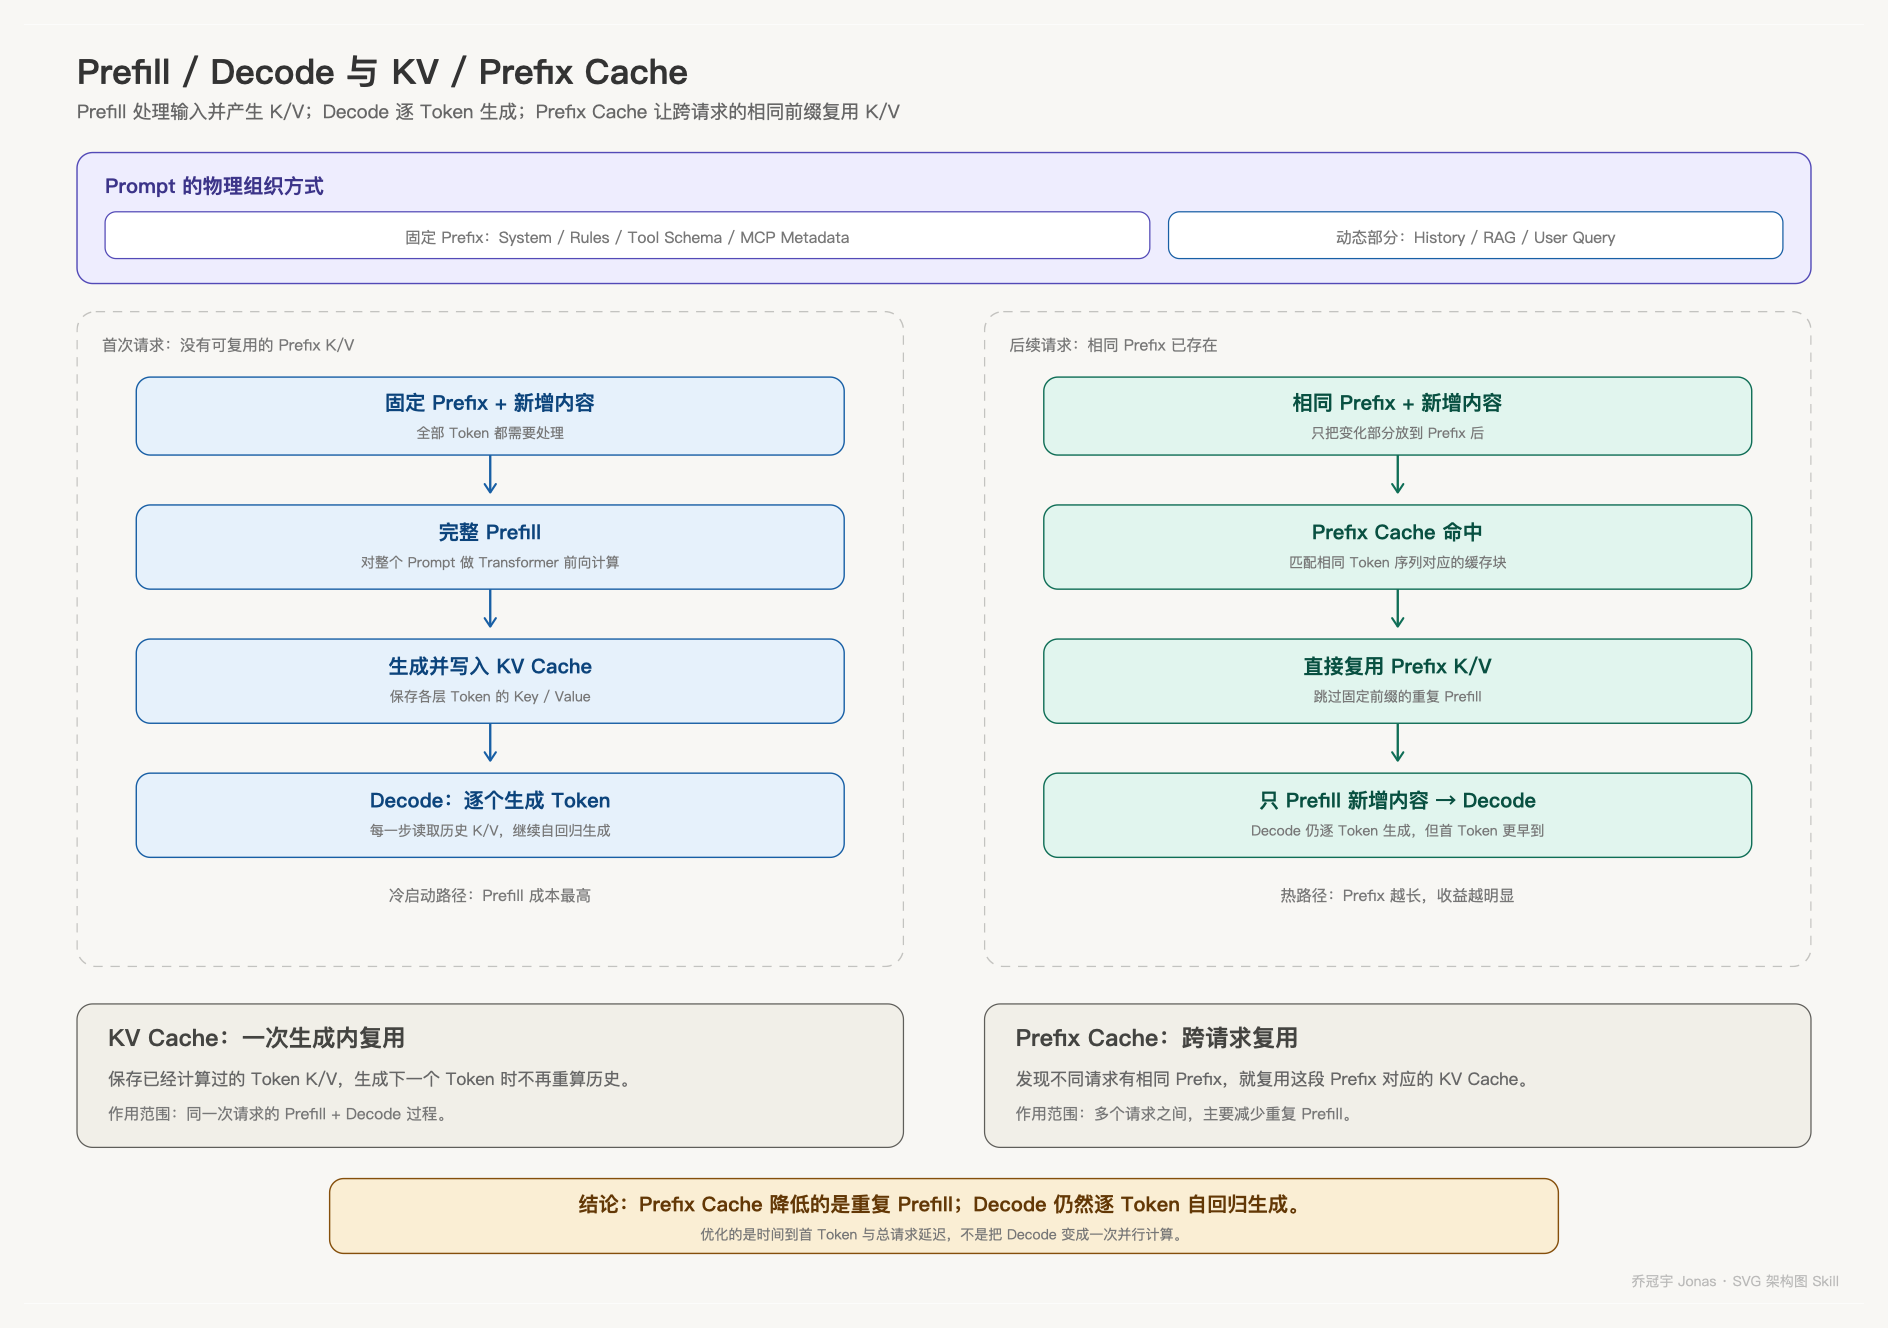
图 2:Prefill 生成并写入 K/V,Decode 逐 Token 生成;Prefix Cache 跨请求复用相同前缀的 K/V,减少重复 Prefill。
用一个具体例子理解。
假设用户问:
北京今天的天气怎么样?
模型最终回答:
北京今天晴,最高温度……
虽然用户只问了一句话,但实际送给模型的 Prompt 还包含 System Prompt、Tool Schema 和用户问题:
System Prompt:
你是一个天气助手,请简洁回答。

Tool:
weather(city)

User:
北京今天的天气怎么样?
假设整个 Prompt 经过 Tokenizer 后一共有 100 个 Token。
2.3.2 Prefill:一次性处理输入
Prefill 会把整个输入 Prompt 一次性送进 Transformer:
100 Tokens
    ↓
Embedding
    ↓
Transformer Layer 1
    ↓
Transformer Layer 2
    ↓
...
Transformer Layer N
    ↓
得到每个 Token 对应的 K / V
可以简单理解为:
Token 1 ─┐
Token 2 ─┤
Token 3 ─┤
...      ├──→ Transformer ──→ KV Cache
Token 99 ┤
Token 100┘
最终得到:
KV Cache:

Token 1   → K1   V1
Token 2   → K2   V2
Token 3   → K3   V3
...
Token 100 → K100 V100
同时,模型根据最后位置的信息预测第一个输出 Token:
下一个 Token = “北”
因此:
Prefill 的核心是一次性处理整个输入 Prompt,并建立 KV Cache。
2.3.3 Decode:逐 Token 生成
现在模型已经处理完 100 个输入 Token,并得到对应的 KV Cache:
K1  V1
K2  V2
...
K100 V100
接下来进入 Decode。模型生成第一个 Token:
“北”
此时不需要重新计算前面的 100 个 Token,只需要处理新 Token:
“北”
 ↓
Transformer
 ↓
K101 V101
 ↓
结合之前的 KV Cache
 ↓
预测下一个 Token
KV Cache 继续增长:
K1   V1
K2   V2
...
K100 V100
K101 V101
然后依次生成:
北 → 京 → 今 → 天 → 晴 → ...
每一步 Decode 都只计算新 Token,并复用之前所有 Token 的 KV Cache。
2.3.4 Prefill 与 Decode 的差异
| 阶段 | 处理方式 | 输入规模 | 主要特征 | 常见瓶颈 |
|---|---|---|---|---|
| Prefill | 一次性处理整个 Prompt | 通常很大 | 可并行计算 | Compute-bound |
| Decode | 每次生成一个 Token | 单步很小 | 存在串行依赖 | Memory-bound |
Decode 必须知道前一个 Token,才能继续生成下一个 Token:
第 1 次 Decode → 北
第 2 次 Decode → 京
第 3 次 Decode → 今
第 4 次 Decode → 天
第 5 次 Decode → 晴
所以:
Decode 的计算量相对较小,但每一步都需要访问 KV Cache,并且存在逐 Token 的串行依赖。
2.3.5 KV Cache 是什么?
Transformer 每一层都会产生:
- K(Key);
- V(Value)。
在生成过程中,后面的 Token 会不断使用之前 Token 的 K/V。
例如,模型第一次处理:
A B C D E
会产生:
K/V(A)
K/V(B)
K/V(C)
K/V(D)
K/V(E)
后面生成 F 时,不需要重新计算 A ~ E 的 K/V。
这就是 KV Cache。
KV Cache 解决的问题是:同一次生成过程内,历史 Token 的 K/V 不要重复计算。
2.3.6 Prefix Cache 优化哪里?
假设 Agent 每次请求前面都有一大段完全一样的内容:
System Prompt
Agent Instructions
Tool Definitions
MCP Tools
业务规则
只有最后的用户问题不同。
第一次请求:
10,000 Token
    ↓
完整 Prefill
    ↓
计算 K/V
    ↓
写入 Prefix Cache
第二次请求:
相同的 10,000 Token
       ↓
命中 Prefix Cache
       ↓
直接复用之前的 K/V
       ↓
不再重复 Prefill 这 10,000 Token
所以,有缓存和没有缓存的路径可以对比为:
没有 Prefix Cache:

10,000 Token
     ↓
完整 Prefill
     ↓
Decode

有 Prefix Cache:

10,000 Token
     ↓
直接复用 Prefix KV
     ↓
只处理新增 Token
     ↓
Decode
Prefix Cache 主要减少的是重复的 Prefill 计算,从而降低 TTFT(Time To First Token)和推理成本。
2.3.7 为什么要固定 Prefix?
假设 Prompt 原来的组织方式不断变化:
System
用户信息
Tool
History
当前问题
那么不同请求可能是:
请求 A:
System + 用户信息A + Tool + ...

请求 B:
System + 用户信息B + Tool + ...
动态内容插在前面,会导致 Prefix 很快发生变化,缓存难以命中。
更合理的组织方式是:
System Prompt
固定 Rules
固定 Tool Schema
固定 MCP Schema
----------------
动态 History
动态 Context
用户 Query
原则是:
稳定、重复的内容放前面;动态变化的内容放后面。
这样不同请求之间可以拥有更长的共同 Prefix:
请求 A
████████████████████░░░░░

请求 B
████████████████████░░░░░

请求 C
████████████████████░░░░░
        ↑
    相同 Prefix
共同 Prefix 越长,Prefix Cache 命中概率越高。
2.3.8 KV Cache 与 Prefix Cache 的区别
KV Cache:
KV Cache
    ↓
保存已经计算过的 Token K/V
    ↓
主要用于同一次生成过程
Prefix Cache:
Prefix Cache
    ↓
发现不同请求存在相同 Prefix
    ↓
复用这个 Prefix 对应的 KV Cache
因此:
Prefix Cache 是 KV Cache 的一种跨请求复用机制。
面试或总结时可以说:
Prefix Cache 主要优化 Prefill,不是优化 Decode 本身。Decode 仍然需要逐 Token 生成,只是它可以直接利用已经缓存的 Prefix KV,因此整体请求延迟下降。
2.3.9 本节结论
Prefill 是一次性把 Prompt 处理完并建立 KV Cache;Decode 是基于已有 KV Cache,一个 Token 一个 Token 地生成;Prefix Cache 则是在不同请求之间复用相同 Prefix 已经计算好的 KV,从而避免重复 Prefill。
三、结合一个企业 Agent 场景
假设我们有一个企业智能助手,用户问:
帮我查询一下张三最近一个月的订单情况,并分析一下有没有异常。
3.1 原始执行链路
用户请求
   ↓
意图识别 LLM
   ↓
Query 改写 LLM
   ↓
Agent LLM
   ↓
查询用户 Tool
   ↓
查询订单 Tool
   ↓
Agent LLM
   ↓
异常分析
   ↓
最终回答
这条链路主要存在四个问题。
3.2 问题与优化
问题 1:LLM 调用太多
可以把简单的意图识别交给 Router / 小模型,减少一次大模型调用。
问题 2:Tool 串行
如果“用户信息”和“订单信息”没有依赖关系:
用户信息 Tool ──┐
                ├→ 汇总 → Agent
订单信息 Tool ──┘
就可以直接并行执行。
问题 3:Tool 太多
如果 MCP Server 有 100 个 Tool,不应该全部放进 Agent Context。
可以先做语义路由:
用户问题
   ↓
Semantic Tool Routing
   ↓
筛选相关 Tool
   ↓
Agent
只把真正需要的 Tool Schema 放进去。
问题 4:Prompt 重复
Agent 每次都有大量固定内容:
System Prompt
Agent Rules
Tool Schema
MCP Metadata
可以让这些内容保持稳定并形成 Prefix:
固定 Prefix
      ↓
Prefix Cache
      ↓
复用 KV Cache

用户问题 / 实时订单数据
      ↓
动态部分
3.3 优化后的链路
                 用户请求
                    ↓
             Rule / 小模型 Router
                    ↓
              Tool Semantic Routing
                    ↓
        ┌───────────┴───────────┐
        ↓                       ↓
   用户信息 Tool             订单 Tool
        └───────────┬───────────┘
                    ↓
              Agent LLM
          ↑
     Prefix / KV Cache
          ↑
  System / Rules / Tool Schema
                    ↓
                最终回答
3.4 全文总结
减少计算
  → 少调用 LLM、少 Token、少 Agent Step

减少等待
  → RAG / Tool 并行

复用计算
  → Tool Cache、RAG Cache、Prefix / KV Cache
这三个方向基本就是理解生产级 Agent 推理延迟优化的主线。