思路:innodb存储引擎 → 索引(查询优化) → 事务(一致性保证) → 锁(并发控制) → 日志(事务实现原理) → 高可用(架构扩展)
零、MySQL架构
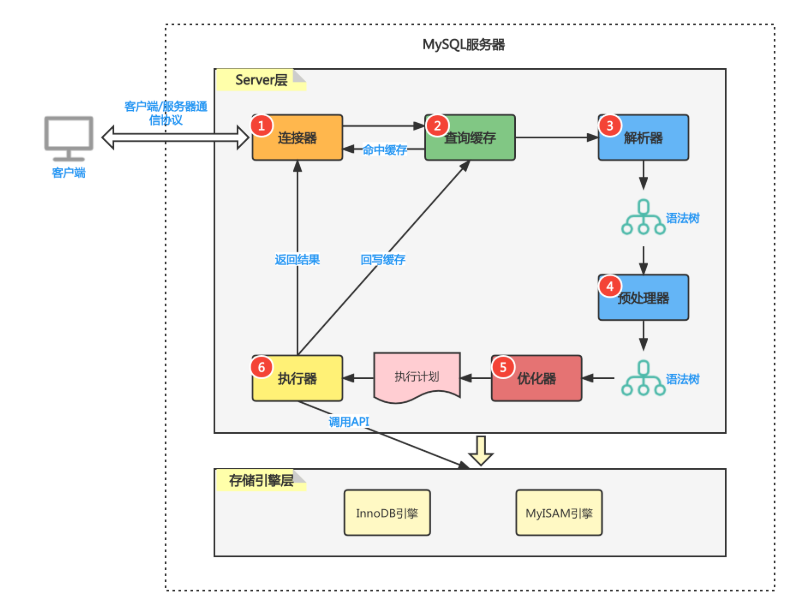
一条sql的执行流程
首先,MySQL分为Server层和存储引擎层。
一条SQL语句从客户端请求到Server后,先经过连接器验证账号密码权限,再查询缓存(5.7之后取消了缓存,因为每次写操作都会导致缓存更新,太频繁,设计本意是加速查询,高并发场景下却成了累赘),再经过解析器将SQL拆分成Token,生成AST抽象语法树,再经过预处理器检查表、字段、别名是否正确,再经过优化器生成最优的执行计划(比如走哪个索引,是否要索引覆盖,多表join顺序),再经过执行器调用存储引擎API,由存储引擎完成实际的数据操作。
一、索引
思路:索引的概念-索引的数据结构-索引的分类-一些概念名词(索引覆盖、索引下推、回表、索引失效)-explain
1. 索引的概念
为什么需要索引?
问题:MySQL 数据存储在磁盘中,如果没有索引,查询数据时需要全表扫描,数据量大的情况下效率很低。
索引本质:一种帮助 MySQL 高效获取数据的数据结构。类似于书的目录,可以根据目录快速定位页码
2. 索引的数据结构
MySQL InnoDB 默认使用:B+Tree 作为索引结构
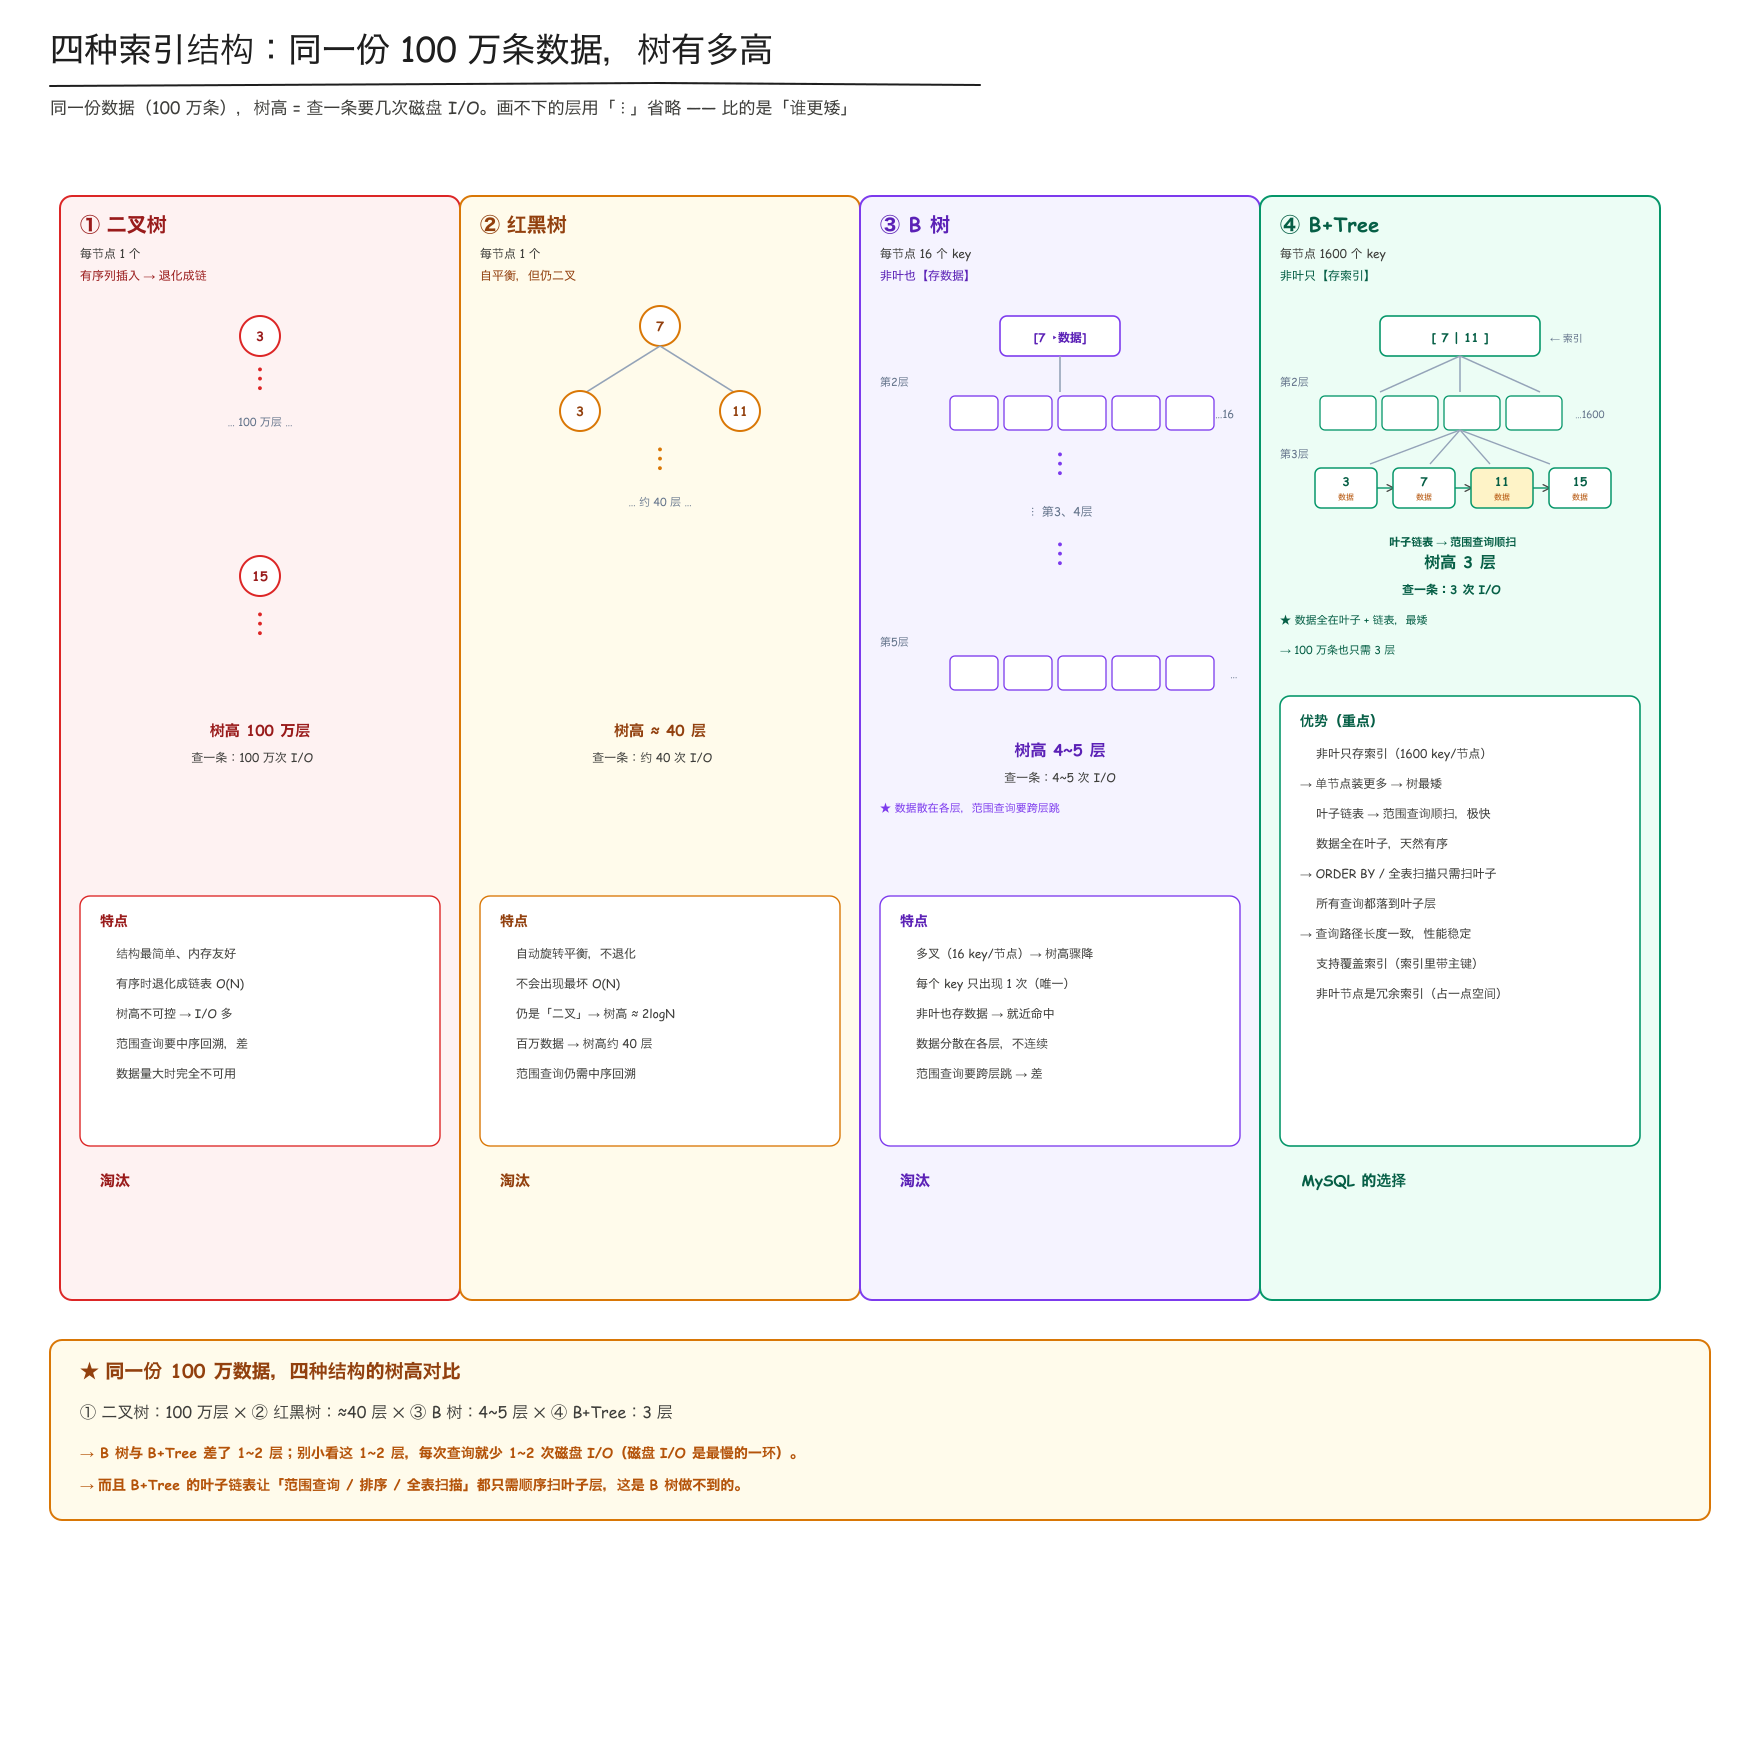
为什么使用 B+Tree?
常见数据结构:
二叉树问题:如果数据有序,会退化成链表,最差查询效率为O(N)
1 \ 2 \ 3 \ 4
红黑树
又叫二叉平衡搜索树,能自动旋转保持平衡,查询效率为O(logN)
问题:因为二叉,数据量大时,高度比较高,磁盘IO次数多,耗时。
B树
N叉,一个节点存储多个数据,降低树高度。
问题:
- 数据和索引都存储在节点中,占用空间多,能存储的索引数量少,高度还是比较高。
- 数据分散在叶子结点和非叶子结点,不连续,不方便进行范围查询
B+Tree
-
非叶子节点只存索引,占用空间小,能存索引数量多,高度低,磁盘IO次数少;叶子节点存真实数据。
假设一个索引项包含:索引键:8B,子节点指针:6B,数据记录:100B, 那么B+树每个索引项约占 14B,B树每个索引项约占 114B,一个数据页的大小是16KB,即16384 Bytes。理论上,一个节点可以存储的索引项数量为: B+树:16384/8+6=1170,第三层可以存1170 * 1170=1,368,900 一百万个叶子节点。假设每个节点能存100条数据,就能存1亿+数据。 B树:16384/8+6+100=143 第三层可以存143 * 143 * 100 =2,044,900 200万数据 两者三层能存储的数据差了 50倍!
-
叶子节点之间通过双向链表连接,方便范围查询效率高。
双向是为了mysql的反向遍历,比如:SELECT * FROM user ORDER BY id DESC;
root 索引 索引 ---------------- 数据1-数据2-数据3-数据4 ↓ 链表
页分裂是 B+ 树为了维护其结构和顺序而不得不执行的一种高成本的磁盘操作。
InnoDB 的 B+ 树以 16 KB 的数据页为基本单位。当一个数据页已经被写满时,如果新的记录需要插入到这个已满页面的中间位置,为了保持 B+ 树的键值顺序,数据库必须执行以下操作:
- 分配新页: 数据库从文件系统分配一个新的 16KB 数据页。
- 数据迁移: 把原页的一部分记录搬到新页 —— 搬多少取决于插入点落在哪里(见下方 1/16 ↔ 8/16)。
- 父节点更新: 向上级节点(分支节点)插入一个新的索引记录,记录新页面的边界和地址。
搬多少:取决于「插入点离页尾多远」
| 插入方式 | 插入点位置 | 分裂点 | 效果 |
|---|---|---|---|
| 顺序追加(自增主键) | 页尾部(距尾 < 1/16) | 偏向尾部 → 新页只分到极少 | 轻分裂,原页几乎全满、保持紧凑 ✅ |
| 随机插入(UUID / 业务随机 ID) | 页中间 | 取中点 → 各留约一半(8/16) | 重分裂,两页都半满、碎片多 ❌ |
简单记:1/16 = 尾部插入的轻分裂,8/16 = 中间插入的对半分裂。
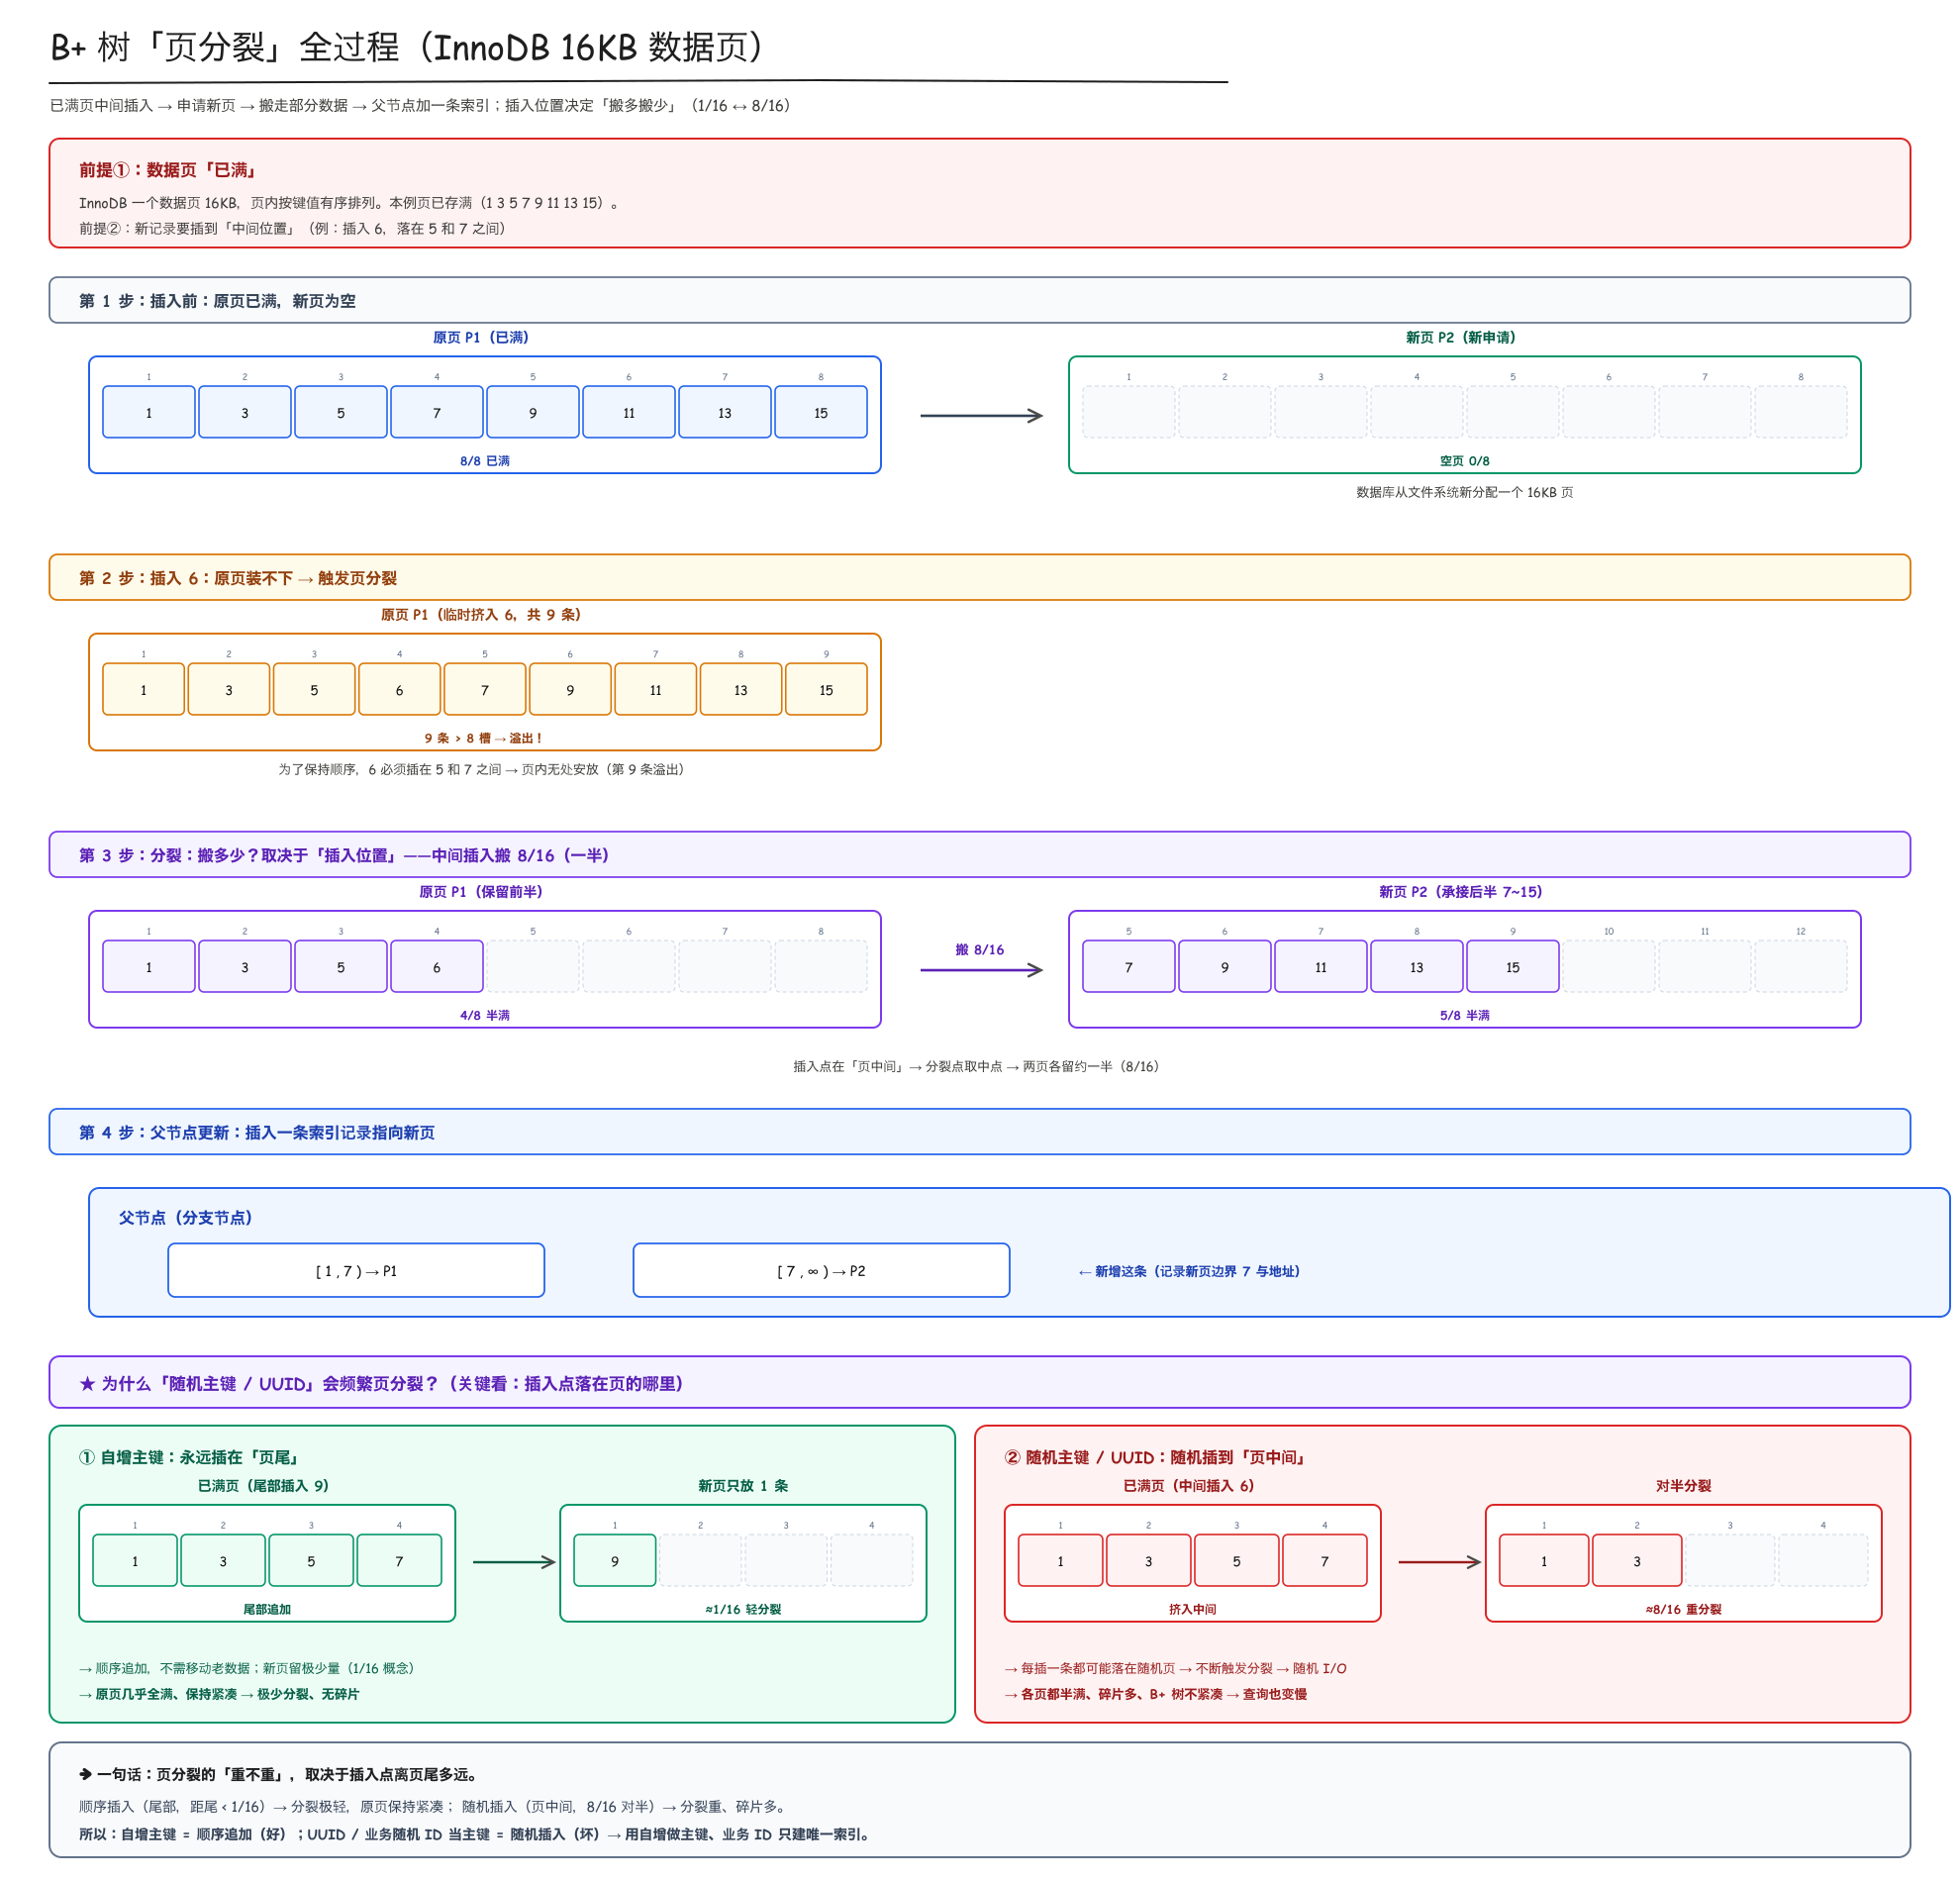
自增长主键:是理想的主键选择。
它通过确保所有插入操作都是顺序追加(插入点永远在页尾,接近 1/16 情形),从而有效地避免了页分裂,维持了 B+ 树的高效写入和低碎片化。
UUID 主键或随机主键:是页分裂的主要诱因。
插入位置随机,频繁落在页中间(8/16 对半分裂),会导致大量的随机 I/O 和频繁的页分裂,对写入性能和磁盘空间利用率有显著负面影响。
3. 索引分类
按数据结构分类
B+Tree索引默认。
Hash索引用hash算法计算键值的hash值,映射到对应槽位,存储到hash表中。
特点:等值查询快,O(1)。但是:不支持范围查询。
InnoDB 默认不使用 Hash 索引(自适应 Hash Index 除外),Memory 引擎支持 Hash 索引。
倒排索引ES核心思想,适用于海量数据的关键词搜索,全文检索。
- 建立"关键词 → 文档"的映射关系。而不是文档 → 关键词,所以叫倒排。
- 如:苹果手机,根据倒排索引查到苹果 → 文档1、文档3,手机 → 文档2,文档3。取交集,苹果手机 → 文档3。
按字段数量分类
单列索引一个字段:create index idx_name on user(name);
联合索引多个字段:(name,age)
遵循最左匹配原则:如(a,b,c),可以匹配:a,a,b,a,b,c;不能匹配:b,c,b,c
注意:a,c能匹配吗?部分匹配,a可以匹配,c匹配不了,但是c会走索引下推(从server层中回表判断c 下沉到 存储引擎层和a一起过滤符合要求的主键id) ,提前过滤,减少回表(详见下文「索引下推」一节的图)
按功能分类
主键索引/聚簇索引/一级索引叶子节点存储完整的数据记录。
通过主键索引-找到叶子结点-直接返回完整数据,不存在回表问题。
特点:唯一、非空 InnoDB:默认建立主键索引
普通索引/非聚簇索引/二级索引叶子结点存储:索引字段 + 主键值。
通过普通索引-找到叶子结点-返回主键id-再回表去查询主键索引-找到完整数据。
特点:不唯一、可以为空。
两者查找过程对比:
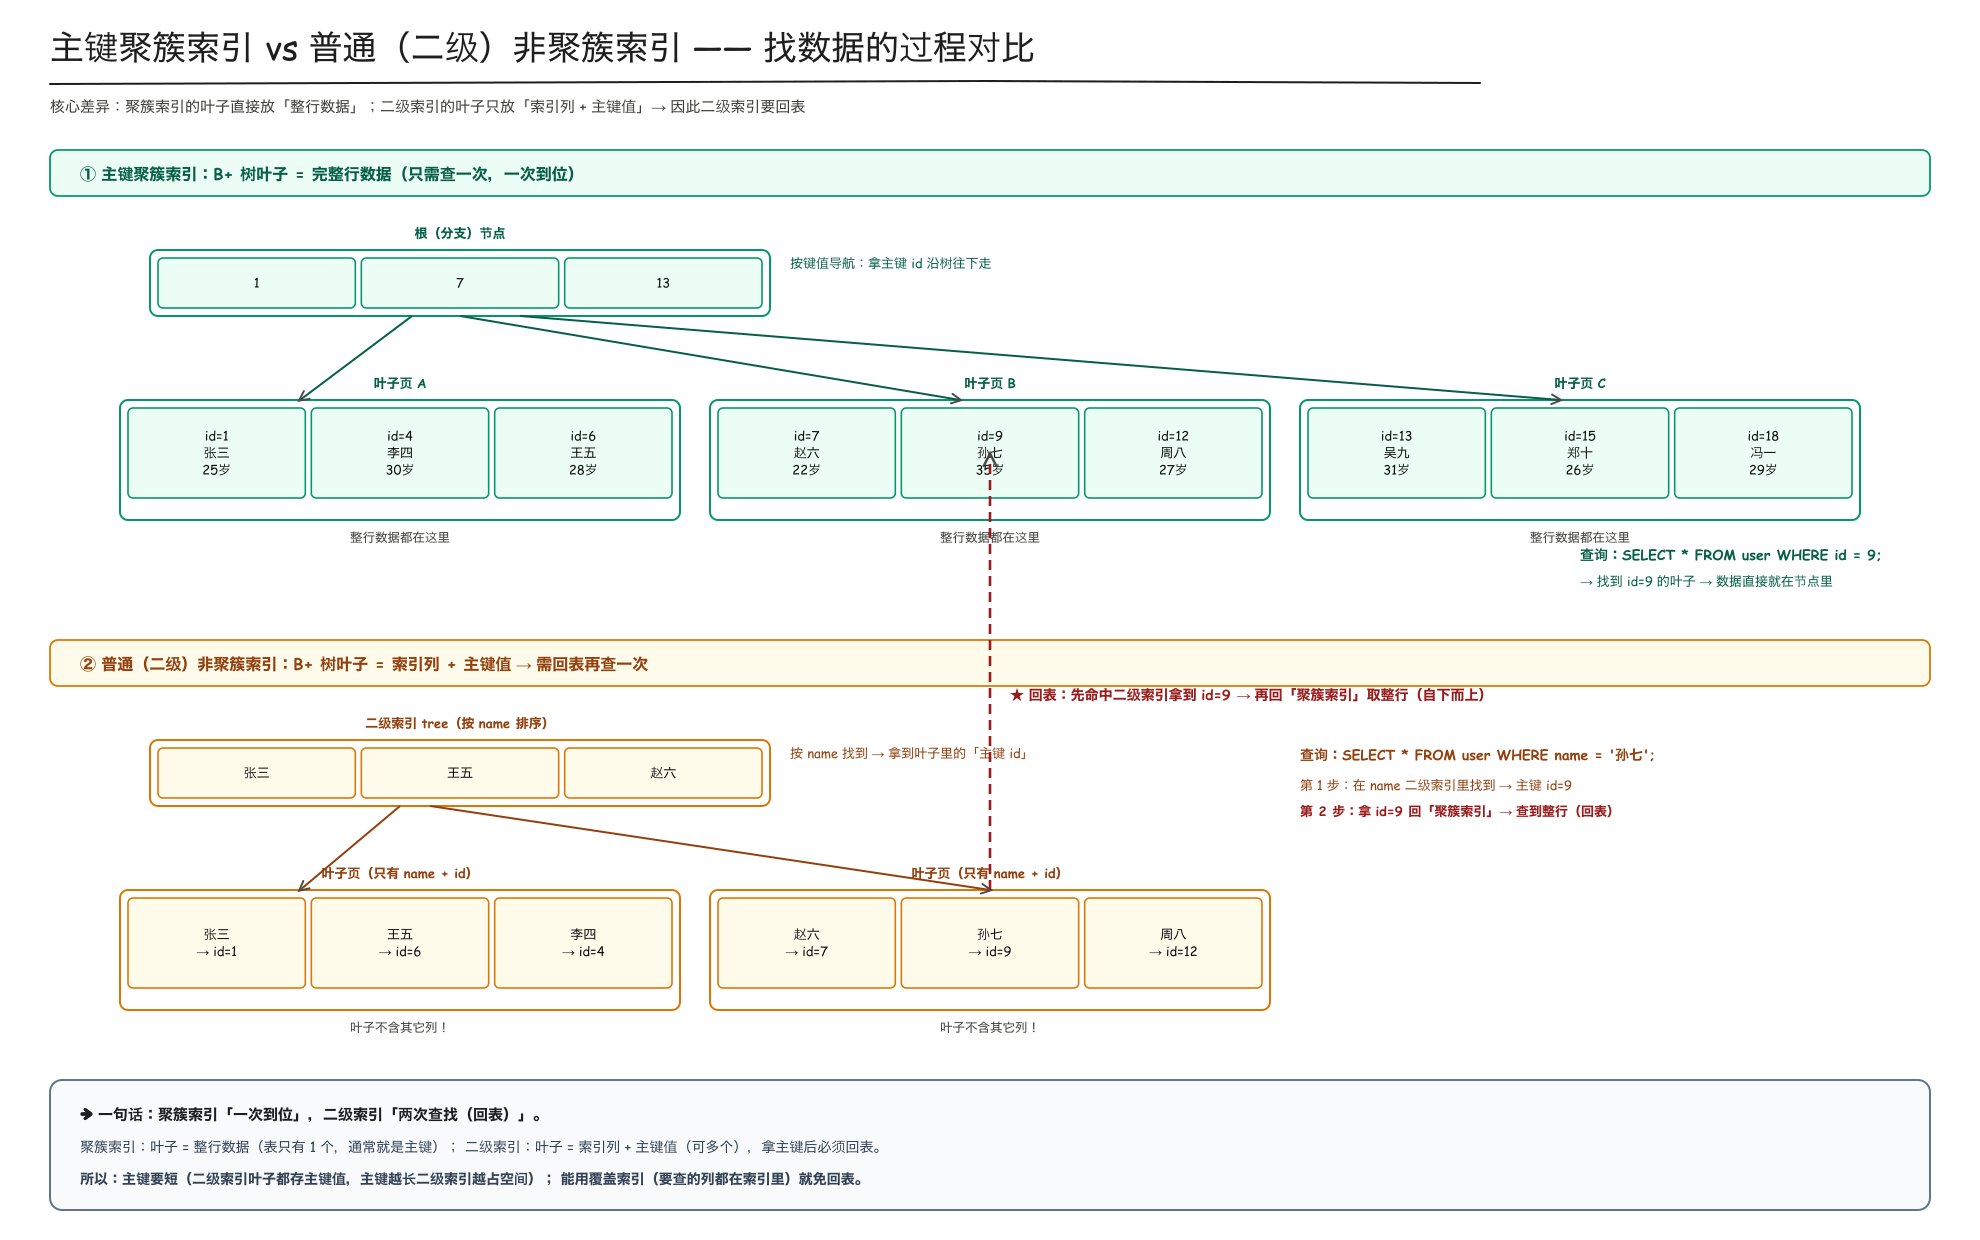
| 对比项 | 主键聚簇索引(一级) | 普通非聚簇索引(二级) |
|---|---|---|
| 叶子节点存什么 | 完整行数据 | 索引列 + 主键值 |
| 查询路径 | 一次:主键树 → 直接拿到整行 | 两次:二级树 → 拿主键 → 回表查主键树 |
| 索引数量 | 表只有 1 个(通常就是主键) | 可以有 多个 |
| 一句话 | 一次到位 | 两次查找(回表) |
4. 索引相关概念
回表
第一次根据普通索引找到主键id,第二次根据主键id去主键索引找完整数据。第二次的过程就叫回表。表指的就是主键索引对应的数据表。
过程见上图《主键聚簇索引 vs 普通(二级)非聚簇索引》中那条红色虚线:先命中二级索引拿到主键 id → 再回聚簇索引取整行。
索引覆盖
如果查询字段已经存在普通索引中,就不需要进行第二次查询,也就不用回表。这种现象叫做索引覆盖。
索引下推
作用:减少回表次数。
例如:联合索引:(name,age) SQL:select * from user where name='张三' and age=20;
MySQL5.6以前:根据name找到所有数据,然后回表再判断age。
现在:在第一层直接根据name和age过滤出符合条件的主键id,减少回表。
索引下推(ICP)的本质,是把原本需要 Server 层在回表之后判断的条件,提前下推到存储引擎层的二级索引扫描阶段进行判断。
注意:索引下推之后仍然可能进行server层的判断,因为下推只能过滤索引中有的字段,而不能过滤所有条件。
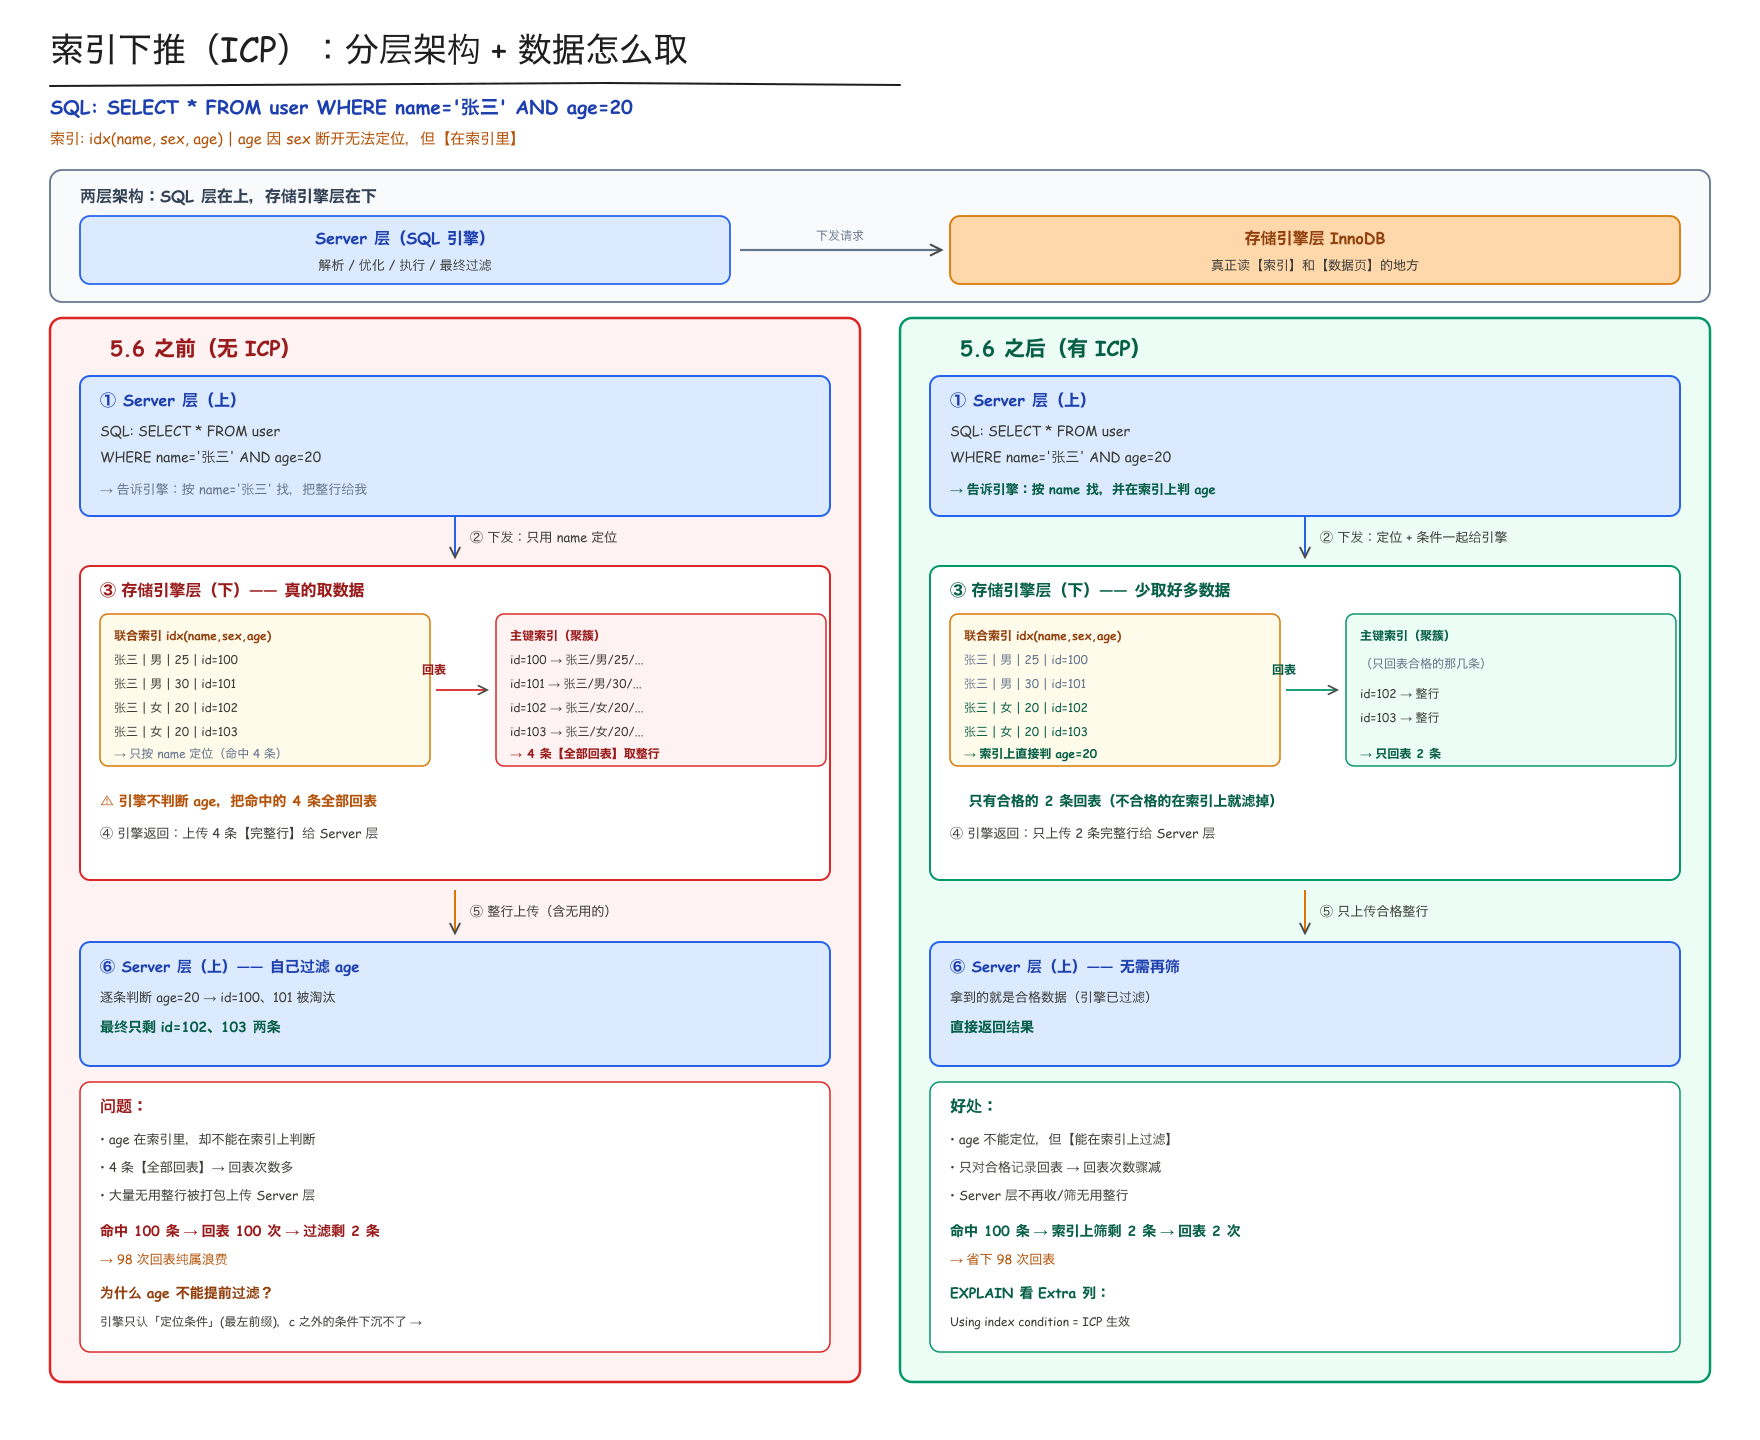
上图举例:联合索引
idx(name, sex, age)+SELECT * FROM user WHERE name='张三' AND age=20。 比笔记原来的(name, age)例子多一个中间字段sex,正好体现「最左前缀在 sex 断开 → age 无法参与定位,但它仍在索引里 → 可以下推过滤」这个关键点。
- 5.6 之前:引擎只按
name定位(命中 4 条)→ 4 条全部回表取整行 → 上传 Server 层后再过滤age。- 5.6 之后:条件一起下推给引擎 → 引擎在索引上就判断
age=20,不合格的直接滤掉 → 只有合格的记录回表 → Server 层无需再筛。- 图上画了两层架构:Server 层(上) ↔ 存储引擎层(下),以及「二级索引取 id → 主键索引回表取整行」的完整数据流。
索引失效
1. 最左匹配失效例如:索引:(a,b,c) 查询:where b=1 无法使用。
2. 对字段进行计算
例如:where id+1=10 索引失效。
3. 使用函数
例如:where substring(name,1,2)
4. like左模糊
例如:like '%abc' 无法定位。
5. 类型隐式转换
例如:字段varchar 查询:where phone=123
可能导致索引失效。
5. Explain
作用:分析 SQL 执行计划。在sql语句前面加explain运行即可,重点字段:
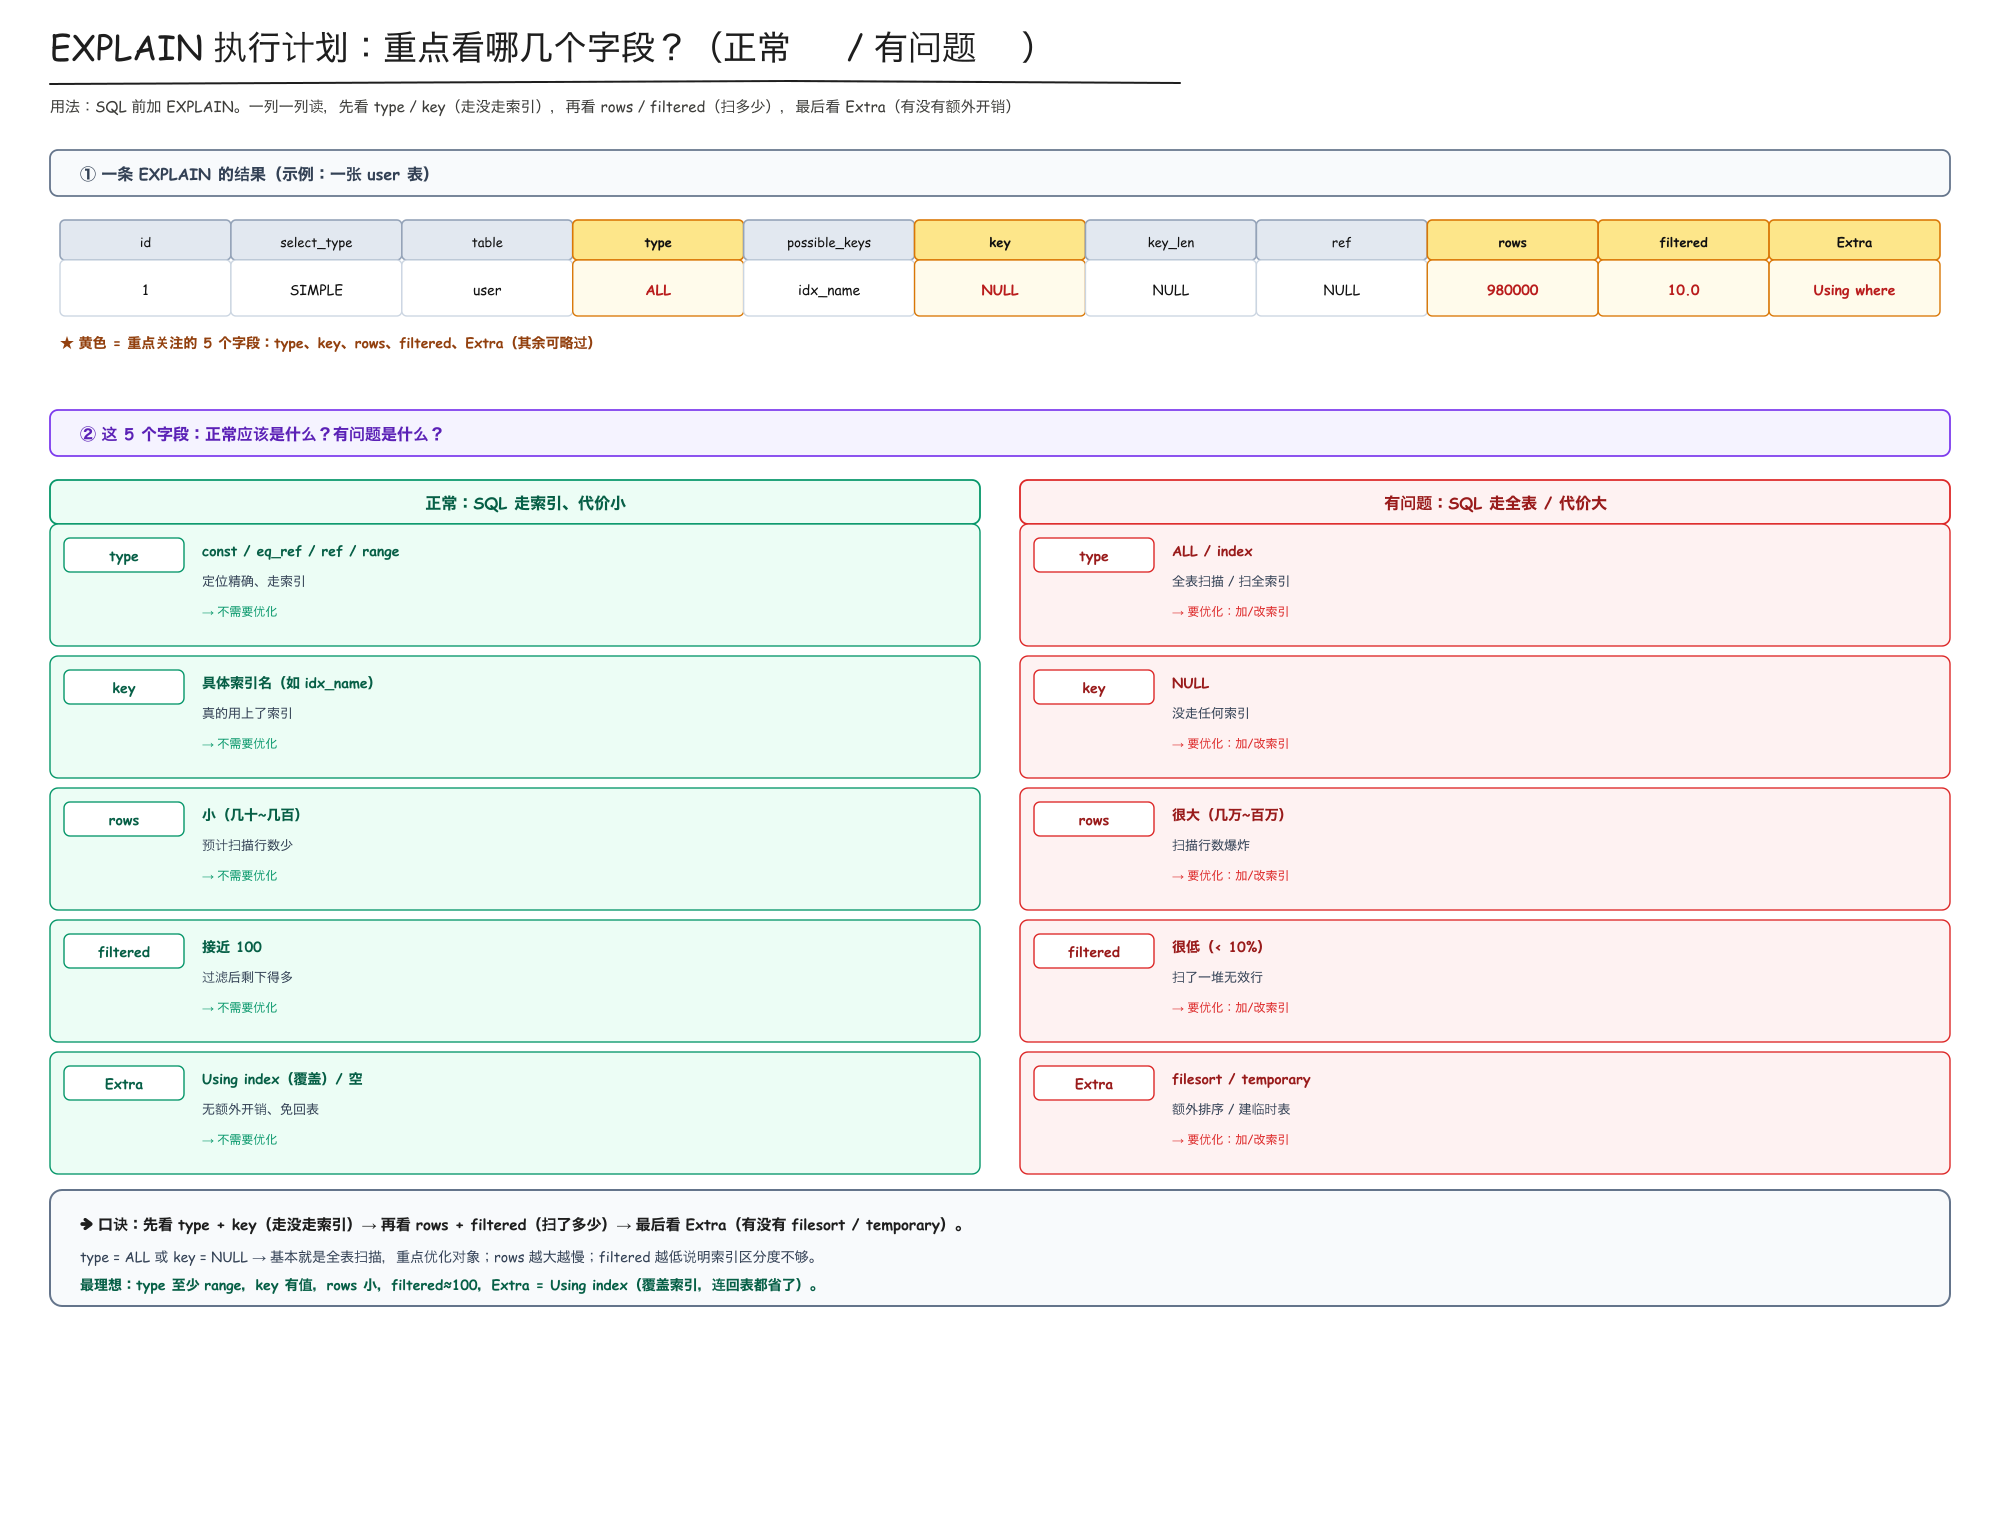
读的顺序:type + key(走没走索引)→ rows + filtered(扫了多少)→ Extra(有没有额外的 filesort / 临时表)。
type
访问类型:
性能排序:system-const-eq_ref-ref-range-index-all(全表扫描,应避免)
- 正常:const / eq_ref / ref / range —— 走索引、定位精确
- 有问题:
ALL(全表扫描)、index(扫整个索引树)—— 优化重点
key
实际使用的索引。
- 正常:显示具体索引名(如
idx_name)—— 真用上了 - 有问题:
NULL—— 没用任何索引
rows
预计扫描行数。越少越好。
- 正常:小(几十 ~ 几百)
- 有问题:很大(几万 ~ 百万)—— 扫描行数爆炸
filtered
过滤后剩余行的百分比(预估)。越接近 100 越好。
- 正常:接近 100
- 有问题:很低(< 10%)—— 扫了一堆无效行
extra
额外信息,常见:
Using index索引覆盖。(✅ 好:连回表都省了)
Using index condition索引下推
Using filesort无法利用索引,额外进行排序——慢查询(❌)
Using temporary创建临时表——慢查询(❌)
二、事务
事务概念-事务特性-并发事务问题-隔离级别-mvcc
1. 事务概念
事务(Transaction) 是数据库中一组操作的执行单元。
2. ACID
原子性 Atomicity
一个事务中的所有操作,要么全部执行成功,要么全部不执行。依靠:undo log 例如:转帐,付款方和收款方必须全部成功或者全部失败。
一致性 Consistency
事务执行前后:数据满足业务规则。通过其他三个特性实现。例如:账户总金额不变。
隔离性 Isolation
多个事务之间互不影响。通过:锁(控制-写写冲突+当前读的读写冲突) + MVCC(避免-快照读发生读写冲突)。
持久性 Durability
提交后的数据永久保存。依靠:redo log
这里单独说一下:
读操作:
InnoDB 将读操作分为快照读和当前读,本质上是为了满足两种不同的业务需求。
对于普通查询,只需要读取一个一致性的数据即可,因此通过 MVCC 读取历史版本,不需要加锁,从而提高并发性能;
而对于需要基于查询结果继续修改数据的场景,必须读取最新版本的数据,为了防止其他事务并发修改,就需要采用当前读并加锁。
因此,快照读和当前读分别对应”读取历史版本”和”读取最新版本”两种需求,也就覆盖了数据库所有的读取场景。
写操作:
所有写操作(UPDATE、DELETE 等)在真正修改数据之前,都会先定位目标记录,并读取其最新版本,同时加排他锁,这个过程就是当前读。
3. 并发事务问题
脏读
读取到其他事务未提交的数据。
例:A修改:100 → 200;B读取200;A回滚。B读到了不存在的数据。
不可重复读
同一个事务:两次读取结果不同。
原因:其他事务修改并提交。
幻读
同一个事务:查询多次:记录数量不同。
原因:其他事务新增或者删除数据。
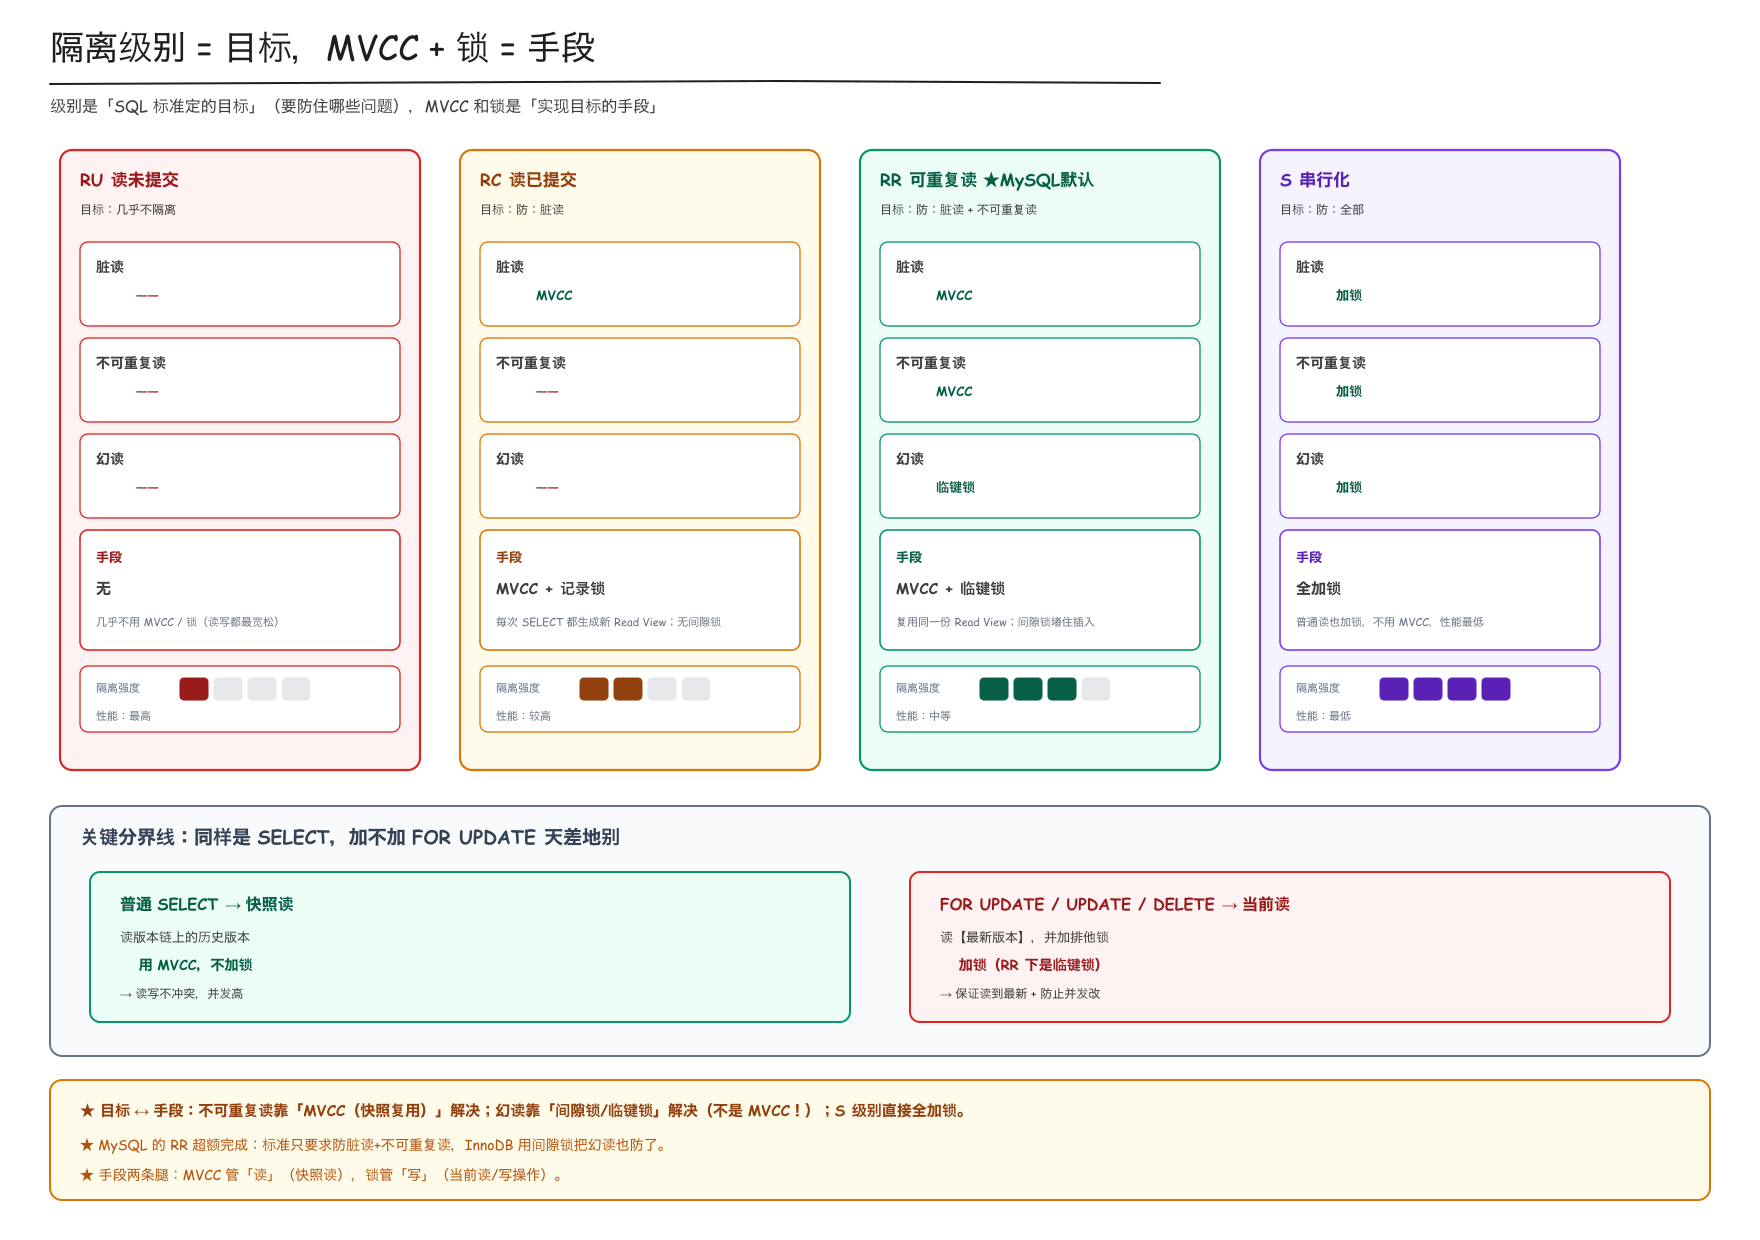
4. 隔离级别
RU-RC-RR-S
Read Uncommitted
读未提交。
存在:脏读。
Read Committed
读已提交。
解决:脏读。
问题:不可重复读。
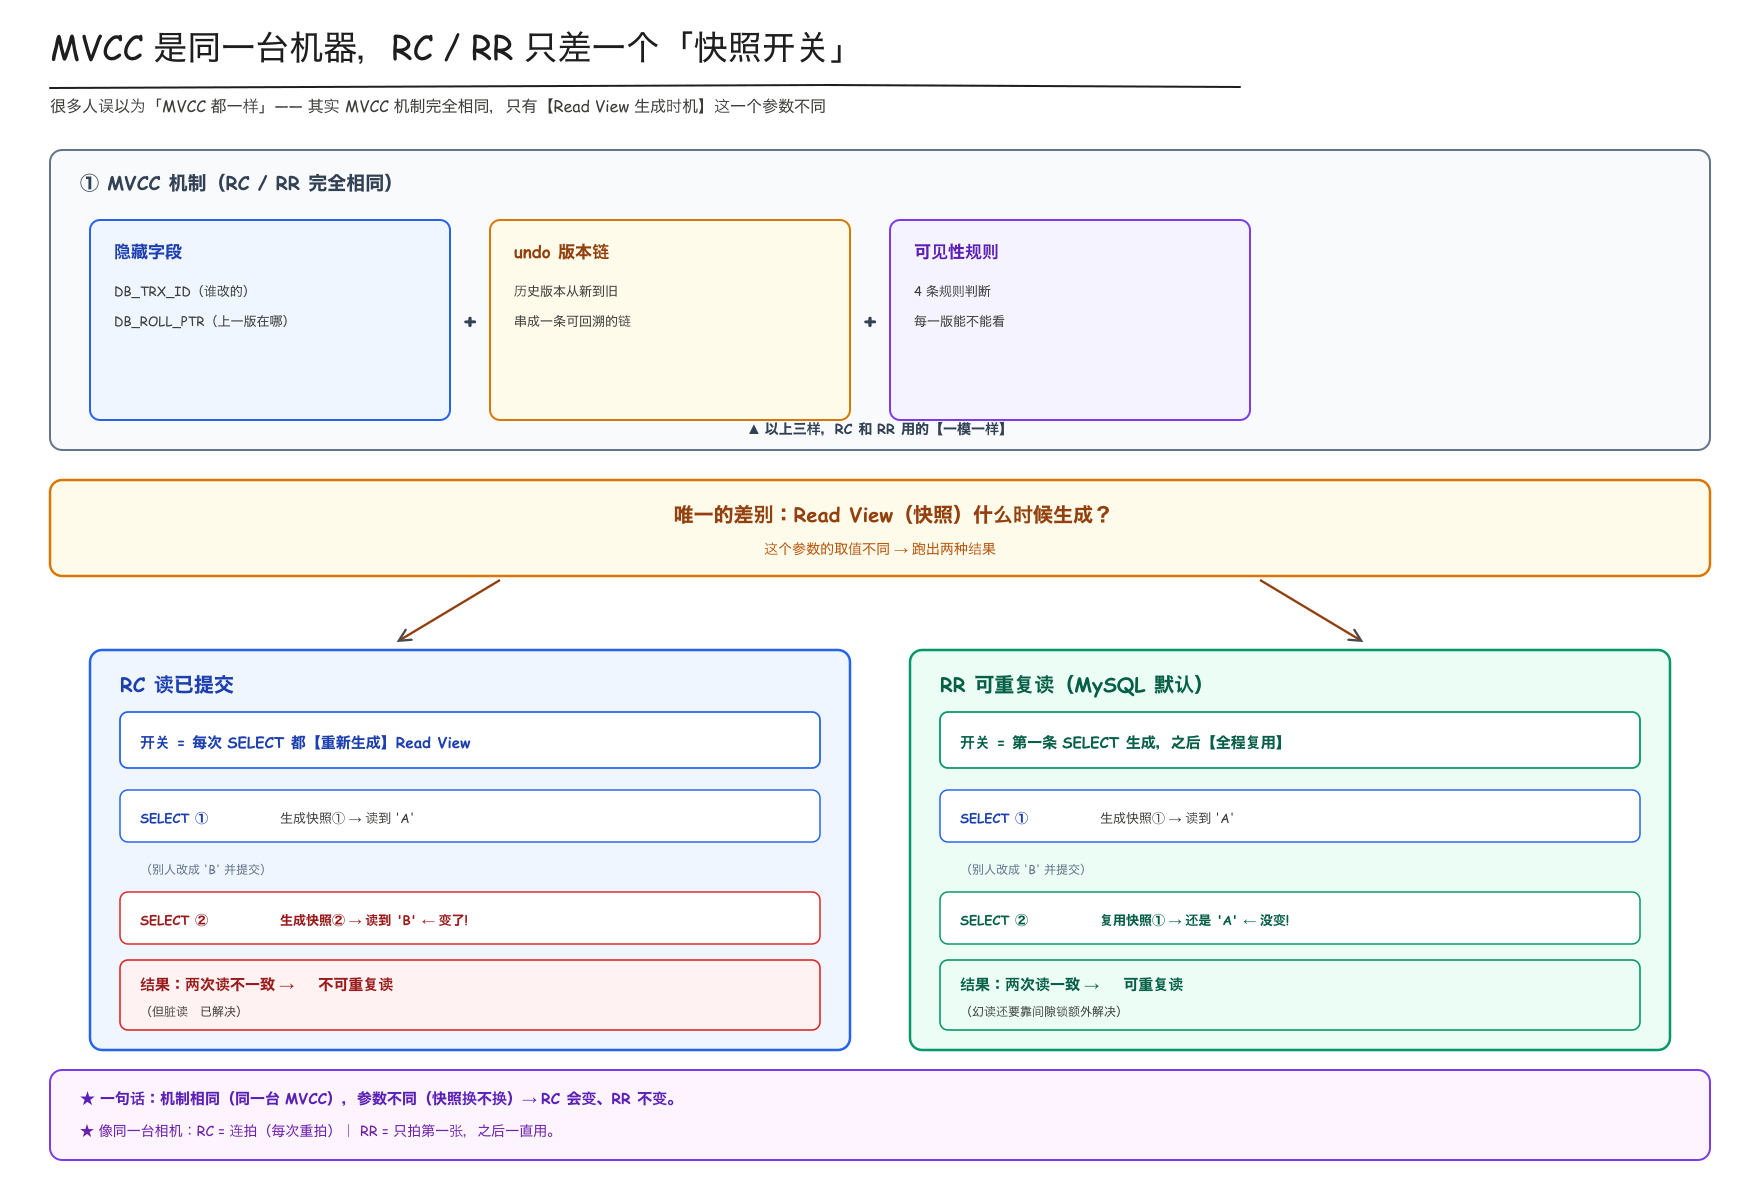
⭐ 核心澄清:RC 和 RR 用的是"同一个 MVCC"
常见误解:以为"MVCC 都是一样的,用了 MVCC 就该可重复读"。其实不是。
MVCC 是一套【机制】(RC / RR 完全相同),但机制里有一个【参数】—— Read View(快照)什么时候生成。参数不同,跑出的结果就不同。
同一个 MVCC 机制(三样东西 RC/RR 完全一样):
| 机制组成 | 作用 |
|---|---|
| 隐藏字段 | DB_TRX_ID(谁改的)+ DB_ROLL_PTR(上一版在哪) |
| undo 版本链 | 历史版本串成可回溯的链 |
| 可见性规则 | 4 条规则判断每一版能否可见 |
唯一差别(参数)—— 快照生成时机:
| 级别 | Read View 何时生成 | 效果 |
|---|---|---|
| RC | 每次执行 SELECT 都重新生成 | 每次看到最新已提交 → 值会变 → 不可重复读 |
| RR | 事务里第一条 SELECT 生成一次,之后全程复用 | 全程看同一个快照 → 值不变 → 可重复读 |
⚠️ 注意:RR 的快照是在第一条 SELECT时生成的,不是 BEGIN 那一刻。(所以 BEGIN 之后、第一条 SELECT 之前的修改,RR 也能看到。)
类比:MVCC 是同一台相机 —— RC 是"连拍"(每次重拍,照片不一样),RR 是"只拍第一张,之后一直用那张"(照片永远一样)。
→ 所以"都用 MVCC"和"结果不同"并不矛盾:机制相同,参数不同。
Repeatable Read
可重复读。MySQL默认。
解决:脏读、不可重复读
通过:MVCC解决不可重复读(复用快照)。
同时,InnoDB 额外用「间隙锁/临键锁」基本解决了幻读(标准只要求 S 级别解决,MySQL 超额完成)。
注意:RC中也有MVCC,只不过RC中每次select都会产生readView,规则会变化,所以读到的数据不一致;但是RR中只在事务开始后的第一次查询生成一份readView,后续查询都复用这个规则,所以一次事务中可以重复读。
小结:RR = RC + 两处升级
- MVCC 模式改为「复用快照」 → 解决【不可重复读】
- 加「间隙锁/临键锁」 → 基本解决【幻读】(不是 MVCC 解决的!)
代价:间隙锁锁范围大 → 并发更低、更易死锁;快照长期复用 → 长事务下 undo 表空间膨胀。所以很多互联网大厂主动选用 RC(牺牲"不可重复读",换取高并发、少死锁)。
Serializable
串行化。最高隔离级别。性能最低。
解决脏读、不可重复读、幻读。
5. MVCC
一句话总结(先看这里)
MVCC 本质上是一套「规则」:它通过 隐藏字段 + undo 版本链 + 快照机制(Read View),决定一个事务在执行时应该看到哪一个版本的数据,从而在不加锁的情况下解决了读写冲突。
拆开理解:
| 部分 | 角色 | 作用 |
|---|---|---|
| 隐藏字段 | 素材 | 每个版本都记着「谁改的」(DB_TRX_ID)+「上一版在哪」(DB_ROLL_PTR) |
| undo 版本链 | 素材 | 把所有历史版本串成一条可回溯的链(从新到旧) |
| 快照机制(Read View) | 规则 | 记录「读的那一刻,哪些事务还活着」,据此判断每一版能不能看,找到第一个可见版本 |
核心直觉:
- 数据只有一条版本链,从不复制 —— 改了不覆盖,而是生成新版本、旧版本留起来。
- "快照"拍的不是数据,是「还活着的事务名单」 —— 它不含任何数据内容,只是一份 ID 列表,用来筛选"链上我能看哪一版"。
- 判断只发生在「读事务开始的那一刻」为基准 —— 同一份数据,不同事务基准点不同,看到的版本就不同。
- MVCC 只保护「普通读」(快照读) —— 写操作(UPDATE/DELETE、
SELECT ... FOR UPDATE)走的是「当前读」,读最新版本 + 加锁,不走 MVCC。
Multi Version Concurrency Control 多版本并发控制。解决的是读写冲突。这里的读是普通查询的快照读,如果是当前读还需要加锁。
主要依赖三个部分:隐藏字段、undo log版本链和Read View。
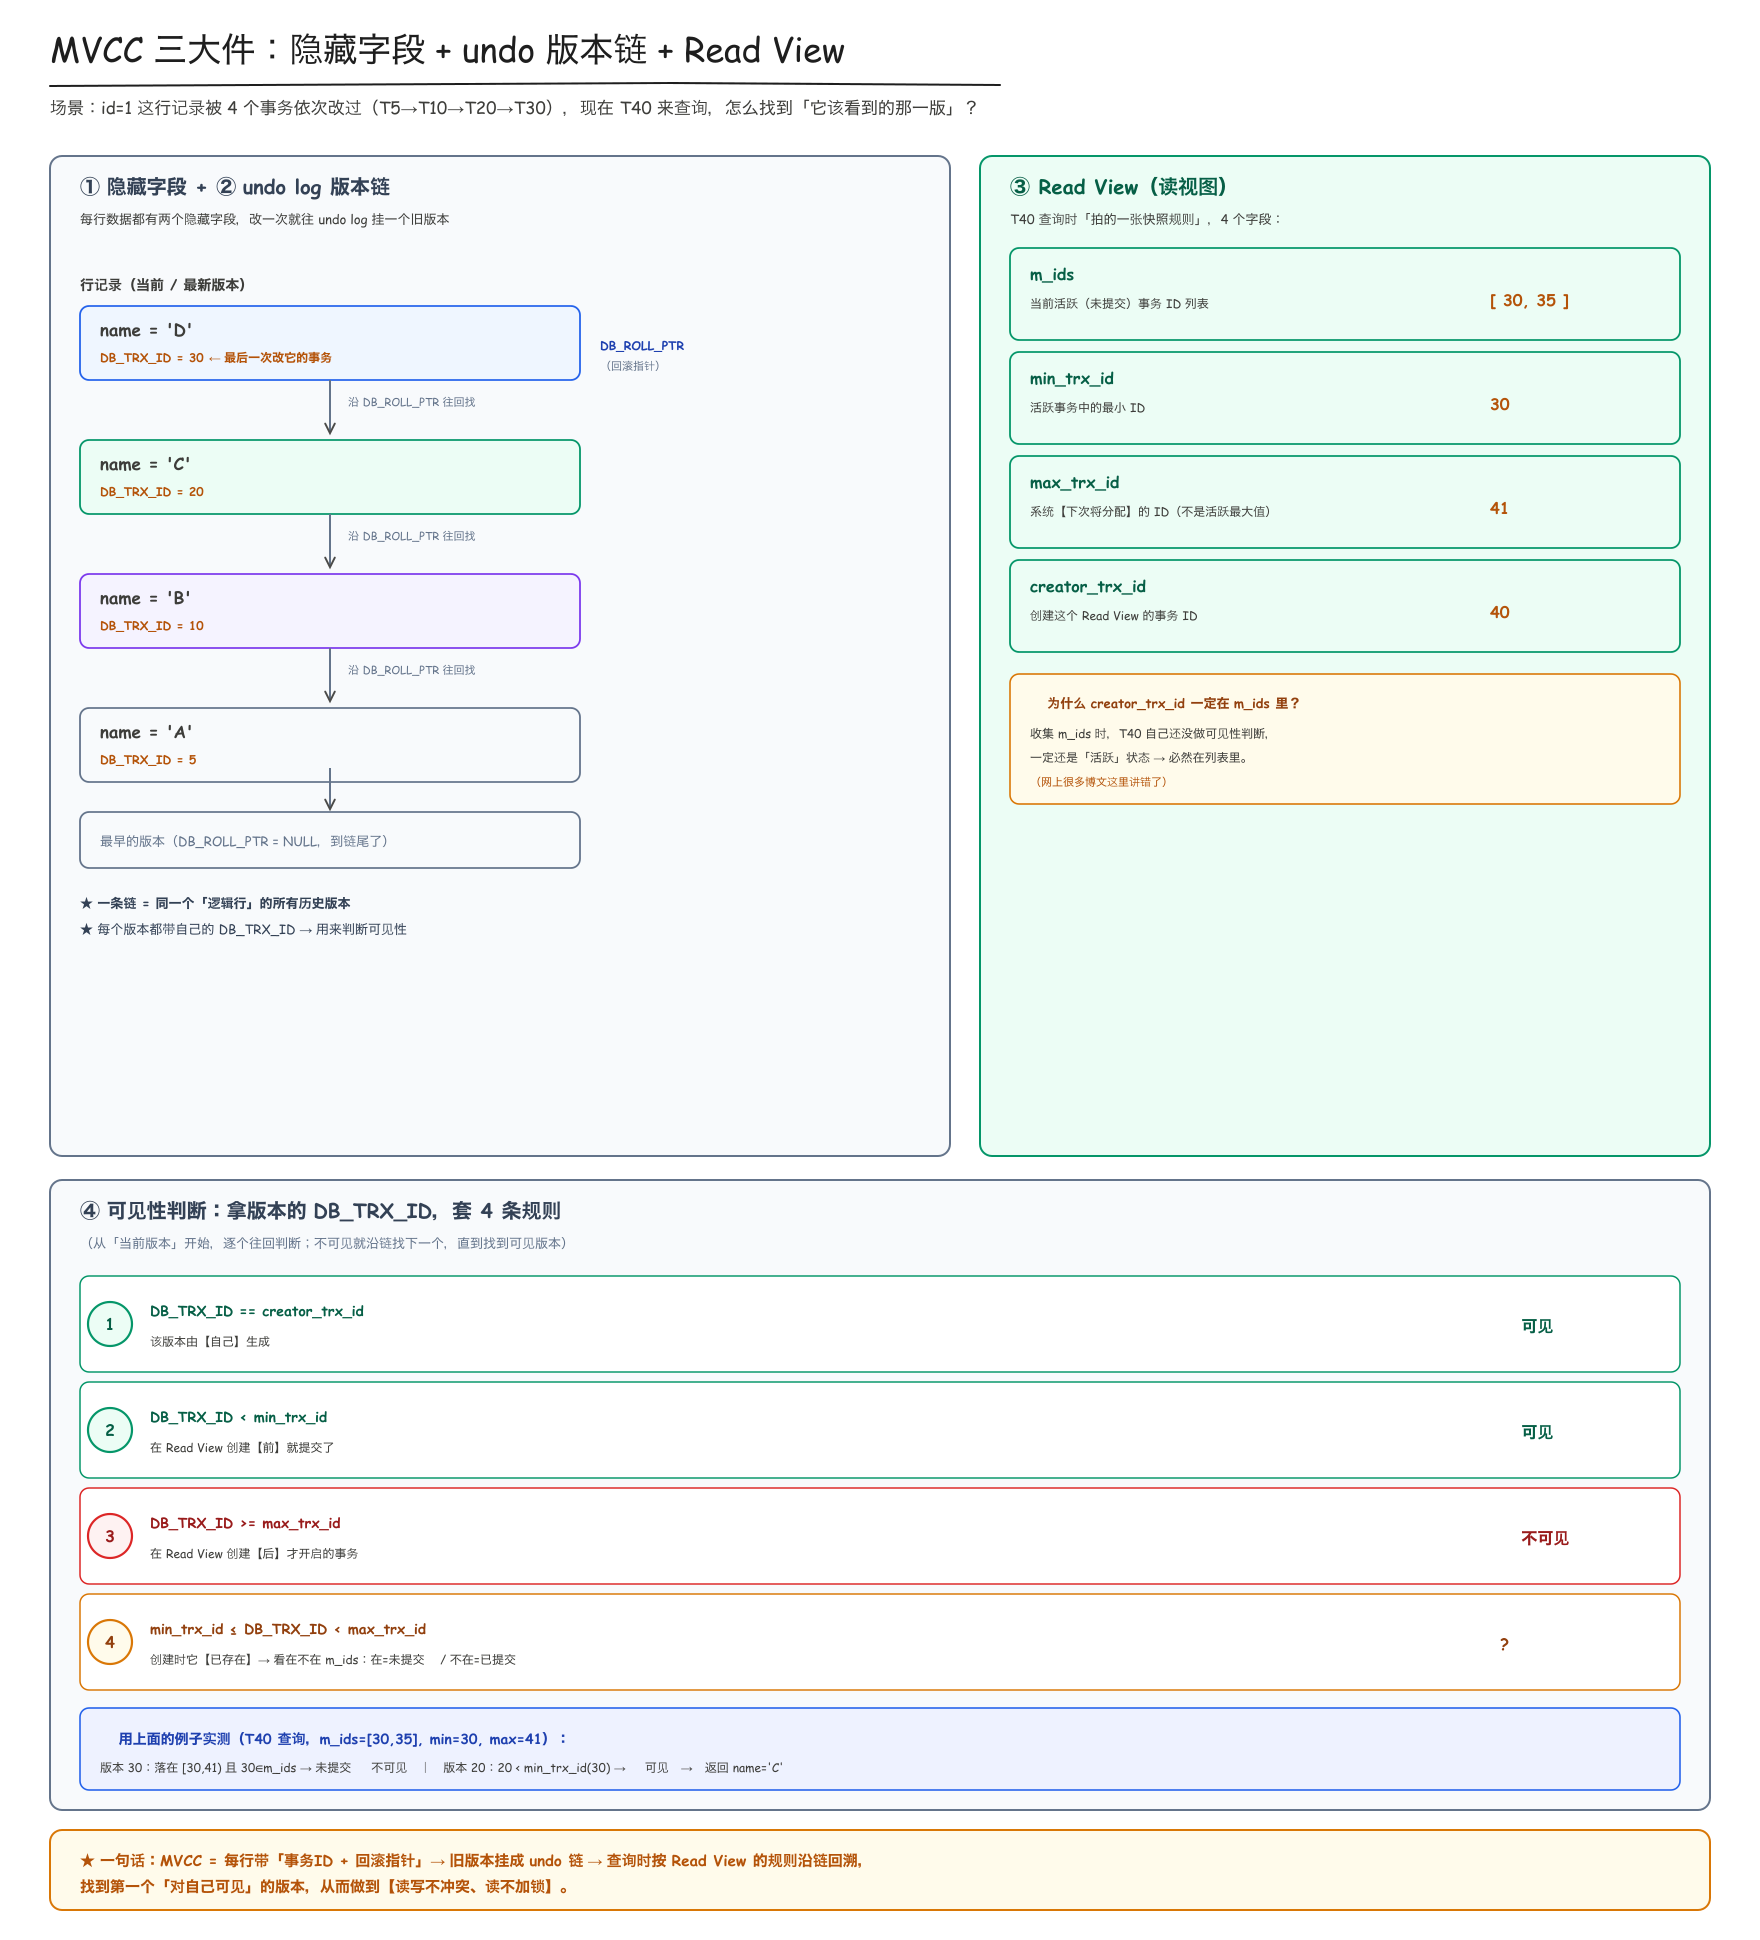
每行数据通过DB_TRX_ID记录修改事务,通过DB_ROLL_PTR指向undo log中的历史版本。当事务查询数据时,会生成Read View,先判断当前版本是否可见,如果不可见,则沿着undo log版本链寻找符合可见性规则的历史版本,从而实现读写并发,避免了加锁,提高了数据库性能。
隐藏字段
① DB_TRX_ID(事务ID)记录最后一次修改该行数据的事务ID。
② DB_ROLL_PTR(回滚指针)指向该数据上一个历史版本所在的undo log。存的是undolog的地址。
undo log版本链
当数据发生修改时:InnoDB不会直接删除旧数据。而是,将旧版本保存到undo log,形成版本链:
当前数据 | | DB_ROLL_PTR ↓ undo log版本1 | DB_ROLL_PTR ↓ undo log版本2
Read View(读视图)
事务执行查询时会生成一份 Read View(读视图),用于判断哪个版本的数据对当前事务可见,可以理解为事务查询时拍下的一张“快照规则”。
Read View 包含:
- m_ids:当前活跃事务 ID 列表。
- min_trx_id:活跃事务中的最小事务 ID。
- max_trx_id:系统下一次将要分配的事务 ID(注意:不是活跃事务中的最大事务 ID)。
- creator_trx_id:创建该 Read View 的事务 ID。
(注意这里的creator_trx_id在m_ids当中,网上的博主为误导,因为当前的事务id在收集m_ids的时候,还没进行快照可见性判断,一定活跃)
可见性判断规则(根据数据版本中的 DB_TRX_ID):
(1)DB_TRX_ID == creator_trx_id
说明该版本由当前事务自己生成,可见。
(2)DB_TRX_ID < min_trx_id
表示该版本在 Read View 创建前就已经提交,可见。
(3)DB_TRX_ID >= max_trx_id
表示该版本由 Read View 创建之后才开启的事务生成,不可见。
(4)min_trx_id <= DB_TRX_ID < max_trx_id
说明该事务在 Read View 创建时已经存在,此时需要判断:
- 如果 DB_TRX_ID 在 m_ids 中,说明事务仍未提交,不可见。
- 如果 DB_TRX_ID 不在 m_ids 中,说明事务已经提交,可见。
三、锁
锁分类-死锁
1. 锁分类
MySQL 的锁可以从多个维度分类:
(1)按并发控制思想分类
乐观锁**乐观锁其实不是一种”锁”,而是一种并发控制思想(策略)。**认为数据冲突概率较低,所以并没有真的加锁,更新时再判断数据是否被修改。
**常见实现:**版本号、CAS(比如update XX SET XX WHERE status = 'unpaid' 防止并发修改)
**特点:**不加数据库锁、并发高、适用于读多写少
悲观锁
认为数据随时可能发生冲突,操作数据前先加锁,MySQL中的各种锁(行锁、表锁、读锁、写锁)本质都属于悲观锁。
**特点:**先加锁再操作,并发较低,数据安全性高
(2)按锁粒度分类
全局锁锁整个数据库。
**场景:**全库备份。
**命令:**FLUSH TABLES WITH READ LOCK;
特点:整个数据库只允许读取,禁止写操作
表级锁
锁整张表。MyISAM 默认采用表锁。
特点:粒度较大,并发较低。
表级锁主要包括:
表锁直接锁住整张表
元数据锁保护表结构(元数据)不被并发修改
意向锁快速判断表锁与行锁是否冲突 包括IS/IX
假如当前表已有意向锁IS,要加表读锁(S),可以;要加表写锁(X),不可以;
假如当前表已有意向锁IX,要加表读锁(S),不可以;要加表写锁(X),不可以;
意向锁由 InnoDB 自动维护,开发者无需手动加锁。
行级锁
注意:
InnoDB 的行锁实际上是基于索引实现的,锁的是索引记录而不是物理行。因为数据在磁盘中的物理位置会随着插入、删除、页分裂等操作不断变化,而索引能够稳定地定位记录。如果查询条件能够使用索引,InnoDB 只会锁定命中的索引记录;如果没有可用索引,就只能全表扫描,并在扫描过程中对经过的记录逐个加锁,最终几乎锁住整张表,表现得像表锁。
锁具体记录。InnoDB 默认采用行锁。
特点:粒度最小,并发最高
记录锁锁一条记录。比如:UPDATE user SET age=20 WHERE id=1;锁id=1。
间隙锁只锁间隙,不锁记录,防止其他事务插入数据,解决幻读。
临键锁记录锁+间隙锁。InnoDB 默认 RR 隔离级别采用。既锁记录,也锁间隙。既能防止修改,又能防止插入。
(3)按锁的用途分类
共享锁/S锁/读锁允许其他事务同时读取数据,不允许修改数据。
例如:SELECT ... FOR SHARE;
这种读叫做当前读,只有当前读才会加读锁,快照读是通过MVCC实现,不加锁。
排他锁/X锁/写锁
其他事务不能进行当前读或修改;普通 SELECT(快照读)仍可通过 MVCC 读取历史版本。
例如:UPDATE DELETE SELECT ... FOR UPDATE 都会加排他锁。
2. 死锁
概念
多个事务互相持有对方需要的锁,形成循环等待,导致事务无法继续执行。
例如:事务A持有锁1,等待锁2;事务B持有锁2,等待锁1。
死锁产生条件
- 资源互斥-资源只能给一个事务
- 请求保持-已经持有但不释放继续申请新的资源
- 不可剥夺-不能被其他事务抢夺,除非主动释放
- 循环等待-多个事务互相等待对方持有的资源
避免死锁
- 按固定顺序加锁(最重要)-所有事务获取锁的顺序一致
- 缩短事务时间
- 减少锁范围(合理建立索引)
- 一次性锁定所需资源
MySQL 如何处理死锁
InnoDB 默认开启死锁检测。
发生死锁时:
- 自动检测循环等待
- 主动回滚一个事务
- 释放锁
- 其他事务继续执行
补充:MySQL 的并发控制依赖两套机制:
- MVCC:解决普通读(快照读)与写之间的并发冲突,提高并发性能。
- 锁:解决写写冲突,以及当前读(SELECT ... FOR UPDATE、FOR SHARE)的并发问题,保证数据一致性。
两者共同保证事务的隔离性和并发安全。
四、日志
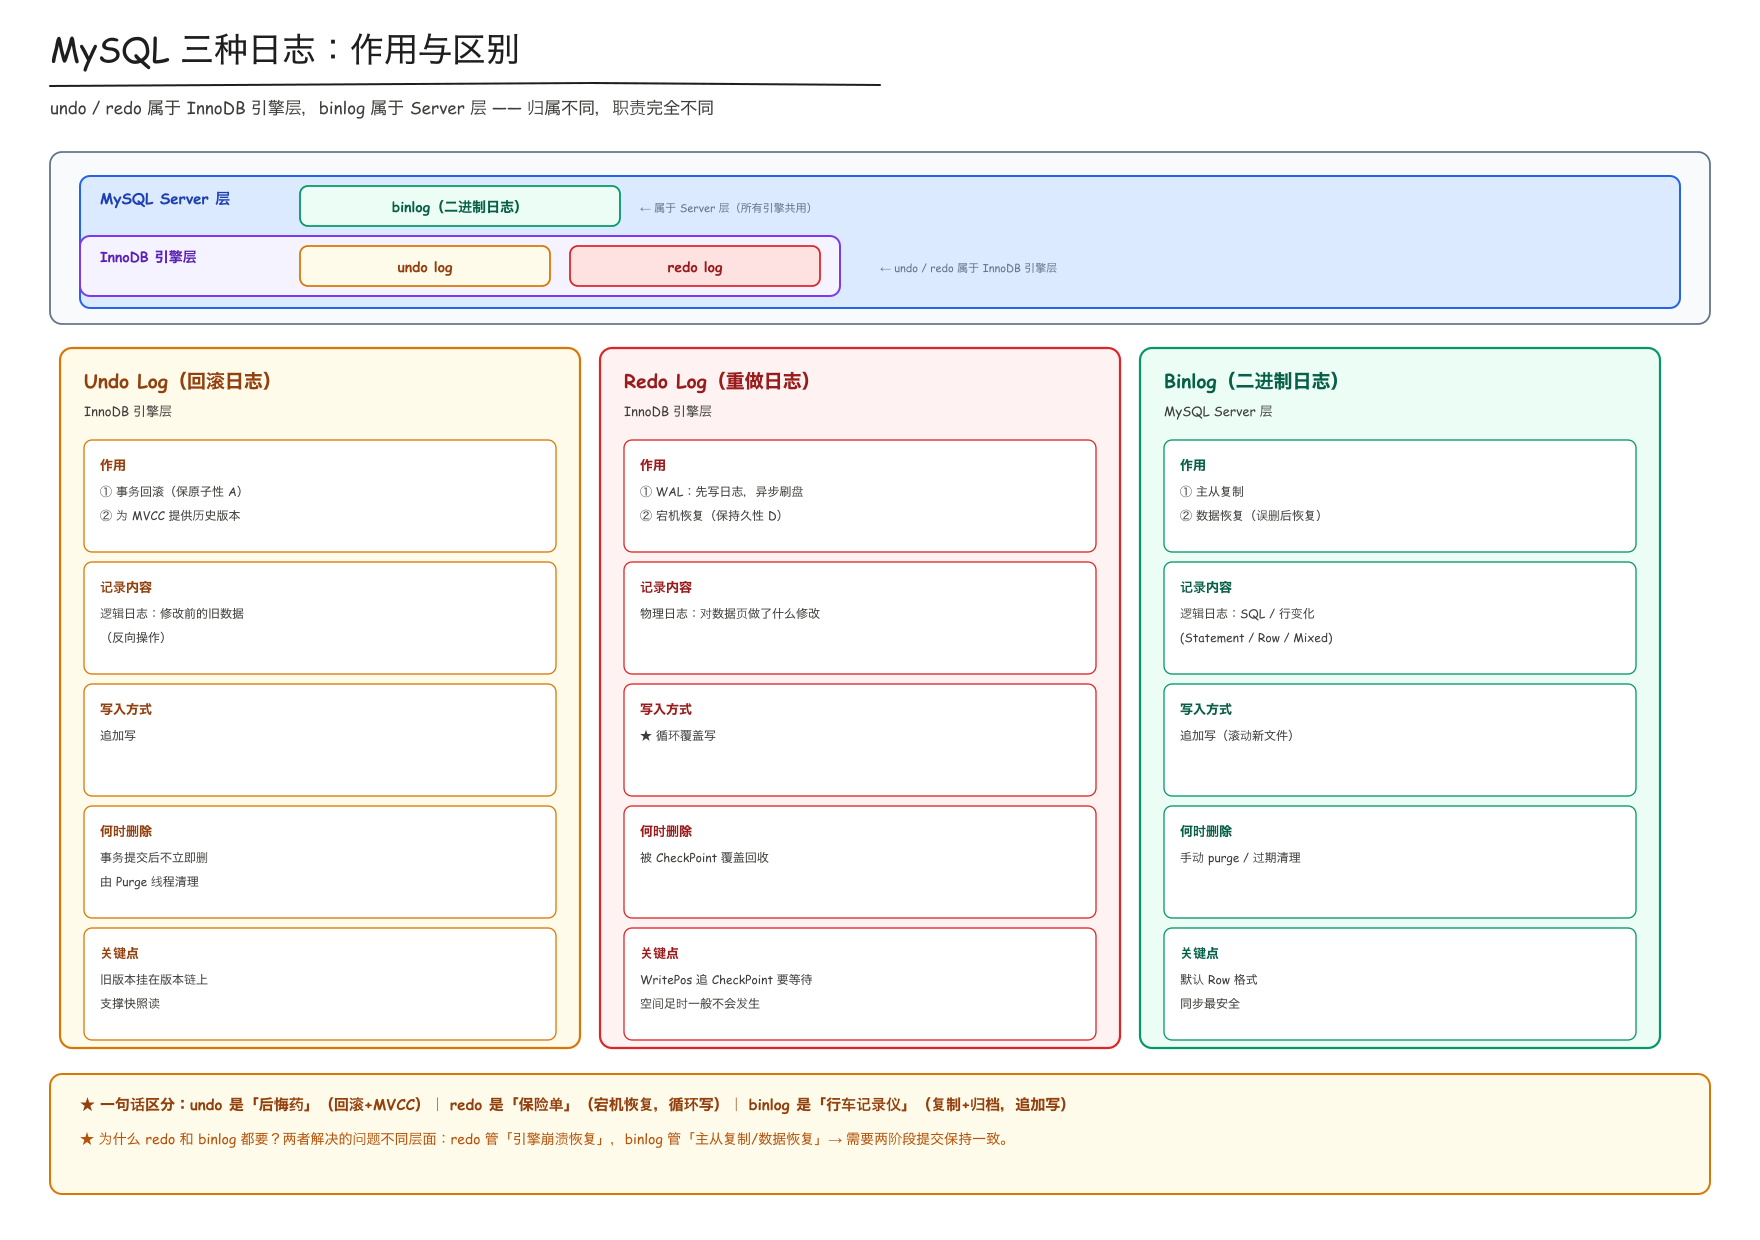
分为三大事务日志和三大运维排查日志:
三大事务日志:
-
Undo Log(回滚日志)——innodb层
-
Redo Log(重做日志)——innodb层
-
Binlog: (二进制日志)——server层
三大运维排查日志:
- Slow Query Log(慢查询日志)-记录慢 SQL
- Error Log(错误日志)-记录数据库启动、关闭、异常等信息
- General Query Log(通用查询日志)-记录所有 SQL(一般不开,性能开销大)
事务日志
1. Undo Log
概念:记录数据修改前的旧版本。
作用:保证原子性——事务回滚;为MVCC追踪历史版本的数据提供undolog。
注意:事务提交后不会立即删除,等到没有任何事务需要这个历史版本的时候,由Purge Thread线程清理
2. Redo Log
概念:事务提交并不是直接写磁盘,因为修改数据时,磁盘随机IO,速度很慢,所以会用日志顺序写,后台异步刷盘,这样提高了写的效率。但是实际上后台异步刷的时候还是要随机IO,只不过不需要用户等待。
作用:
- WAL(write ahead logging)机制,先顺序写日志,再后台异步刷盘写数据,提高响应速度
2.如果Crash Safe数据库宕机,磁盘数据没来得及写,可以通过Redo Log,恢复数据
注意:
1.RedoLog写的是物理日志,BinLog写的是逻辑日志。物理日志指的是修改的内容,逻辑日志是做了什么修改。
2.RedoLog是循环覆盖写。就是说RedoLog满了不会新建一个Log,而是从头覆盖。具体有两个指针,WritePosition(写指针)和CheckPoint(检查点),前者表示写入RedoLog的位置,后者表示数据页刷盘的位置,所以WritePosition肯定在CheckPoint的后面,当WritePosition写到日志底,就会从头覆盖写入,因为之前的已经被刷盘了。如果WritePosition追上了CheckPoint,就必须等待CkheckPoint继续刷盘才能继续写入,不过这种情况一般不会发生,因为RedoLog足够大。
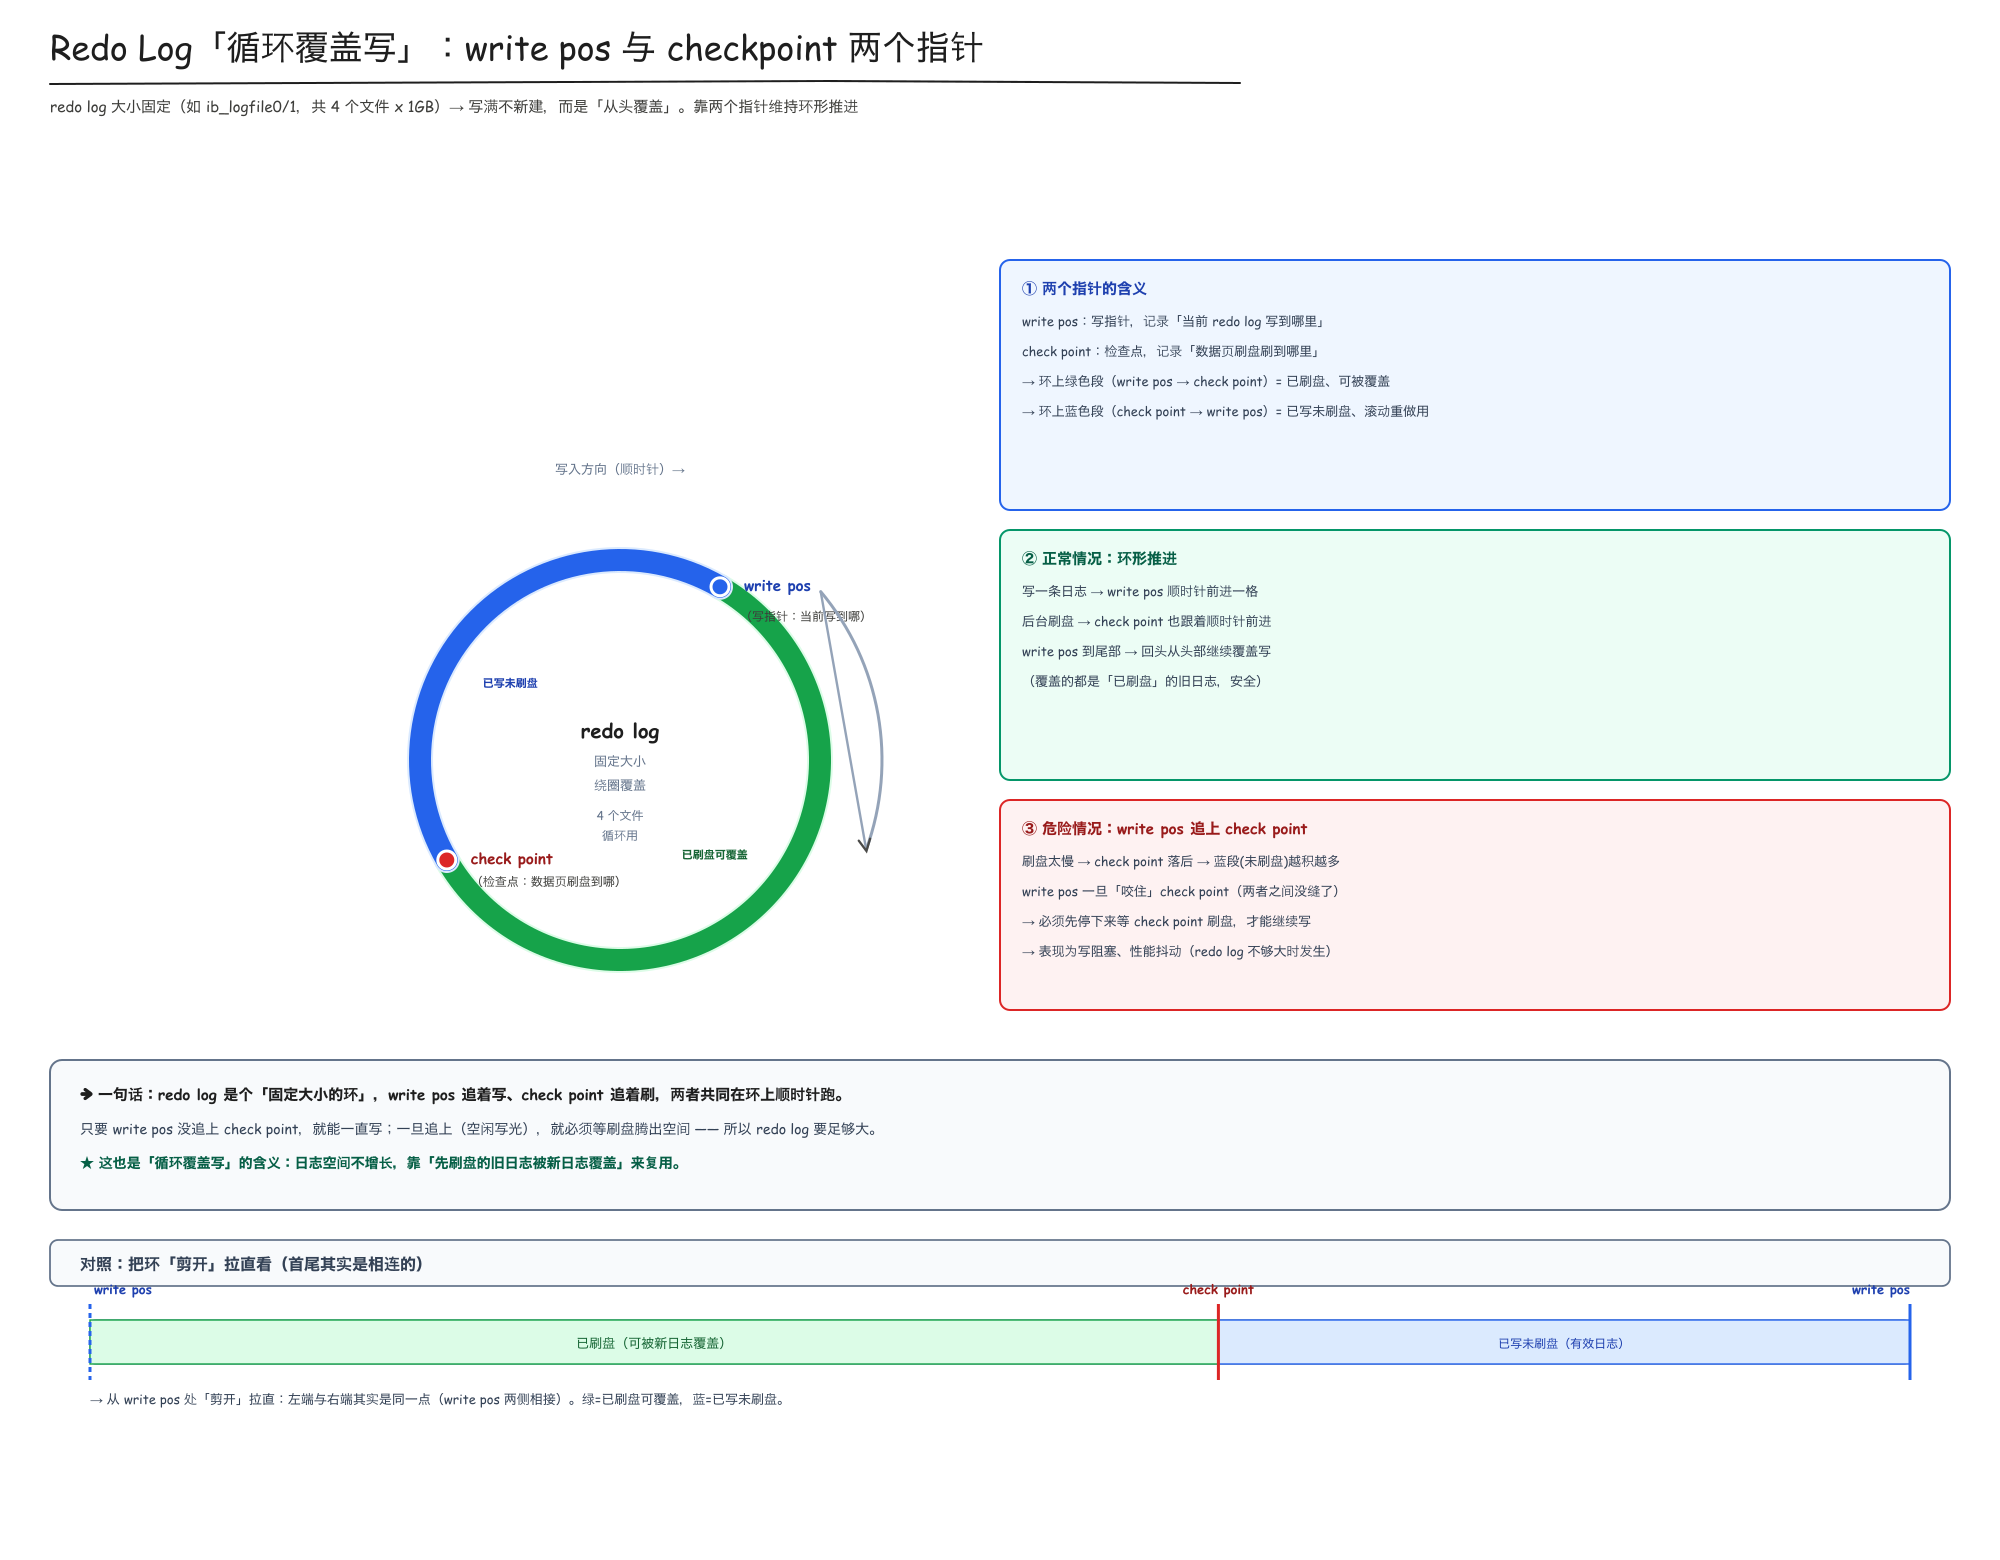
图中要点:绿段 = write pos → check point(已刷盘,可被新日志覆盖);蓝段 = check point → write pos(已写未刷盘的有效日志,宕机靠它恢复)。 正常:写日志 → write pos 顺时针前进;后台刷盘 → check point 跟着前进;走到尾部就回头覆盖绿段旧日志。 危险:刷盘太慢 → check point 落后 → 蓝段越来越长 → write pos 一旦咬住 check point,就必须停下等刷盘,写入阻塞(所以 redo log 要足够大)。
3. Binlog
MySQL Server 层日志。
作用:
1.主从复制
Master写 Binlog——Slave IO-Thread拉取主库的Binlog写入自己的Relaylog中继日志——SQL-Thread重放 SQL
2.数据恢复
昨天误删数据——拿出之前的全量备份——Binlog——恢复到误删前特点:
三种格式:
1.Statement——记录sql语句——记录内容少,只记录操作——但是从库数据可能不一致,比如id自增不一致;时间函数等。
2.Row——记录每一行数据的变化——保持绝对准确——但是记录数据量大——默认Row,因为现在存储很便宜,且同步最安全**。**
3.Mixed——混合模式,默认用statement,发现可能导致不一致的用Row。
注意:
1.逻辑日志(记录 SQL 或数据变化)
2.追加写,保留所有操作
4. Redo Log 和 Binlog 为什么同时存在?
解决的是不同层面的问题。
前者是提高写入速度和恢复数据库宕机引起的数据同步不一致问题;后者是主从复制和数据恢复的问题。
5. 两阶段提交
问题:如果Redo Log 成功但Binlog 失败,主库恢复后,事务存在。但是从库,没有 Binlog,数据不一致。
MySQL 使用两阶段提交解决(Two Phase Commit),保持强一致性。(类比分布式事务)
流程:写 Redo Log(Prepare)——写 Binlog——Redo Log Commit。保持Redo Log 与 Binlog 保持一致。联想Seata的XA模式。
6. 三种日志区别
| 7. | 所属层 | 作用 | 记录内容 | 写入方式 |
|---|---|---|---|---|
| Undo Log | InnoDB | 回滚、MVCC | 修改前数据 | 追加写 |
| Redo Log | InnoDB | 持久化、宕机恢复 | 物理页修改 | 循环写 |
| Binlog | Server | 主从复制、数据恢复 | SQL/逻辑变化 | 追加写 |
7.一条更新语句的执行流程
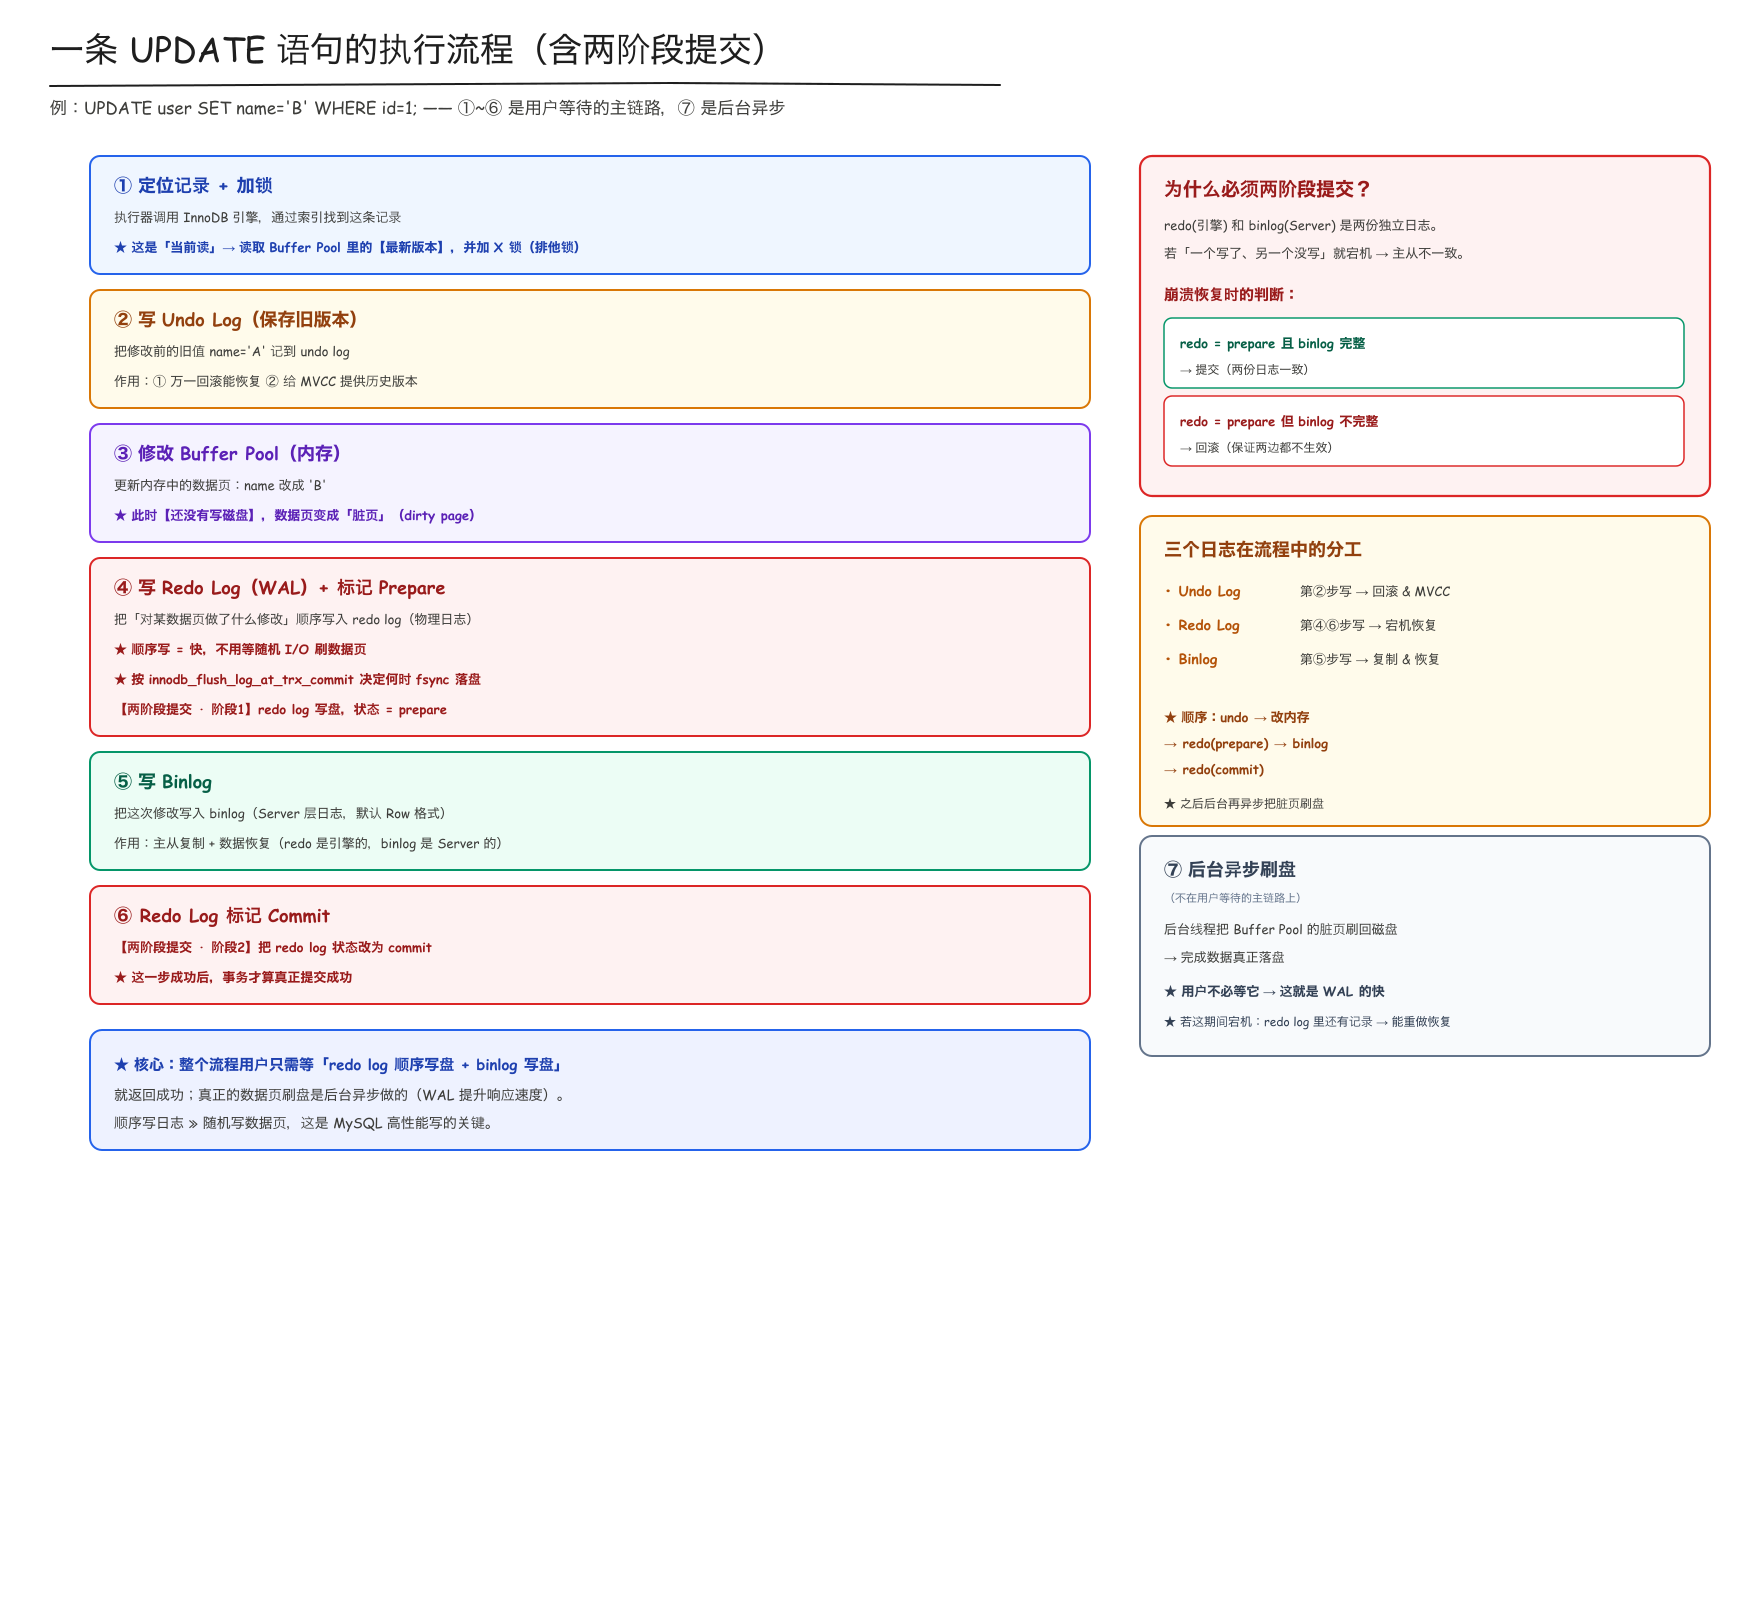
UPDATE
↓
找到Buffer Pool当中的数据页中的记录(当前读),加X锁
↓
写 Undo Log(保存旧版本),预防事务回滚和MVCC
↓
修改 Buffer Pool(内存)
↓
写 Redo Log(WAL),修改了什么内容
↓二阶段提交开始
Redo Prepare
↓
写 Binlog,属于逻辑日志,做了什么操作
↓二阶段提交结束
Redo Commit
↓
事务提交成功
↓异步后台
后台刷盘
运维排查日志
怎么排查慢SQL
慢查询日志定位满SQL——EXPLAIN查看执行计划——分析索引、全表扫描、回表、排序等问题——建立索引,优化SQL,减少扫描数据
五、高可用
思路:主从复制+分库分表
1. 主从复制
同日志中binlog过程。
流程:主库执行SQL——写入binlog——从库IO线程读取binlog——写入relay log——SQL线程执行relay log——完成同步。
2. 分库分表
不分库分表的问题
单表数据量过大导致:查询慢;索引树高度增加;单库压力大;CPU/IO压力大
分库分表方式
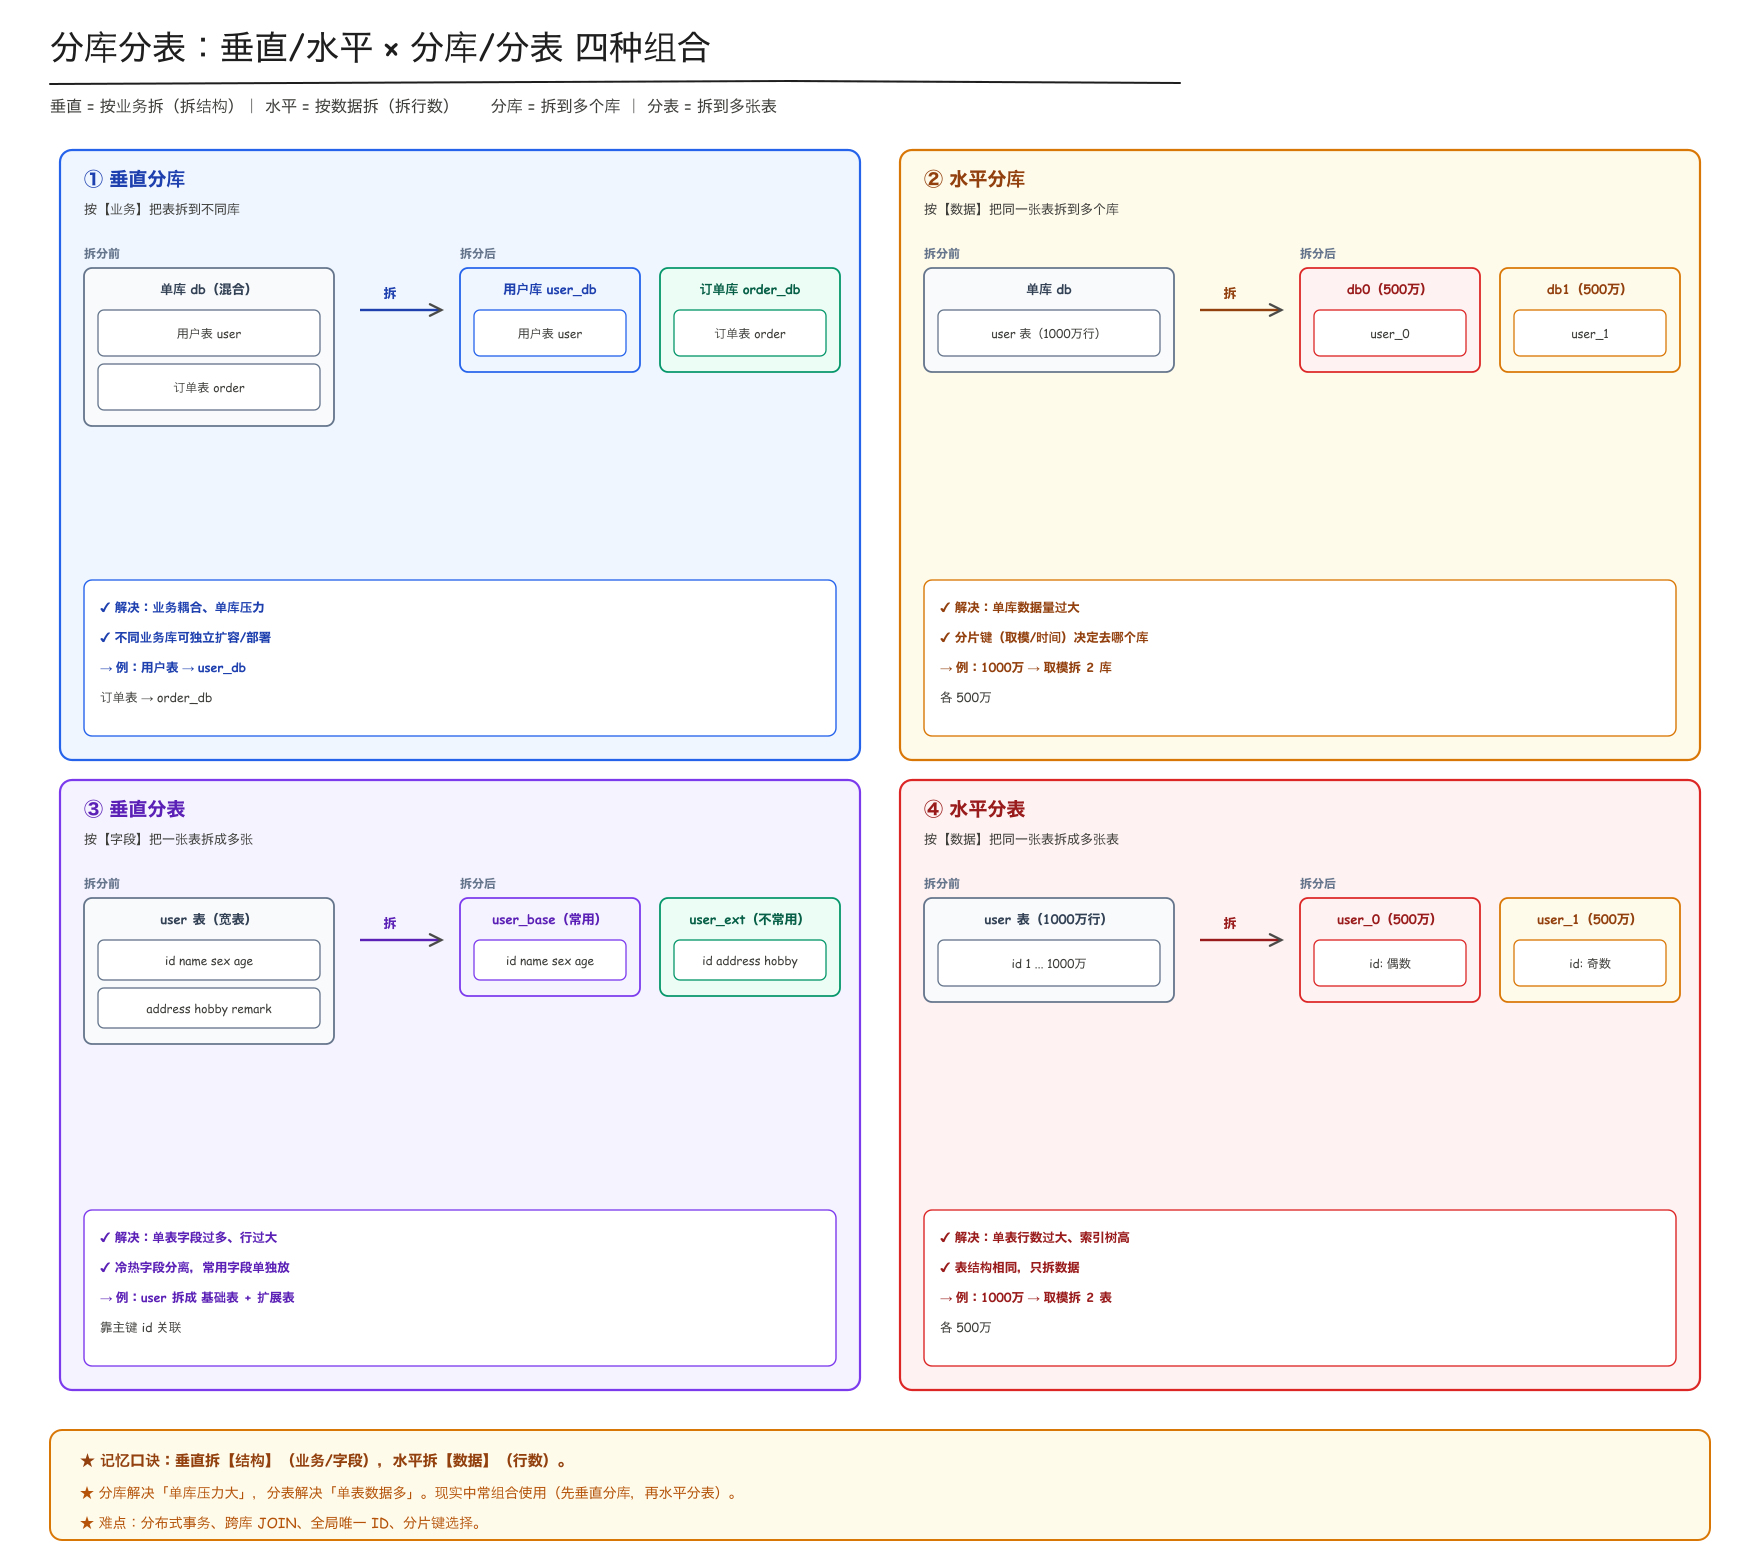
按照业务拆,解决业务耦合。
例如:
垂直分库:原来一个库里面有用户和订单两类表。现在把不同类型的表根据业务拆分到用户库和订单库。
垂直分表:原来一个表里面有用户和订单两类字段。现在把不同类型的字段根据业务拆分到用户表和订单表。
水平拆分
按照数据拆,解决数据量过大。
例如:
水平分库:原来1000万数据,现在根据取模或者时间等分库方式,把库拆成2*500万两个库。
水平分表:原来1000万数据,现在根据取模或者时间等分库方式,把表拆成2*500万两个表。