RAG 评测体系
一、体系架构
① 选框架 → ② 设计baselines → ③ 准备数据 → ④ 跑baselines → ⑤ 跑评测
二、详解
2.1 选框架
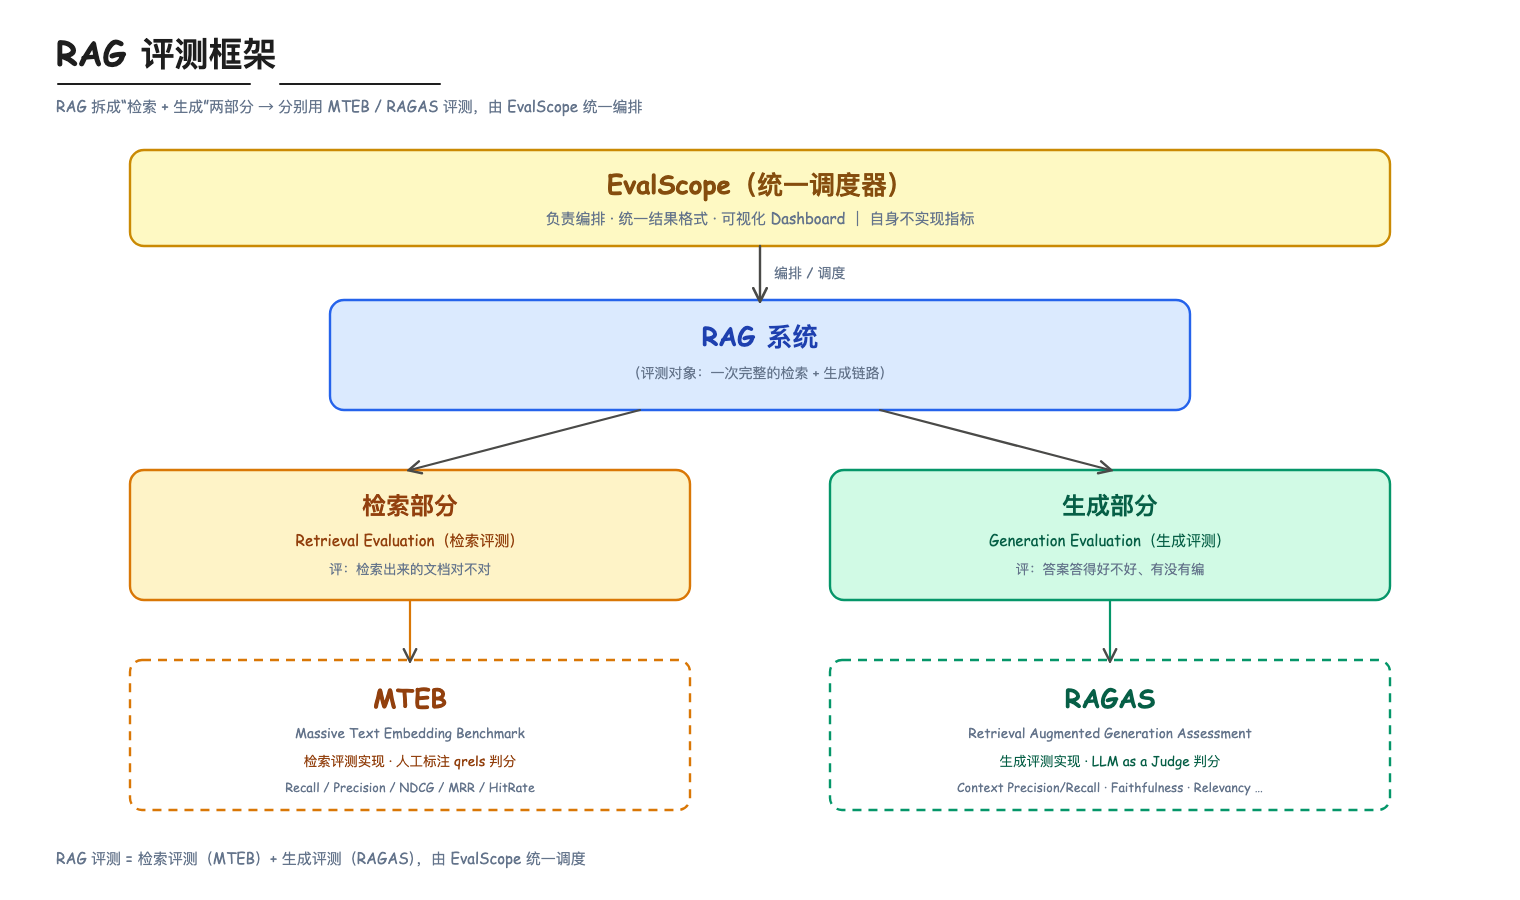
RAG 本身包含检索和大模型生成两部分,所以评测也相应拆成两部分。
框架选型的思路是:
用 EvalScope 做统一调度,底层用 MTEB 和 RAGAS 分别负责检索评测和生成评测。
EvalScope-调度器
- 是什么:阿里魔搭(ModelScope)出的评测调度框架。
- 干什么:统一编排、统一结果格式、统一可视化(Dashboard)。自身不实现任何指标。
- 类比:像"考试组织方"—— 不命题、不批卷,只负责安排考什么、汇总成绩。
MTEB-检索评测框架
- 全称:Massive Text Embedding Benchmark(大规模文本嵌入基准)。
- 是什么:给文本嵌入模型做统一横评的基准,最有名的是检索任务。
- 评什么:检索出来的文档对不对(用人工标注的 qrels 判分)。
- 输出指标:Recall@K / Precision@K / NDCG@K / MRR / HitRate。
RAGAS-生成评测框架
- 全称:Retrieval Augmented Generation Assessment。
- 是什么:RAG 生成质量的评测框架,以 LLM as a Judge 为核心。
- 评什么:答案答得好不好、有没有编、检索内容够不够支撑。
- 输出指标:ContextPrecision / ContextRecall / Faithfulness / AnswerRelevancy / AnswerCorrectness。
2.2 设计 baselines
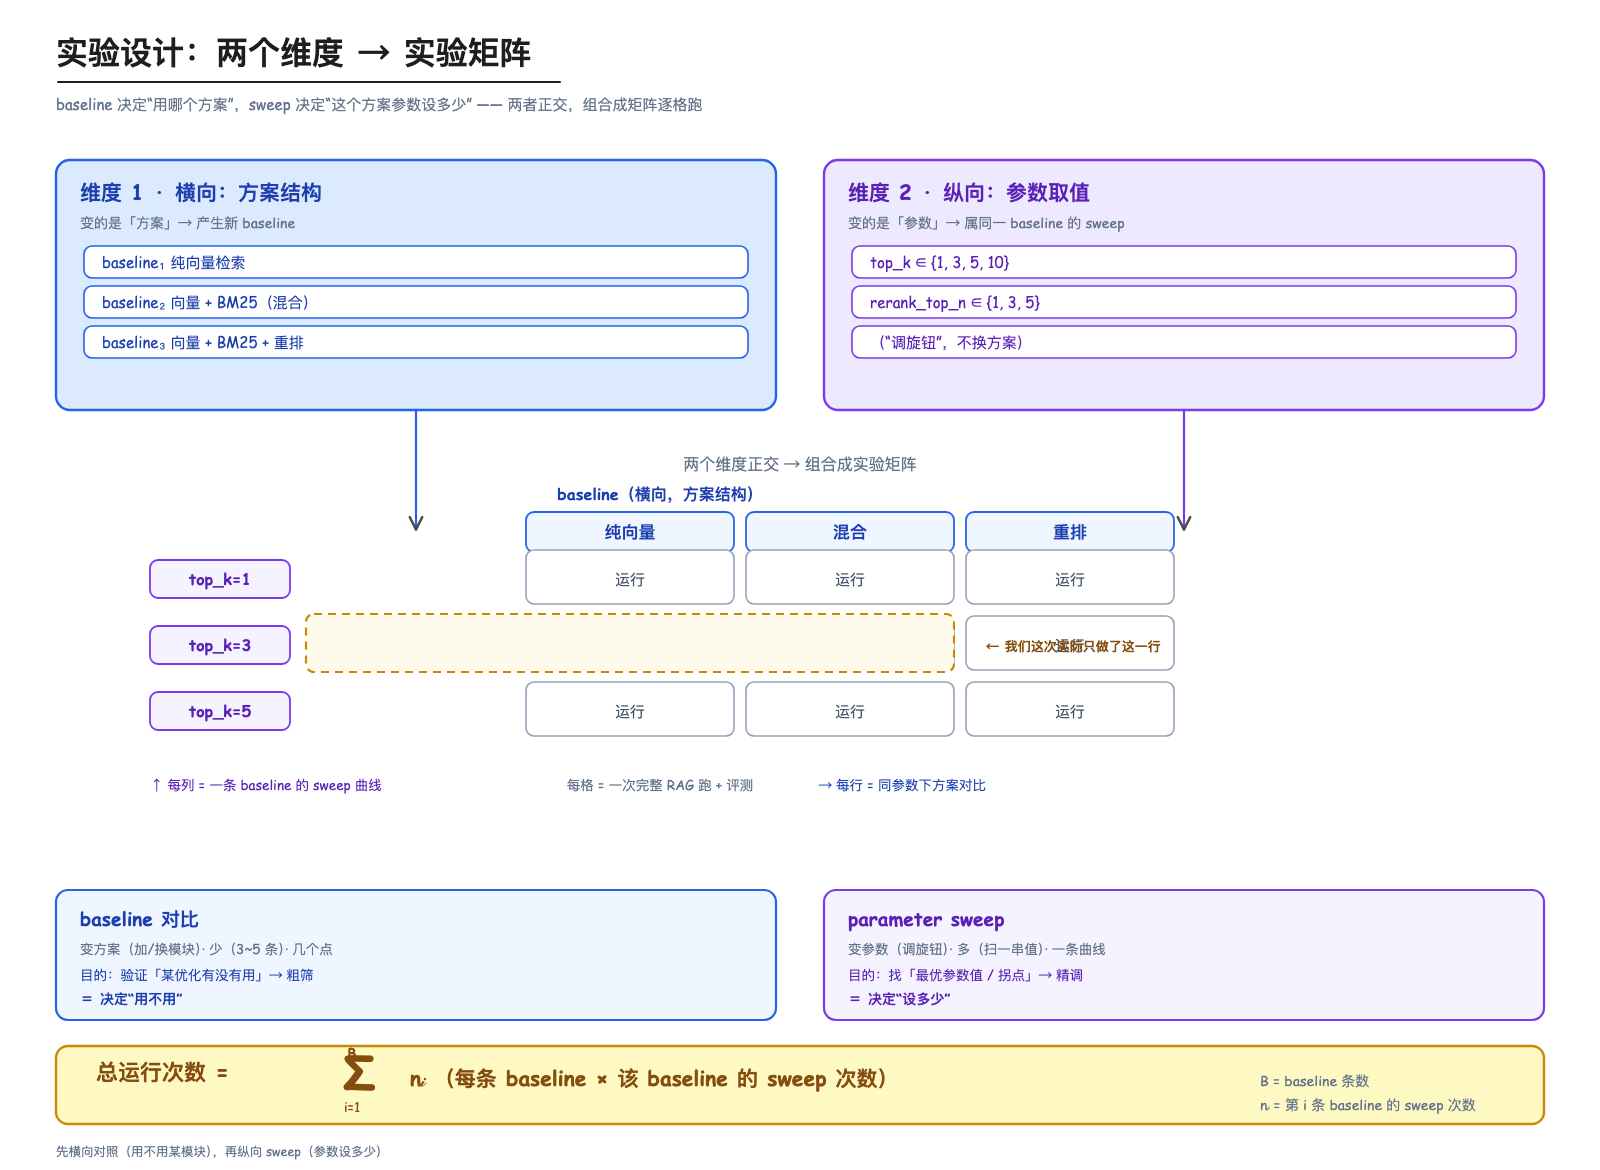
从两个正交维度设计 baseline:
- 横向 · 方案结构:变方案 → 产生新 baseline(比如纯向量 / 向量+BM25 / 向量+BM25+重排)
- 纵向 · 参数取值:变参数 → 属于同一 baseline 的parameter sweep(比如top_k、rerank_top_n)
两个维度正交组合 → 实验矩阵(每格一次完整 RAG 跑 + 评测),矩阵总格数 = 各条 baseline 的 sweep 次数之和(Σ)。
baseline vs parameter sweep
| baseline 对比 | parameter sweep | |
|---|---|---|
| 变什么 | 方案结构(加/换模块) | 参数取值(调旋钮) |
| 数量 | 少(3~5 条) | 多(一个参数扫一串) |
| 结果 | 几个点对比 | 一条曲线 |
| 目的 | 验证"某优化有没有用" | 找"最优参数值/拐点" |
| 关系 | 粗筛(用不用) | 精调(设多少) |
先横向对照(决定用不用某模块),再纵向 sweep(决定参数设多少)。
2.3 准备数据
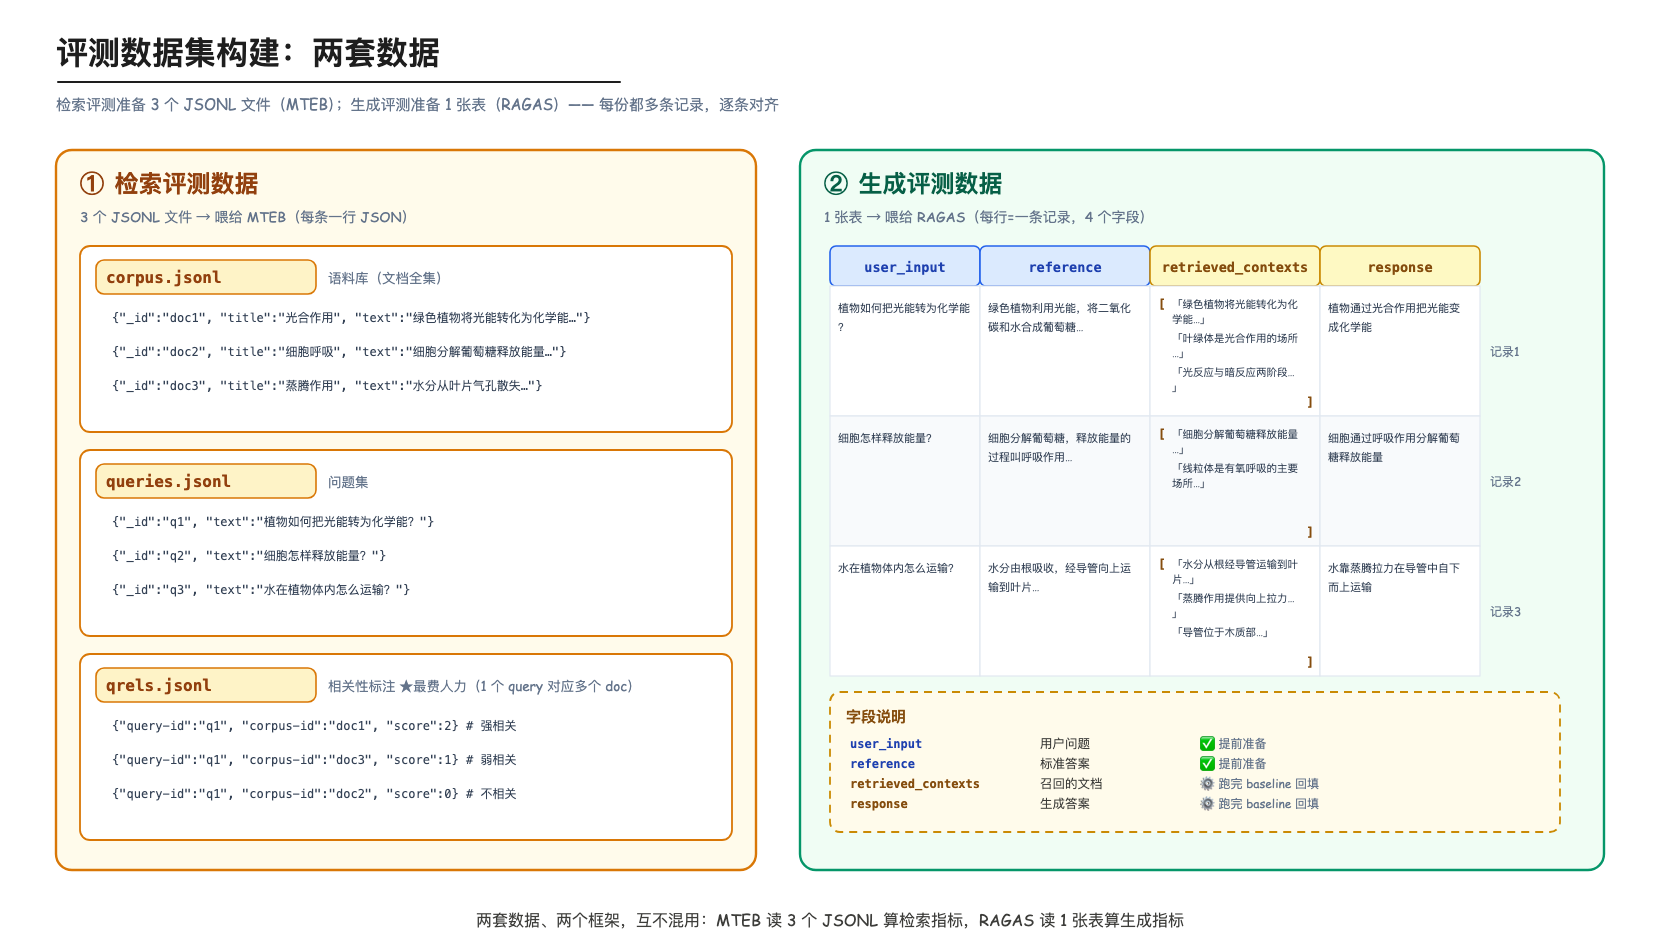
实际上就是 两套评测数据集的构建:检索评测一套(3 个 JSONL,喂 MTEB)、生成评测一套(1 张表,喂 RAGAS)。
关键点:
- 检索三件套:
corpus.jsonl(语料库)、queries.jsonl(问题集)、qrels.jsonl(相关性标注 ★最费人力,不是答案)。 - 生成四字段:
user_input/reference可提前准备;retrieved_contexts(召回的文档,多条)/response需跑完 baseline 回填——但要先把表建好。 - 对齐:每份都多条记录,逐条对齐(q1 ↔ doc1 ↔ 问题1 ↔ 答案1)。
2.4 跑 baselines
对照实验矩阵,逐格执行每次 rag baseline。
每一格执行:
   问题 → 【检索】→ 召回文档(contexts)
        → 【生成】→ 答案(response)
        ↓
   回填到"生成数据表"的对应空位
跑完后:
- 生成数据表:
retrieved_contexts+response已回填齐全 → 4 字段凑齐,可喂 RAGAS - 检索数据表:不用回填(corpus / queries / qrels 是只读的比对基准)。系统跑出的实际排名只用于和 qrels 比对算指标(Recall@K / NDCG@K 等),不写回这三个文件。
2.5 跑评测框架,计算指标
分两个框架的两套指标。
MTEB 指标
| 指标 | 含义 |
|---|---|
| Recall@K | Top-K 命中相关文档的比例 |
| Precision@K | Top-K 里相关文档的比例 |
| NDCG@K | 带相关度等级的排序质量(最常用) |
| MRR | 第一个相关文档的排名倒数 |
| HitRate@K | 是否至少命中一个相关文档 |
检索指标的本质:qrels 给出「哪些文档相关」(期望),系统给出「实际排名」,两者一比。而且不是算一次,是每个 query 各算一遍,再取平均。
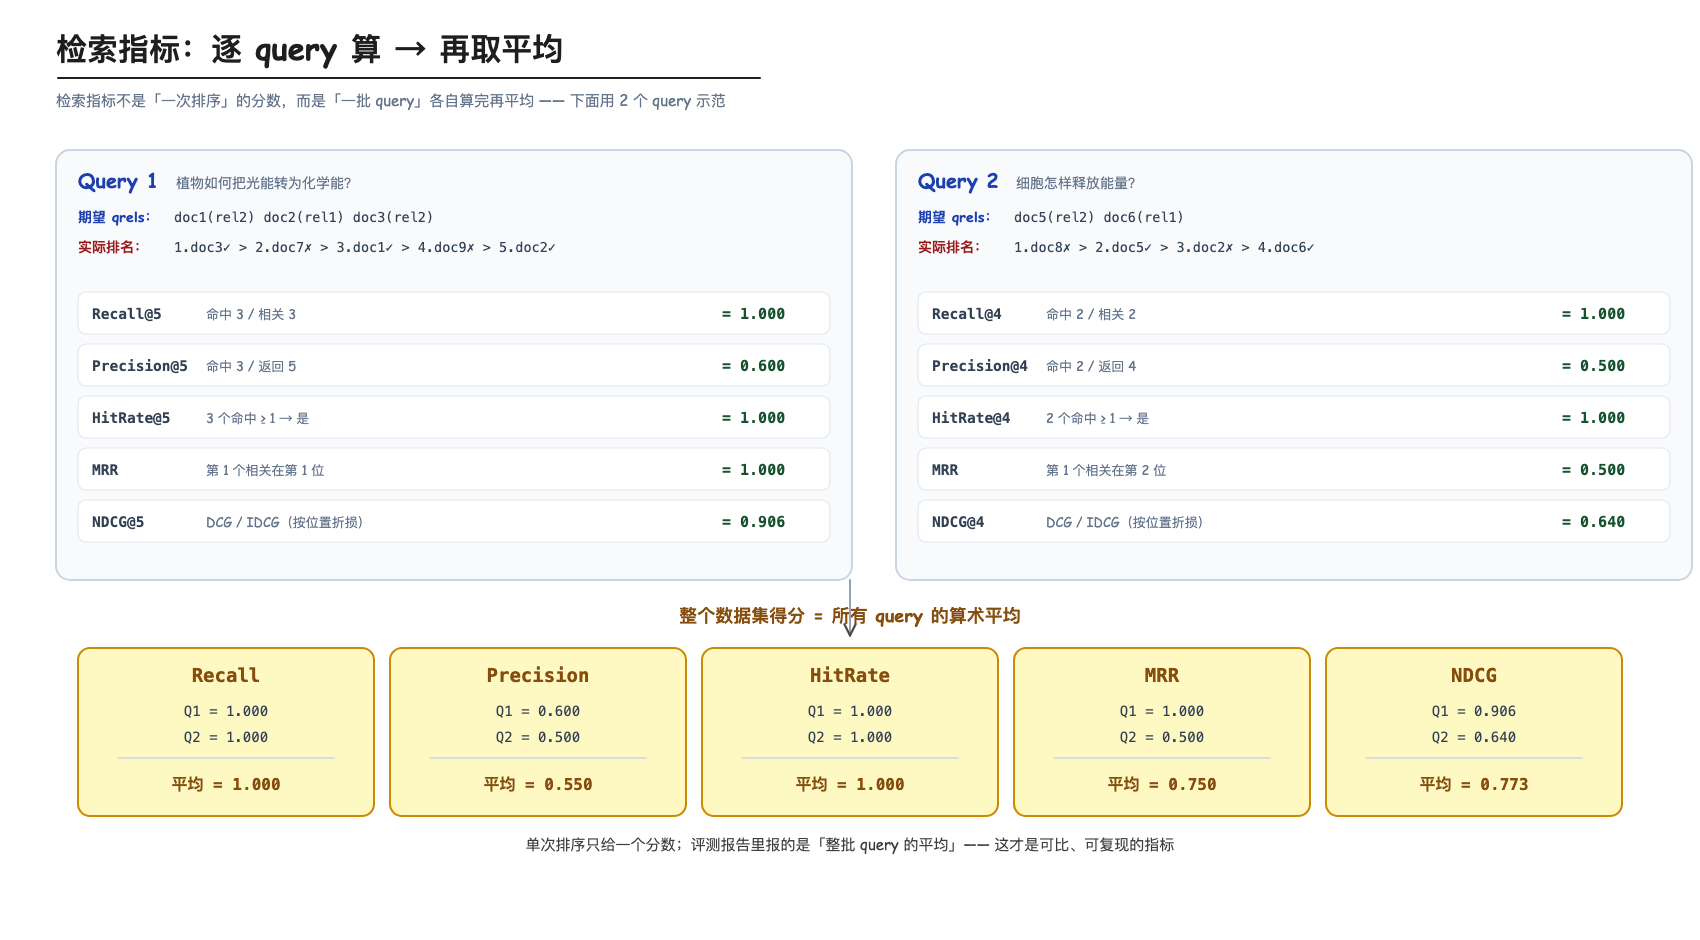
5 个指标的算法:
| 指标 | 算法 | 一句话含义 |
|---|---|---|
| Recall@K | 命中的相关文档数 / 全部相关文档数 | 相关文档找全了没有 |
| Precision@K | 命中的相关文档数 / 返回的 K 个 | 返回的结果准不准(掺没掺噪声) |
| HitRate@K | 实际结果里是否至少命中 1 个相关文档(是=1,否=0) | 有没有命中相关文档 |
| MRR | 1 / 第一个相关文档在实际检索结果里的排名 | 第一个对的结果排得靠不靠前 |
| NDCG@K | DCG / IDCG(按位置折减的累计相关度除以理想值) | 整体排序质量好不好(结合位置与相关等级) |
其中 NDCG 的 DCG 用 Σ (2^rel − 1) / log₂(位置+1),IDCG 是"把相关文档排到最前"的理想 DCG。
注意:
- Recall 高但 Precision 低:找全了但掺了不少噪声。
- NDCG 最常用:因为它同时考虑"命中"和"排在多前面"。
- 整批平均才有意义:单个 query 的分数波动大,报告里的指标 = 所有 query 的平均。
RAGAS 指标
| 指标 | 比较对象 | 含义 |
|---|---|---|
| ContextPrecision | 上下文 ↔ 问题 | 检索准不准(LLM 判) |
| ContextRecall | 上下文 ↔ 标准答案 | 该有的信息覆盖了吗 |
| Faithfulness | 回答 ↔ 上下文 | 答案忠于上下文吗(编没编) |
| AnswerRelevancy | 回答 ↔ 问题 | 答案切不切题 |
| AnswerCorrectness | 回答 ↔ 标准答案 | 答案对不对 |
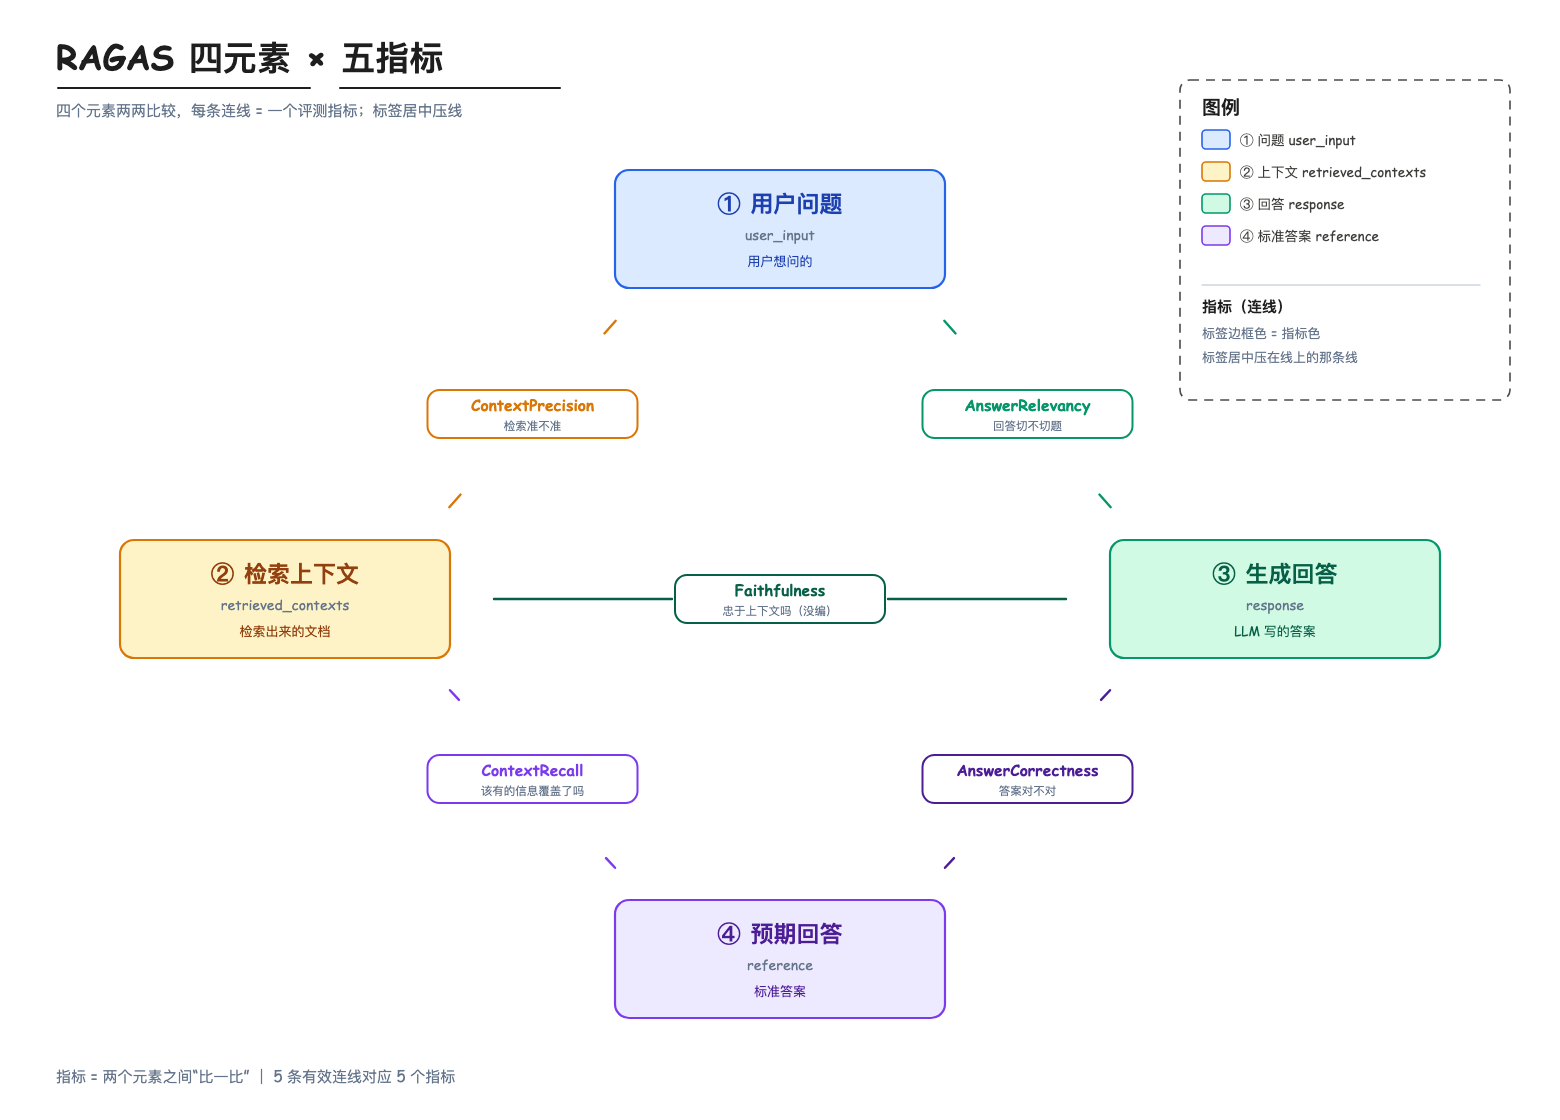
每个指标 = 两个元素的关系。
出自 RAGAS 官方源码。核心规律:LLM 做局部判断 + 确定性公式聚合。
| 指标 | 步骤 | 公式 |
|---|---|---|
| Faithfulness | ① LLM 拆答案成陈述句 → ② LLM 逐句判"能否从上下文推出" | 忠实句数 / 总句数 |
| AnswerRelevancy | ① LLM 只看答案反推"这答案在回答什么问题" → ② 算假想问题与原问题的余弦相似度 | mean(余弦相似度) |
| ContextPrecision | ① LLM 逐文档判是否相关 → ② 算平均精度 | Σ(相关位置k: 前k个中的相关数/k) / 总相关数 |
| ContextRecall | ① 把标准答案拆句 → ② LLM 逐句判"能否归因于上下文" | 被覆盖句数 / 标准答案总句数 |
| AnswerCorrectness | ① 双方拆句 → ② LLM 分 TP/FP/FN 算事实 F1 | 0.75 × 事实F1 + 0.25 × 语义相似度 |
联系
两部分指标不是绝对分割,而是有重合的。
最明显的重合:ContextPrecision / ContextRecall vs MTEB 的 Precision / Recall —— 都在衡量"召回得对不对",只是思想不同:
| MTEB 的 Precision/Recall | RAGAS 的 ContextPrecision/ContextRecall | |
|---|---|---|
| 判断"相关"依据 | 人工标注 qrels(标准答案) | LLM 现场判断 |
| 参照物 | 文档 ID 标注 | 标准答案(自然语言) |
| 视角 | 检索器视角 | 生成器视角 |
所以指标按评测对象可再归位:
- 评检索的:MTEB 全部 + RAGAS 的 Context 系列(后者本质也在评检索,只是换成 LLM 判)
- 评生成的:RAGAS 其余三个(Faithfulness / AnswerRelevancy / AnswerCorrectness)
评测方法架构思考
人工评测  ─────►  LLM as a Judge ─────► 传统自动指标  ──►  精确匹配
(最贵/最可信)     (便宜/较可信)          (便宜/死板)      (最便宜/最死板)
  人打分           大模型打分             BLEU/ROUGE/余弦   正则/匹配
| 方法 | 本体系中对应 |
|---|---|
| 人工评测 | MTEB 的 qrels(人工标注相关性) |
| LLM as a Judge | RAGAS 全部指标 |
| 传统自动指标 | NDCG/MRR、余弦相似度 |
成熟方案是三重校验:自动指标打底 + LLM Judge 规模化 + 人工抽样校准。
三、上线与迭代
评测不是终点。 离线分数只是入场券,真正决定成败的是上线后怎么盯、怎么退、怎么再往前走。
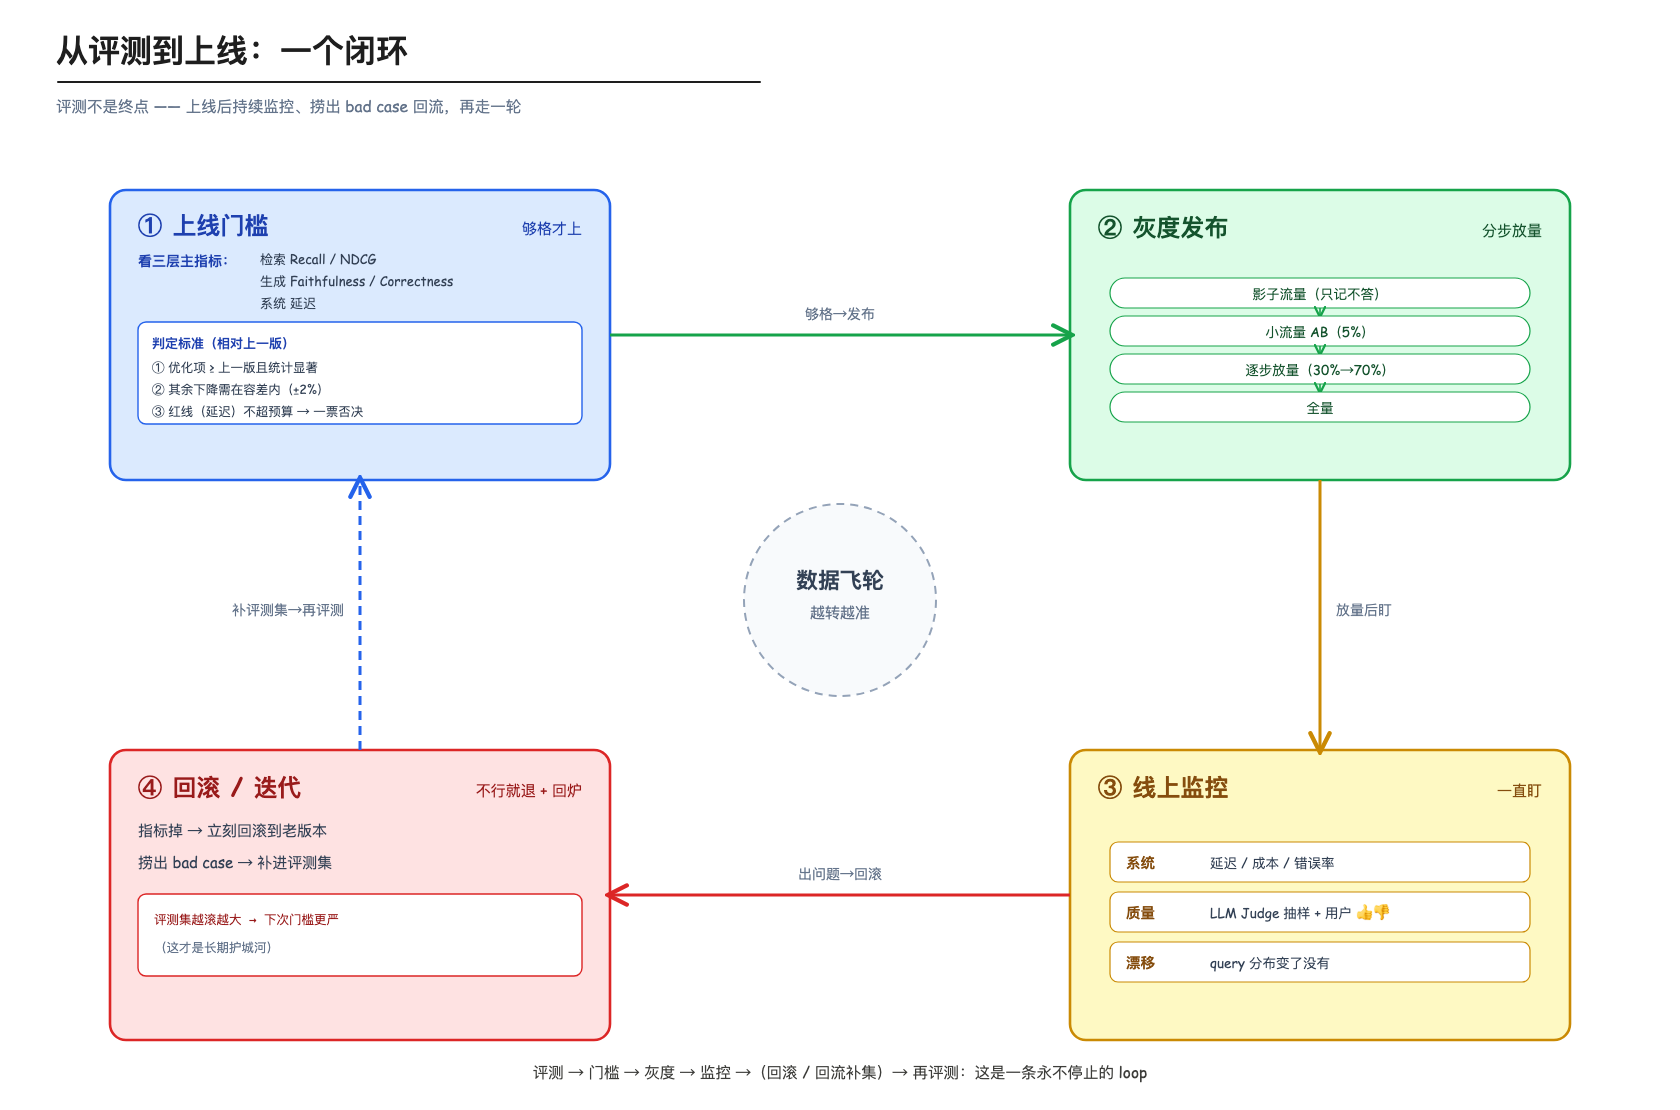
① 上线门槛 —— 够格才上(放行标准)
先明确看哪几个指标,生产里只看三层主指标:
| 层 | 主指标 | 看什么 |
|---|---|---|
| 检索 | Recall / NDCG | 找全了没、排序好不好 |
| 生成 | Faithfulness / AnswerCorrectness | 有没有编 + 答得对不对 |
| 系统 | 延迟 | 快不快 |
Faithfulness 只保证"不瞎编",但不保证"答对"(可能忠于上下文却答偏);配上 AnswerCorrectness(跟标准答案比)才完整。
放行标准(跟上一版比,即"相对基线法"):
- 优化项 ≥ 上一版,且统计显著(防 0.901 vs 0.900 的抖动误判)。
- 其余指标允许下降,但在容差内(如 ±2%)。
- 红线(延迟等)不劣化 —— 一票否决。
不到线就不上线,回炉。
② 灰度发布 —— 分步放量
不一次全量,分四步:影子流量(只记录不真答,零风险验数据)→ 小流量 AB(5%,对比新旧)→ 逐步放量(30% → 70%)→ 全量。每一步都有观测点,不稳就停。
③ 线上监控 —— 一直盯
- 系统:延迟、成本、错误率。
- 质量:LLM Judge 抽样打分 + 用户反馈(👍👎)。
- 漂移:线上 query 的分布是不是变了。
④ 回滚 / 迭代 —— 不行就退 + 回炉
- 指标掉了 → 立刻回滚到老版本(所以灰度是关键保险)。
- 捞出线上 bad case → 补进评测集 → 下次门槛更严。
闭环的意义:评测 → 门槛 → 灰度 → 监控 → 回滚/回流补集 → 再评测 周而复始。评测集越滚越大、门槛越卡越准,这才是长期护城河 —— 就是常说的数据飞轮。