企业级 RAG:离线构建流水线
本文聚焦 RAG 的离线构建链路:文档解析、Chunking、Metadata Enrichment、Embedding 与索引构建。
一、整体结构
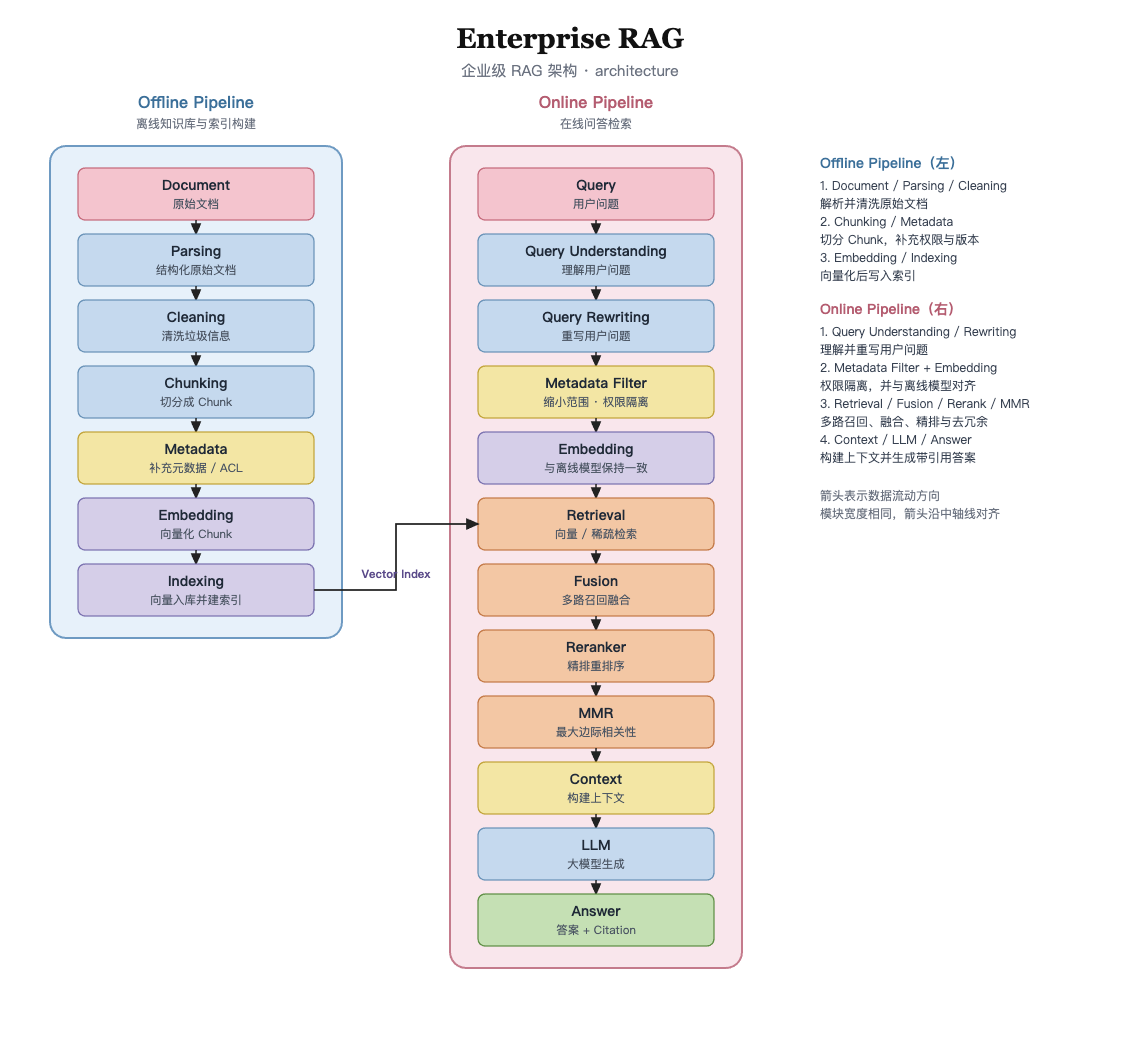
二、离线构建(Offline Pipeline)
Document
格式有PDF、Markdown、DOCX、企业 Wiki(飞书、语雀(阿里)) 。
Parsing
决策层两种方案
在 Parsing 这一层,我们当时考虑过两种方案。
- 把文档直接交给 LLM,让模型判断文档格式,再选择对应的解析策略。
- 第二种是程序准确判断+路由。也就是自己实现一个 Deterministic Document Router,即确定性文档路由,根据文件扩展名以及文档本身的一些确定性特征进行路由。
最终我们选择第二种,主要考虑到两点:
- 文件类型可以由程序准确判断。
- 额外调用 LLM,成本和延迟更高,高并发场景下也不稳定,容易产生瓶颈。
文件解析策略
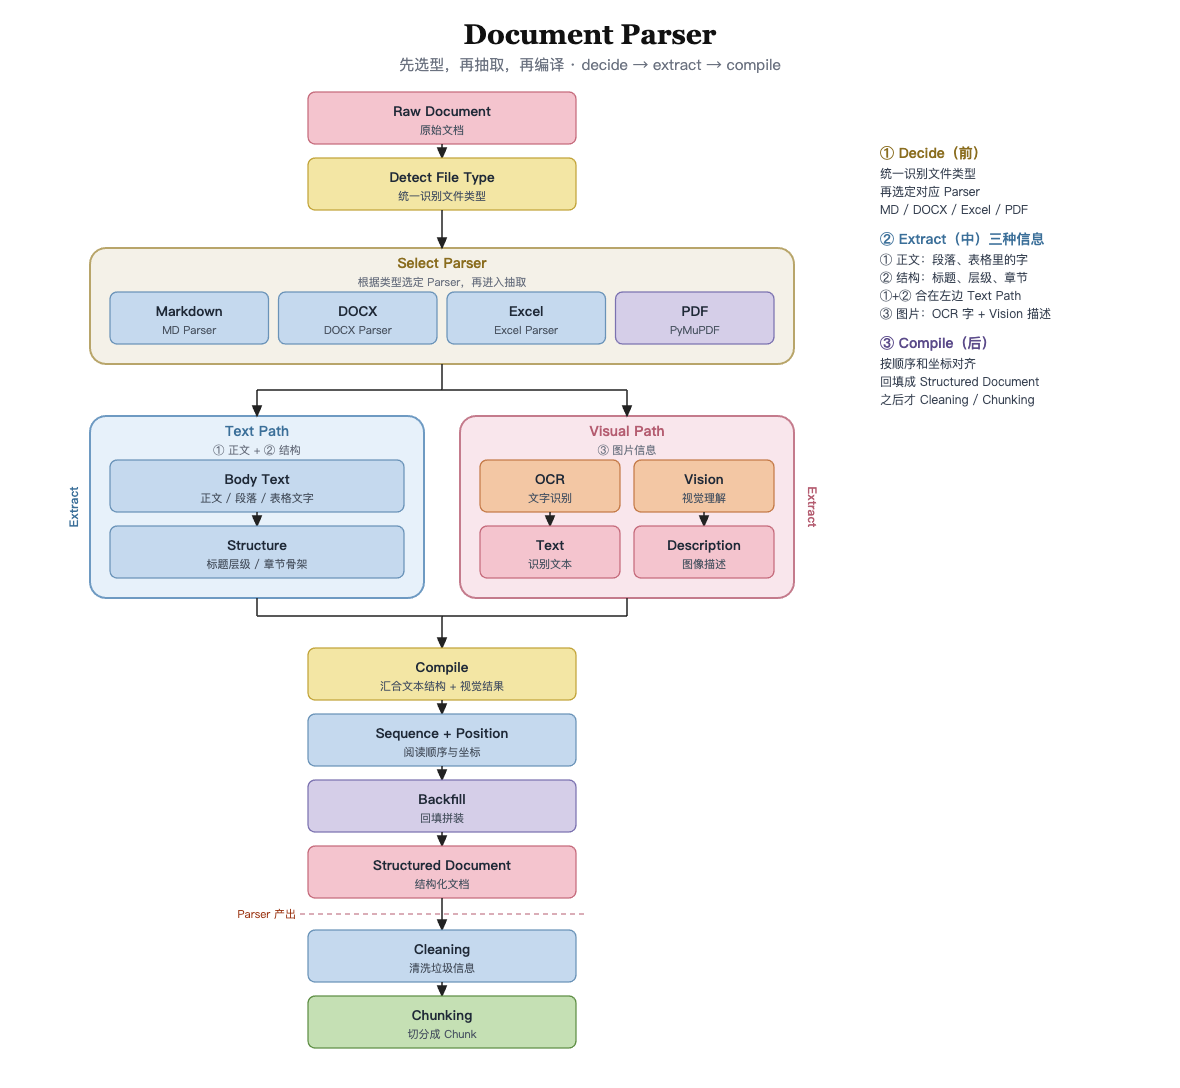
Raw Document ↓ Document Extraction ↓ ┌───────────────────┴───────────────────┐ │ │ 根据文件类型选择 Parser 提取 Visual Elements │ │ ┌──────┼──────┬──────┐ ┌─────┴─────┐ ↓ ↓ ↓ ↓ ↓ ↓ Markdown DOCX Excel PDF OCR Vision ↓ ↓ ↓ ↓ ↓ ↓ MD DOCX Excel PyMuPDF Text Description Parser Parser Parser │ └─────┬─────┘ │ │ └───────────┬───────────┘ ↓ Text / Structure + Visual Result ↓ Sequence + Position ↓ 回填 ↓ Structured Document ↓ Cleaning ↓ Chunking
采用统一的 Document Extraction Pipeline。
首先对输入文档进行解析,将其中的文本、标题、表格等结构化内容提取出来,同时识别并提取图片等视觉 Element,并保留它们在原始文档中的 Page、Sequence、Position 等信息。
对于提取出来的视觉 Element,我们再根据内容特征选择对应的处理方式。
如果是扫描件中的文字,使用 OCR 将图片转换成文本;
如果是架构图、流程图、图表等需要理解视觉语义的内容,则调用 Vision Model 进行分析,生成对应的图片描述。
处理完成之后,再根据原始的 Page 和 Element Sequence 将这些结果回填到原始的 Structured Document 中。
并发解析和顺序保证整个过程中,文本解析、图片提取、OCR 和 Vision 等任务都可以按照 Page / Element 粒度并发执行。由于不同任务的执行时间可能不同,我们会保留 document_id、page_sequence、element_sequence 等信息,最终按照原始 Sequence 重新排序并回填,保证解析后的 Structured Document 与原始文档的内容顺序一致。
结构化文档示例{ "doc_id": "employee-handbook-v3", "source": { "filename": "handbook.pdf", "parser": "pdf", "pages": 12 }, "tree": [ { "id": "h1", "type": "heading", "level": 1, "text": "员工管理制度", "page": 1, "bbox": [72, 80, 520, 110], "order": 1 }, { "id": "h2", "type": "heading", "level": 2, "text": "第二章 考勤", "parent": "h1", "page": 3, "bbox": [72, 140, 400, 165], "order": 8 }, { "id": "p12", "type": "paragraph", "text": "病假最长不得超过 30 天。", "parent": "h2", "page": 3, "bbox": [72, 180, 520, 210], "order": 9 }, { "id": "t3", "type": "table", "parent": "h2", "page": 4, "bbox": [72, 240, 520, 420], "order": 15, "cells": [ ["假别", "最长天数", "材料"], ["病假", "30", "医院证明"], ["年假", "10", "无需"] ] }, { "id": "img2", "type": "figure", "parent": "h2", "page": 4, "bbox": [80, 450, 300, 620], "order": 16, "ocr_text": "请假流程:提交 → HR 审核 → 归档", "description": "请假流程图,从员工提交申请到 HR 审核结束。", "caption": "图 2-1 请假流程" } ] }
Cleaning
Cleaning 的核心原则是去除噪声,但不破坏文档的语义和结构,为后面的 Chunking 做准备。
比如重复的 Header/Footer、页码、多余空白、OCR 产生的明显格式问题以及重复内容。同时会根据 Element 类型进行处理,例如 Table、Code、Heading 等不能简单当成普通文本清洗,需要保留它们原有的语义结构。
Chunking
解决什么问题
原始文档可能有几十页甚至几百页,不能直接整个文档做 Embedding、整个文档拿去检索。
所以需要:把一个大的 Structured Document 切成多个语义相对完整、适合检索的 Chunk。
一个好的chunk:语义完整 + 上下文足够 + 不包含大量无关内容。
切分策略
- 优先进行结构化切分:根据结构化文档的标题、章节等结构进行语义切分成一个个chunk;
- 二次大小切分:如果某个chunk超过了设定的 chunk Token Size,再进行二次大小切分,设置少量 Overlap 避免边界信息丢失。
- 高级切分策略:
- 父子切分:
- 核心矛盾:chunk过大,上下文完整,但是召回率低;chunk过小,上下文缺失,但是召回率高。
- 所以我们采用**Parent-Child,**把较大的 Section 作为 Parent,再切成较小的 Child,Child 建立向量索引用于精准召回,这样同时通过 parent_id 找回对应 Parent,为 LLM 提供更完整的上下文。
- 语意切分: Semantic Chunking,**主要解决 Chunk 边界的问题。**用embadding模型对计算相邻句子的语意相似度,当出现明显下降时,认为主题发生变化,在这个位置建立chunk边界。
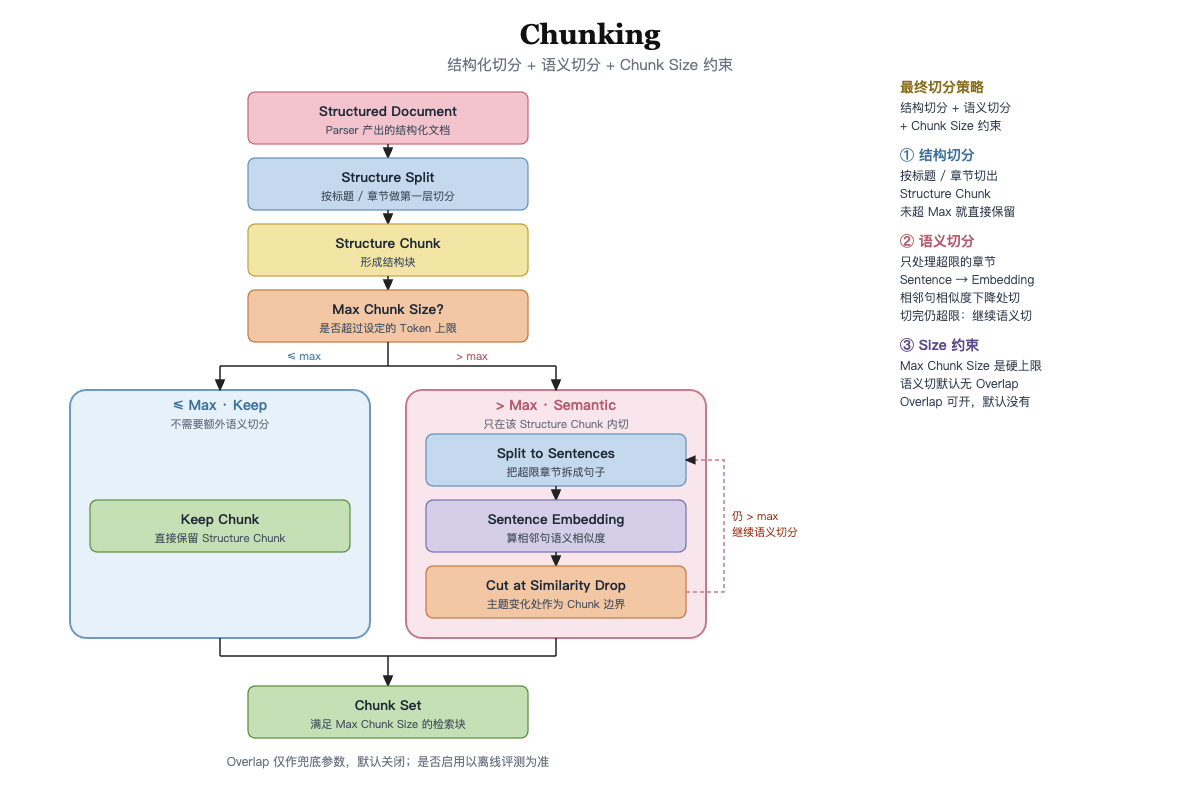
最终解析策略
“在设计 Chunking 方案的时候,我们参考了 亚马逊Amazon Bedrock 的 Semantic Chunking 方案。它的核心思路是对所有句子进行 Embedding,通过相邻句子之间的语义相似度变化来识别 Semantic Boundary,再结合 Max Token Size 形成最终 Chunk。我们没有直接照搬这种对整个文档进行 Semantic Chunking 的方式,而是在这个基础上做了一层优化”
结构化切分 + 语意切分 + chunk size约束
- 首先根据文档本身的结构进行第一层切分,形成 Structure Chunk。如果这个 Chunk 没有超过我们设定的 Max Chunk Size,就直接保留,不需要额外做语义切分。
- 如果某个 Structure Chunk 比较大,超过了 Max Chunk Size,我们才在这个 Structure Chunk 内进行 Semantic Chunking。具体会把内容拆成 Sentence,对 Sentence 做 Embedding,然后计算相邻 Sentence 的语义相似度,找到语义变化明显的位置作为候选边界。如果切分后依然超过max chunk size,继续语意切分。
- 一般来说通过语意切分不需要overlap,但是我们保留了这个参数坐兜底,可以通过离线评测效果决定是否启用,补充语意,默认没有。
Metadata Enrichment
用作检索时的过滤和权限控制。
文档级
来源文档本身:document_id、name、文件类型和版本
结构级
来源Parser后:page、section、heading、chunk_index
业务级
来源业务系统:tenant、user_id,部门和权限范围
注意:metadata本身不会被向量化,而是chunk content
Embedding
把文本转换成向量,让机器可以用数学空间中的“距离/相似度”来衡量 Query 和 Chunk 的语义相关性,从而支持后续语义检索。
模型选择
Embedding 模型不是单纯按照公开榜单选择,而是先根据语言、领域和成本筛选候选模型,再用我们自己的 Query-Document 数据集进行离线检索评测,综合 Recall、延迟和成本选择最终模型。
注意:Query 和 Document 必须使用一致的 Embedding 模型,保证 Query Vector 和 Document Vector 位于同一个向量空间。
向量维度也不是越高越好,维度越高 → 表达能力可能更强,但存储、计算、索引成本也会上升。
embedding模型更换,历史数据如何处理?
新模型上线
↓
重新 Embedding 所有历史 Chunk
↓
建立新的 Index
↓
灰度验证
↓
切换到新 Index
Indexing
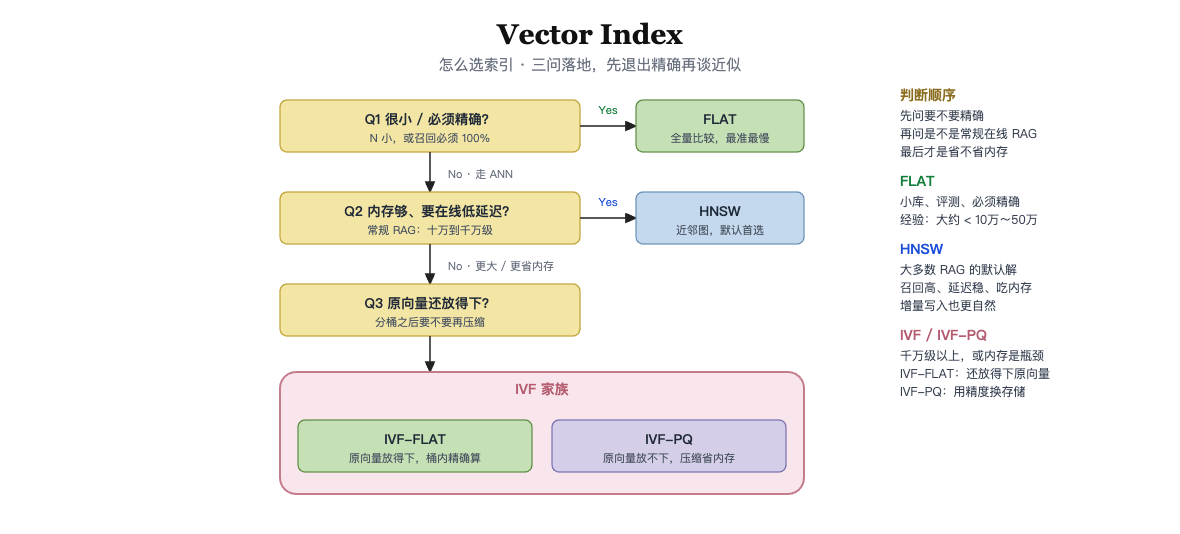
把 Chunk 的向量建立高效的检索索引,让后面的 Retrieval 不需要把整个Milvus库一个个向量比较。
两种经典的搜索策略:Exact Search和 ANN。注意它们都属于语义检索。
Exact Search
**精确搜索,**Recall:最高,速度:较慢
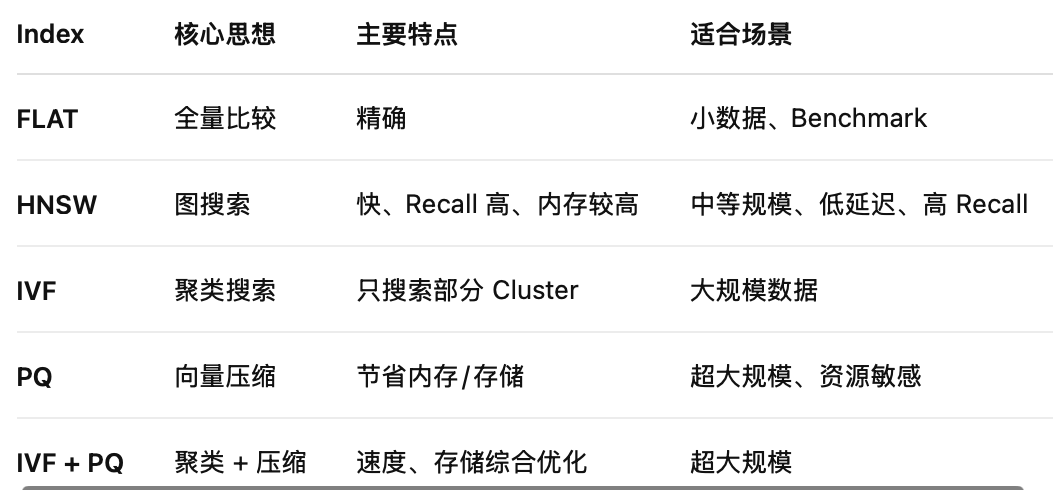
FLAT/Brute Force最简单的精确搜索。全表扫描/暴力搜索。
例子:
用户问:“Java 线程池核心线程数怎么配置?”
先embadding:
q = [0.13, 0.81, 0.25, ...] ← 768维
Query Vector
 │

 ├── 和 Vector 1 算相似度 → 0.31

 ├── 和 Vector 2 算相似度 → 0.82

 ├── 和 Vector 3 算相似度 → 0.21

 ├── ...

 └── 和 Vector 1,000,000 算相似度 → 0.76

                          ↓

                     排序 / TopK

                          ↓
假设已经做过正则化,每次点积都会计算768次乘法和767次加法
score = q1v1 + q2v2 + ... +qn*vn
粗略计算量:
1,000,000 * 768
这还只是一次扫描,所以我们要建立索引,如hnsw。
建立索引之后,不再逐个计算 100 万个向量,而是先根据索引进入图搜索,根据配置参数ef缩小搜索范围,平衡搜索的速度和质量。
但这并不意味着flat/brute force就无用。
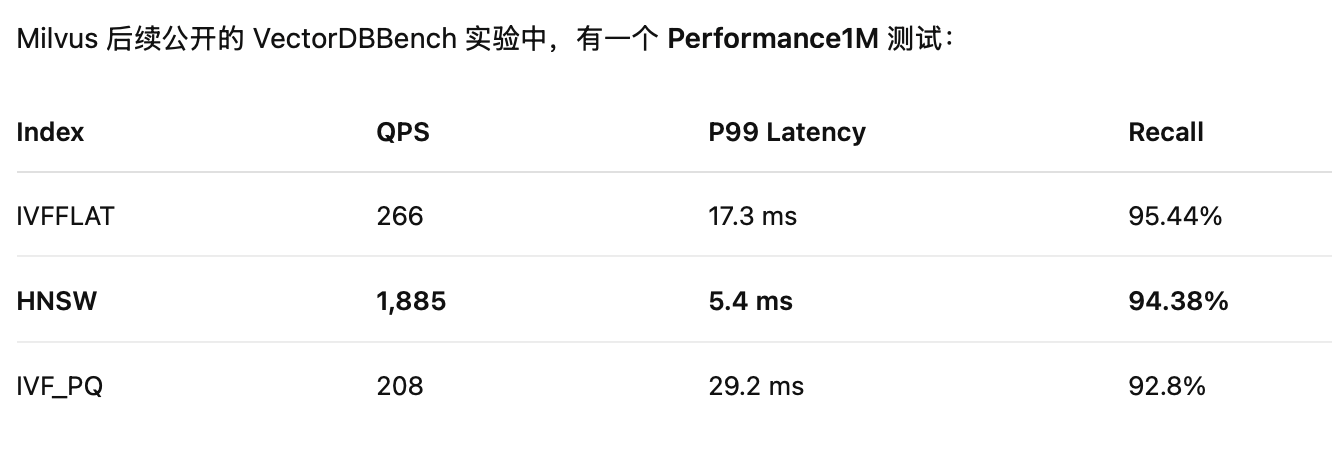
FLAT/Brute Force 会对所有向量进行精确距离计算,可以作为 Recall 的 Ground Truth;生产环境通常使用 HNSW、IVF 等 ANN 索引,通过减少实际参与距离计算的候选数量降低 P95/P99 延迟、提升 QPS,但会引入一定 Recall 损失。因此实际调优不是简单追求最快,而是在 Recall@K、P95/P99、QPS 和内存之间做 Trade-off。
算相似度的几种方式:余弦和点积最常见
- 余弦相似度 最常见 两个向量的方向是否相似。语义方向的企业 RAG、知识库问答、文档检索里非常常见。
$$\cos(q,d)=\frac{q\cdot d}{|q|,|d|}$$
- 点积 如果 Query 和 Document Vector 都做了 L2 Normalize,即
$$||q||=||d||=1$$
那么:
$$q\cdot d = cos(q,d)$$
Cosine ≈ Normalized Inner Product
这时候用 Inner Product 可以直接做点积,计算更方便。
- 欧氏距离 适合模型本身的向量空间把欧氏距离作为主要度量方式的场景。如聚类,异常检测,空间距离分析
$$d(q,d)=\sqrt{\sum(q_i-d_i)^2}$$
ANN
Approximate Nearest Neighbor 近似最近邻搜索 快速找到大概率最接近的 10 个,Recall:可能略低,速度:非常快。
HNSWHierarchical Navigable Small World。基于多层图结构进行近似最近邻搜索。
类似于跳表的思想,从高层快速定位,下降到下一层,继续缩小范围,底层精确搜索候选Topk。
三个参数:M,efConstruction,ef
M每个节点大概维护多少条图连接。
M ↑——图连接更多——搜索质量可能更高——内存增加——建索引成本增加
efConstruction建 Index 的时候搜索多少候选。影响建索引阶段。
efConstruction ↑——建索引时搜索范围更大——构建时间 ↑——内存/计算成本 ↑——Index 质量通常更好——Recall 通常更高
ef查询的时候搜索多少候选。影响查询的时候。
ef ↑——搜索更多候选——Recall ↑——Latency ↑
IVFInverted File Index
先把向量空间划分成很多 Cluster,找 Query 最接近哪些 Cluster,只搜索这些 Cluster,Top-K。通过减少搜索区域加速检索。
参数有nlist,nprobe。
nlist整个向量空间划分成多少个 Cluster。
nprobeQuery 查询的时候,要搜索多少个 Cluster。
PQProduct Quantization
解决:向量太多,存储和计算成本太高。
核心:牺牲一定精度,换取更低的存储和计算成本。
简单理解PQ: 原始 Vector [0.12, 0.83, 0.42, ...] ↓ 切成多个子空间 [0.12, 0.83] [0.42, ...] ... ↓ 每个子空间用较短的 Code 表示 [12] [87] [31] ... 最终: Vector ↓ 压缩 ↓ 更小的表示
经常和IVF 组合:IVF_PQ
四种索引选择/比较