企业级 RAG:在线检索流水线
本文聚焦 RAG 的在线检索链路:Query Understanding、Retrieval、Fusion、Reranker、MMR / Dedup 与上下文组装。
一、在线检索(Online Pipeline)
核心:粗召回+精排
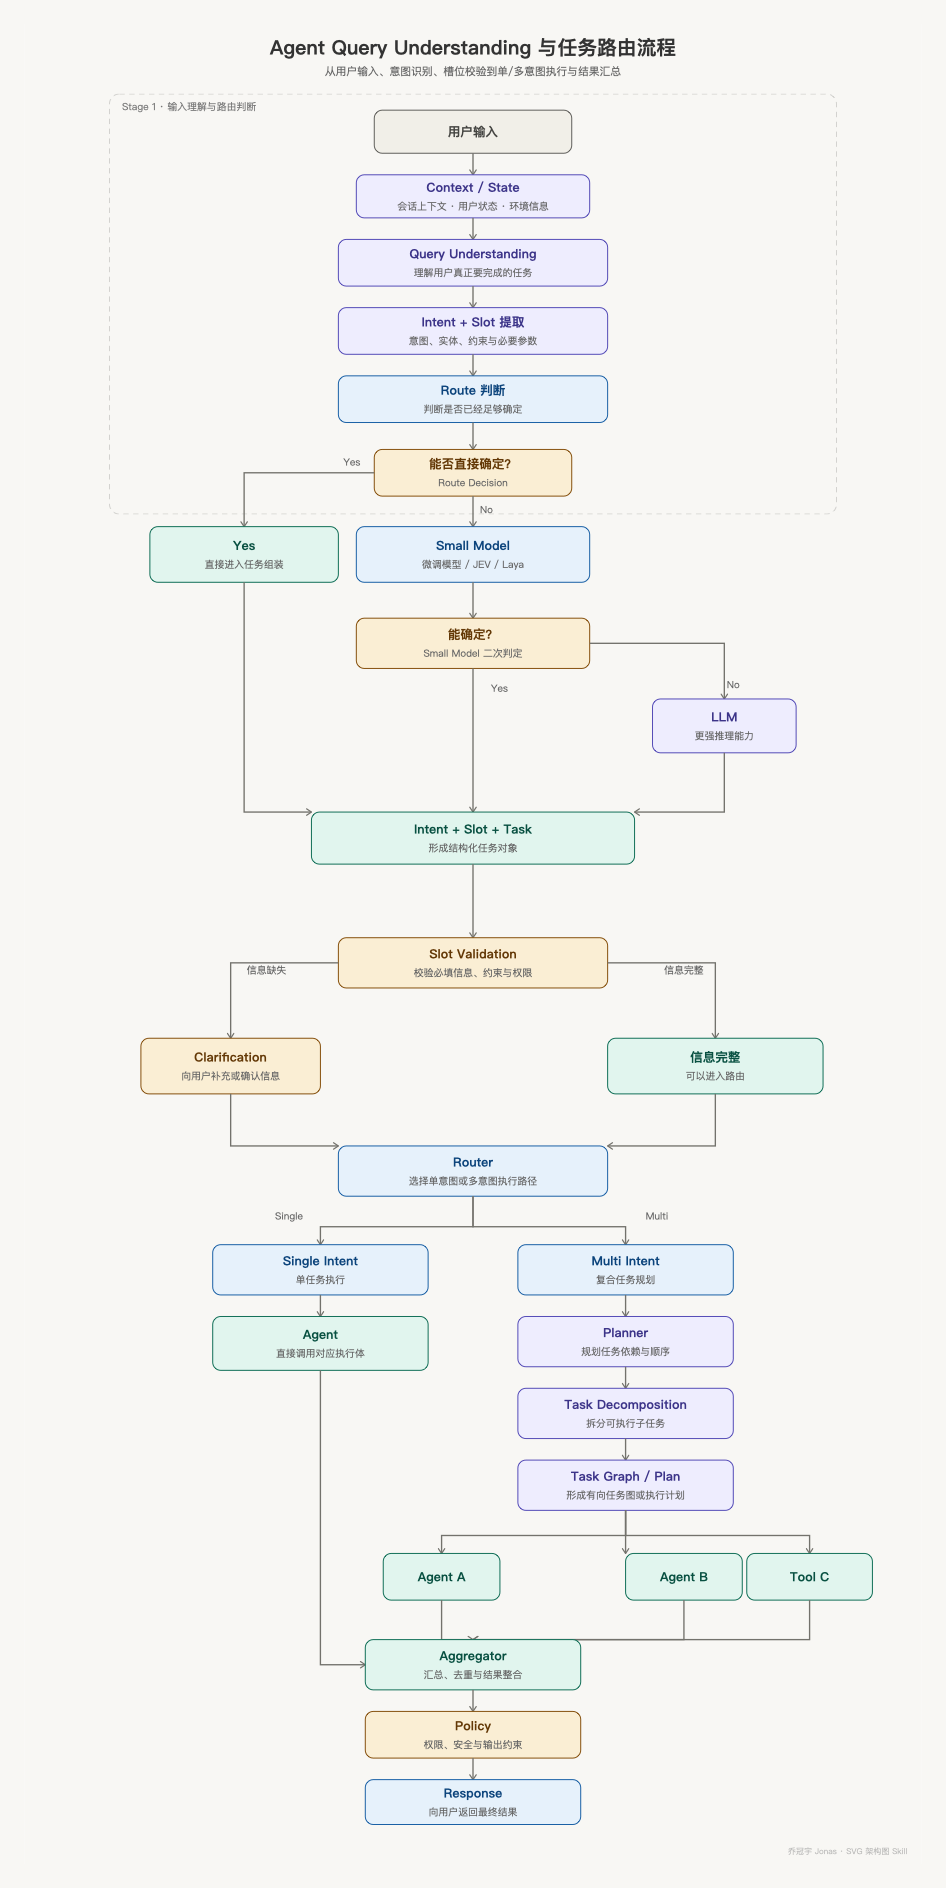
Query Understanding
问题理解:如意图识别
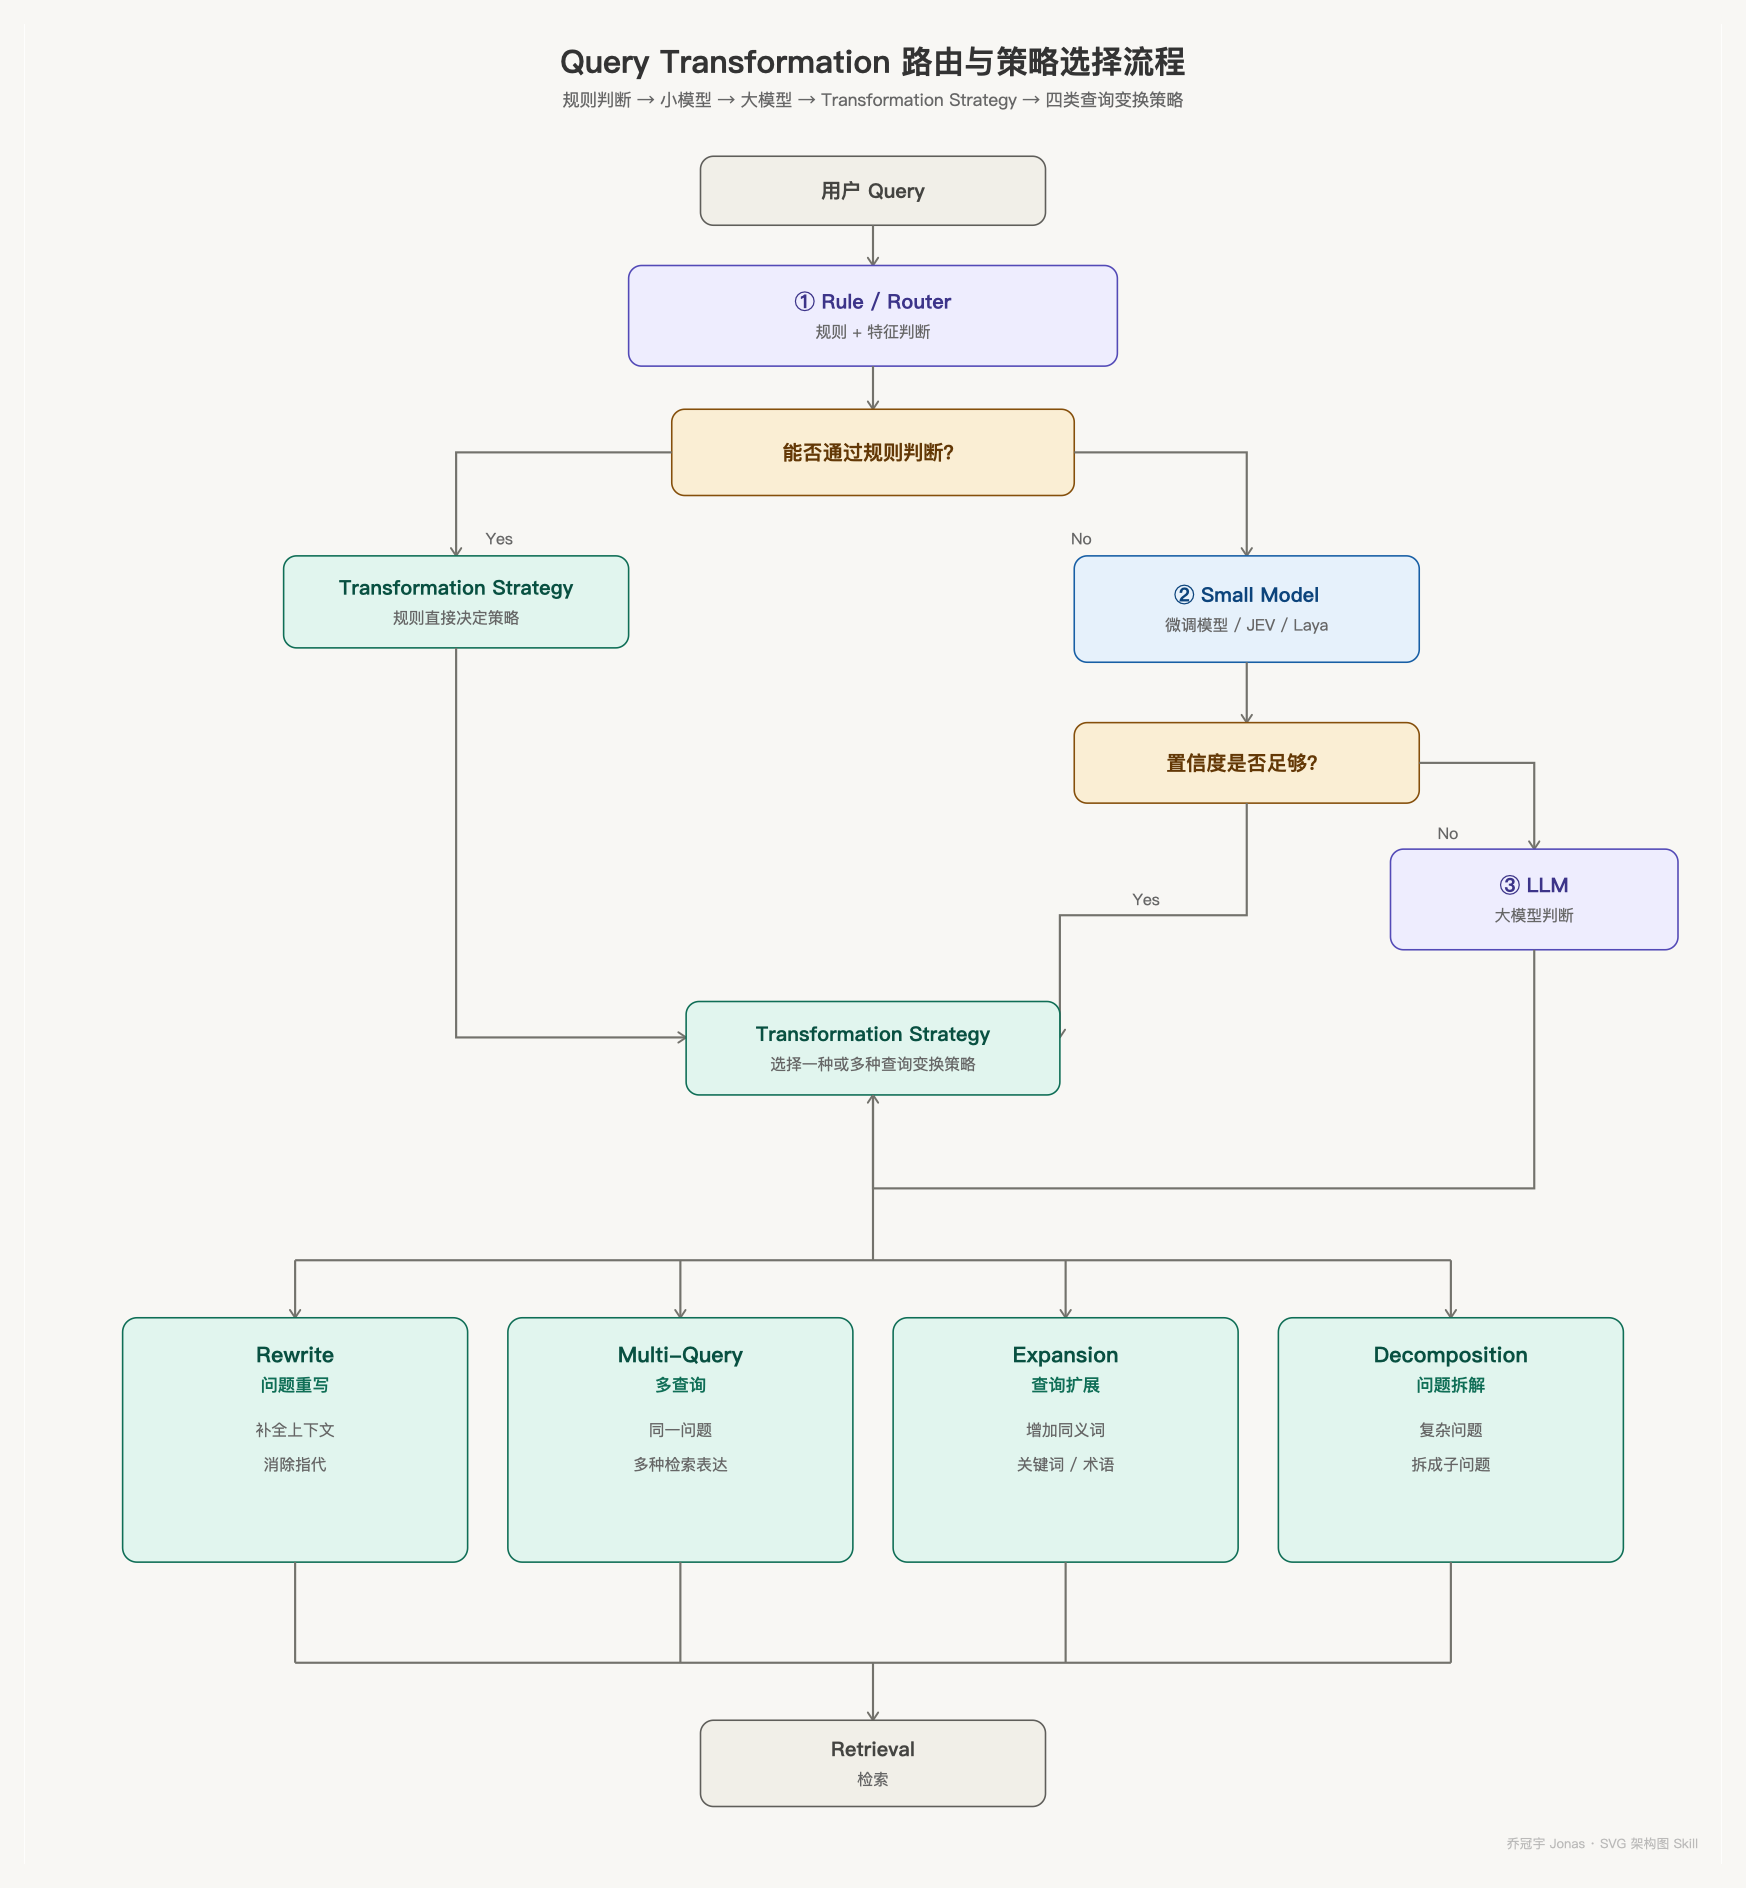
Query Transformation
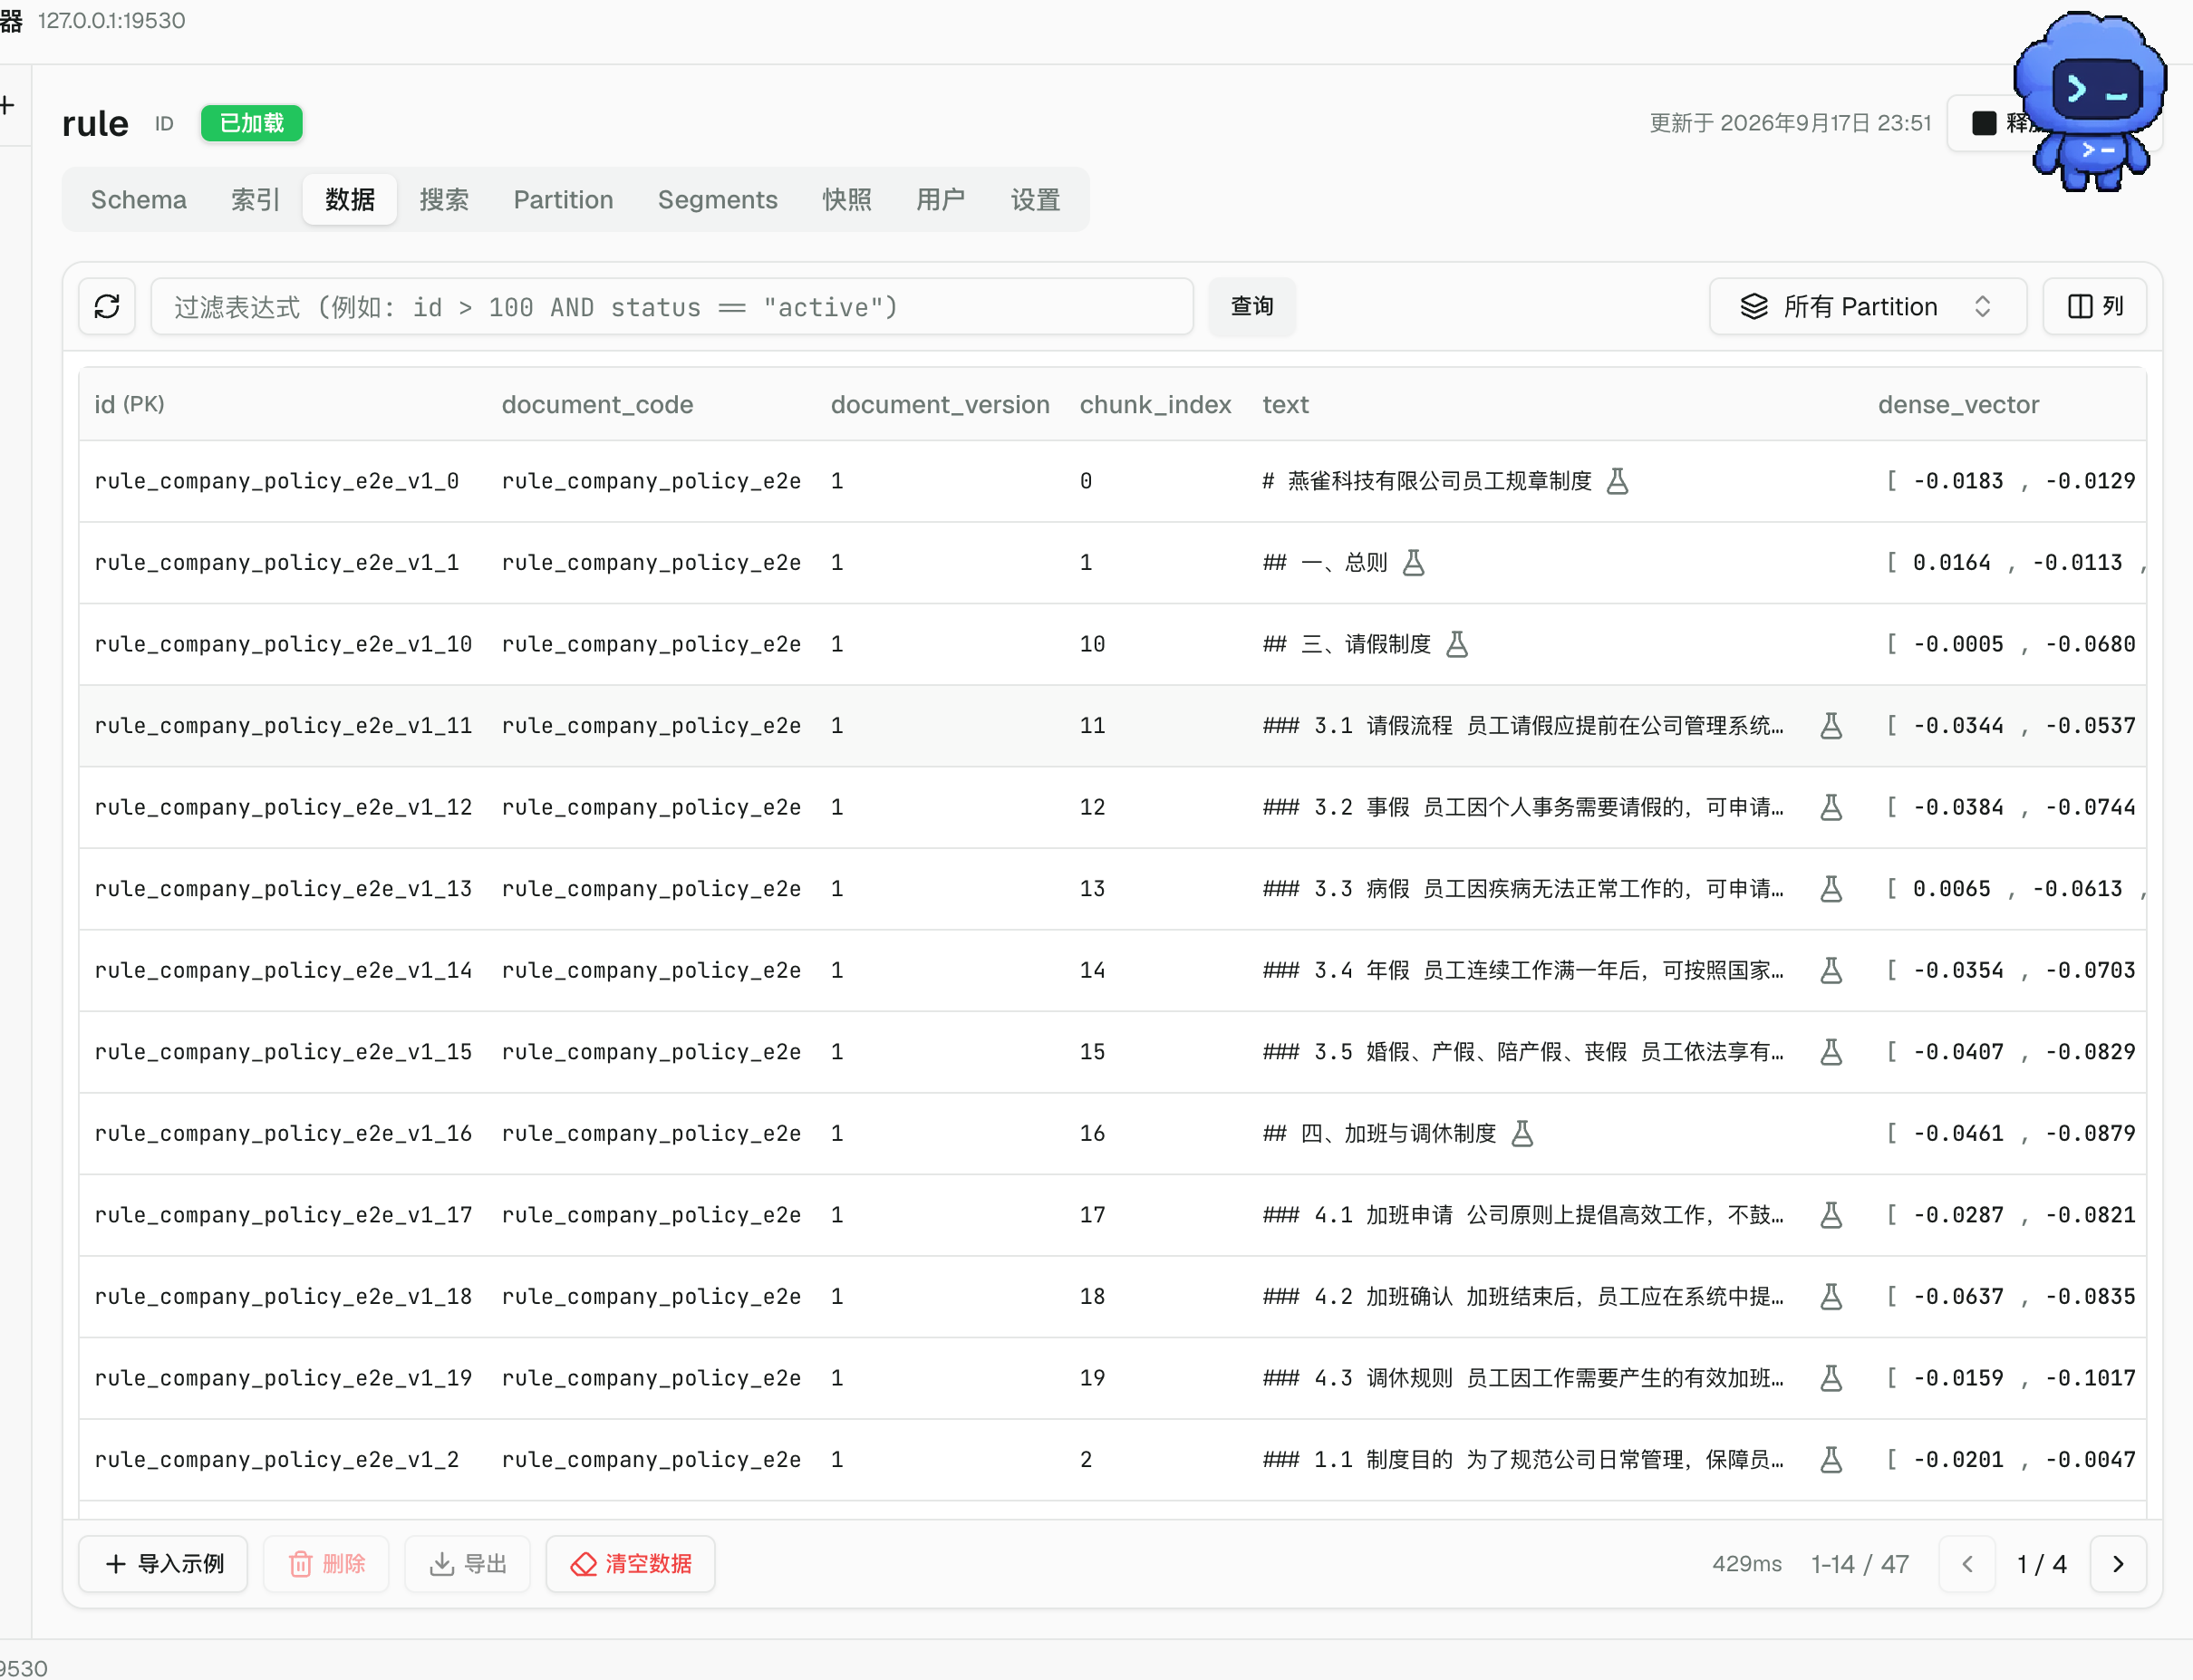
Metadata Filtering
用作检索时的过滤和权限控制。
文档级
来源文档本身:document_id、name、文件类型和版本
结构级
来源Parser后:page、section、heading、chunk_index
业务级
来源业务系统:tenant、user_id,部门和权限范围
注意:metadata本身不会被向量化,而是chunk content
Retrieval
retrieval就是从知识库中,根据用户Query找出Top-K候选chunk。前面都是在准备检索条件,到retrivel才真正开始**“从几万、几百万个 Chunk 里,找出和 Query 最相关的一批。”**
Dense Retrieval
把query和chunk都向量化,通过向量相似度进行语义检索。
Sparse Retrieval - BM25
BM25是最经典的方法,并不是把文本变成稀疏向量,而是基于query中的关键词,在document中出现的怎么样。本质是建立倒排索引,维护关键词到文档的倒排关系。
主要考虑:
TF(t,D) → 词 t 在 Document D 中出现多少次。
IDF(t) → 词t在整个语料库里有多稀有。
DL → 文档长度归一化
公式:
$$Score(D,Q)= \sum_{t\in Q} IDF(t) \times \frac{TF(t,D)(k_1+1)} {TF(t,D)+k_1(1-b+b\frac{|D|}{avgdl})}$$
特别适合:精确关键词、专业术语、产品名、错误码、代码符号、ID 等。
Hybrid Search
两种检索各有优势,所以经常结合起来。
Fusion
为什么需要fusion?
Dense Retrieval 和 BM25 各自检索出一批结果后,怎么平衡两份结果并合成一份更可靠的 Top-K?
Weighted
直接对两路归一化后的分数加权:
$$Score(d)= \alpha S_{dense}(d) + (1-\alpha)S_{bm25}(d)$$
问题:
Dense 和 BM25 的原始分数尺度可能完全不同,如Sdence=100,Sbm25=0.1,这时候a就是去了权重的意义,所以通常要先做 Score Normalization,例如 Min-Max、Z-Score 等。
RRF
更常用。
不关心两边的原始 Score 是多少,只看排名。
$$RRF(d)= \sum_i\frac{1}{k+rank_i(d)}$$
Weighted RRF
WRRF:多路 Rank 融合 + 控制每一路的贡献度。
$$\boxed{ WRRF(d)= \sum_{i=1}^{n} \frac{w_i}{k+rank_i(d)} }$$
其中:
- d:文档
- i:第 i 个检索通道
- w_i:第 i 个检索通道的权重
- rank_i(d):文档 d 在第 i 路中的排名
- k:平滑常数,常见取 60
- 如果文档没有出现在该路 Top-K 中:该路贡献 0
- 具体参数还是要根据评测结果来
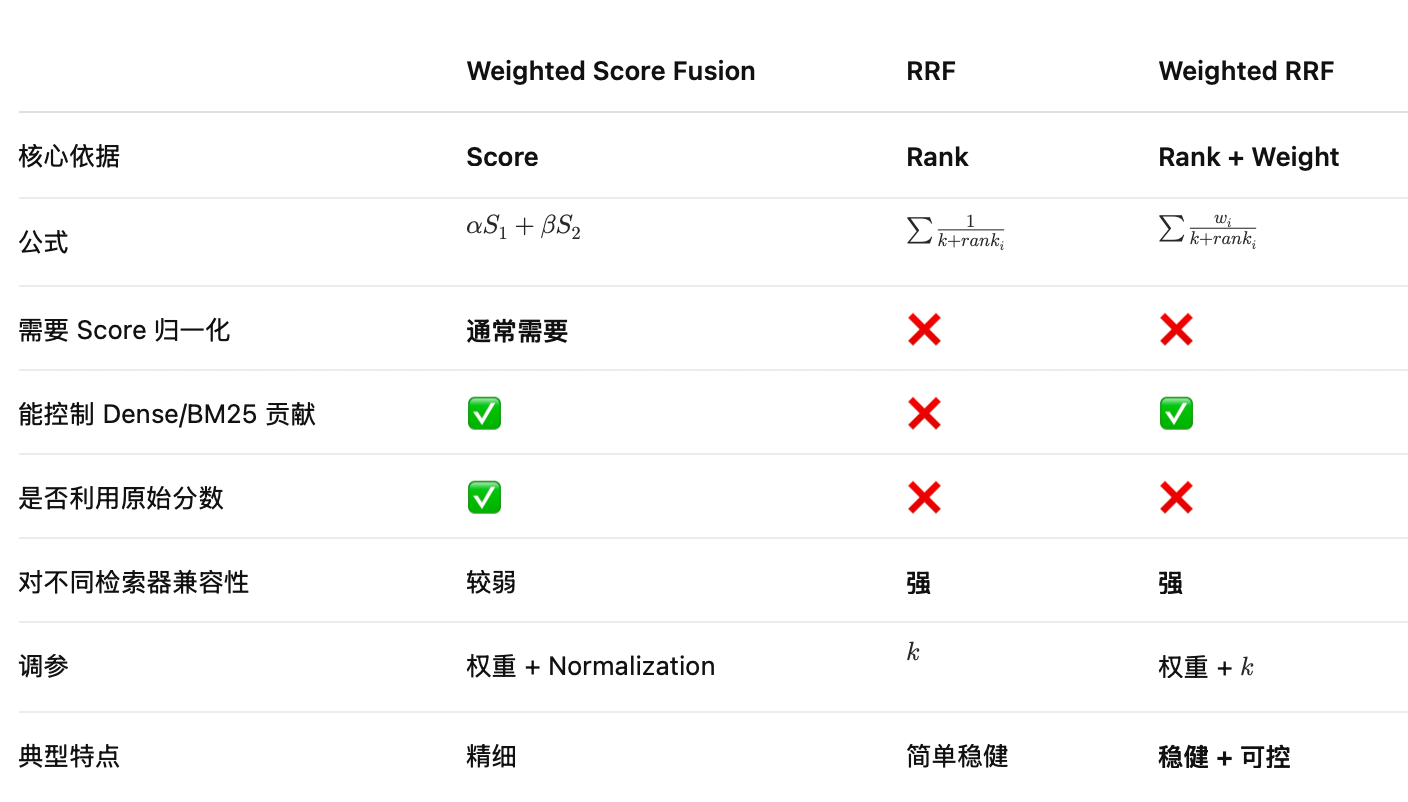
区别:
Reranker
Reranker(重排序器)是 RAG 检索阶段的精排模块。(粗召回+精排)
Cross-Encoder
专门用于reranker的模型。
第一阶段负责从海量知识库中快速召回候选,第二阶段负责对候选结果进行更精细的相关性判断和排序。
Bi-Encoder与Cross-Encoder:
Bi-Encoder与Cross-Encoder:Query 和 Document 如何经过模型进行编码、交互和打分的两种架构方式。
第一阶段用的embadding模型属于Bi-Encoder,即双编码器。即Query 和 Document 分别进入 Encoder,分别得到向量,再计算相似度。采用Bi-Encoder的原因是Document 可以离线提前计算 Embedding。
第二阶段用的是Cross-Encoder,交叉编码器。和Bi-Encoder的区别:Query 和 Document 不再分别编码,而是作为一个整体输入模型。
**Cross-Encoder比Bi-Encoder更适合精排,**关键是 Query-Document 的交互方式不同。后者是最终比较两者经过模型处理后的向量,前者Query 和 Document 的 Token 可以在 Transformer 的 Attention 中直接交互,所以能做更细粒度的判断。
但是也意味着Cross-Encoder比Bi-Encoder的成本要高很多。
所以生产中会用便宜、快速的模型缩小范围,再用昂贵、精确的模型做精排。
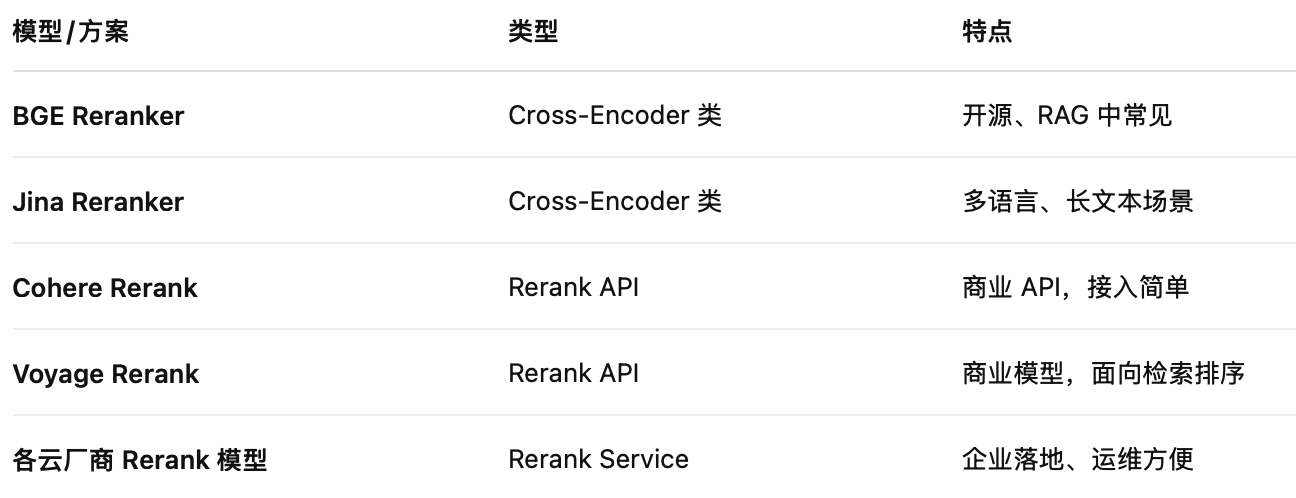
常用reranker模型:
LLM-Based
直接用通用 LLM。如Qwen / GPT / Claude。
MMR / Dedup
为什么 Rerank 后还需要 MMR / Dedup?
假设 Reranker 排完, Query ↓ Reranker ↓ Top 10 D1:Java 线程池核心线程数配置 D2:Java 线程池核心线程数详细配置 D3:Java 线程池 corePoolSize 配置 D4:Java 线程池参数配置示例 D5:Java 线程池最大线程数配置 ... 前 4 个可能其实来自同一个文档,或者讲的是同一件事情。 如果全部塞给 LLM: 会导致: * 浪费 Context Window * 浪费 Token * 信息密度下降 * LLM 反复看到同样内容 * 可能挤掉其他真正有价值的文档
MMR
Maximal Marginal Relevance 最大边际相关性。
核心思想非常简单:相关性 + 多样性
不仅要看“这个文档和 Query 有多相关”,还要看“它和已经选中的文档是不是重复”。
$$MMR(d)= \lambda Sim(d,Q) - (1-\lambda) \max_{d'\in S}Sim(d,d')$$
λ 越大,越重视相关性,λ 越小,越重视多样性
Dedup
**把重复或者高度重复的文档/Chunk 去掉。**常见有三种层次。
ID 去重D1 → document_id=1001
D2 → document_id=1001
直接保留一个。
Hash 去重对文本计算 Hash:
Hash(D1) = abc123
Hash(D2) = abc123
说明内容完全一样,可以去掉。
相似度去重两个 Chunk 内容不完全一样,但是高度相似,可以计算Similarity(D1, D2) ,超过阈值,就认为高度重复,保留一个。
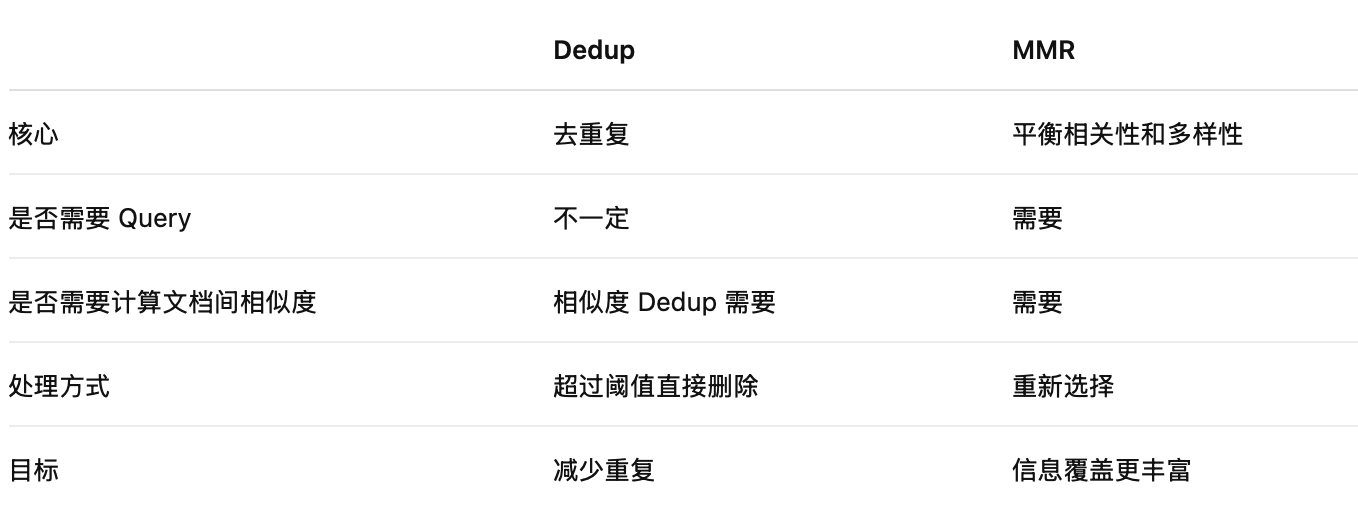
区别与联系
Dedup 更常见、更基础;MMR 属于更进一步的“多样性优化”。
怎么计算
Query-Document 相关性通常可以复用前面 Reranker 已经计算出的相关性分数;Document-Document 相似度则通常直接利用 Chunk 已有的 Embedding 向量计算 Cosine Similarity,而不是再次调用 Reranker,从而控制计算成本。
Context Processing
最终候选 Context 做必要的压缩、裁剪、去冗余,
再按相关性、来源、时间等策略组装成最终 Prompt Context。