RAG、Wiki、Ontology,到底是什么?
核心问题:RAG、Wiki、Ontology、Knowledge Graph、GraphRAG、Agentic Search 到底是什么关系?
阅读路径:
- 架构定位:先回答“它们分别在哪”;
- 具体拆解:再回答“每个东西到底怎么工作”;
- 总结:最后把整张知识获取地图收起来。
一、架构定位:先把这些东西放回同一张地图
1.1 为什么这些概念特别容易混?
现在讲企业 AI、Agent、知识库,经常会同时出现:
- RAG
- GraphRAG
- Wiki
- Ontology
- Knowledge Graph
- Agentic Search
- Elasticsearch
- Vector DB
- Tool
很多文章会分别介绍这些概念,但真正容易让人困惑的问题其实不是:
“RAG 是什么?”
而是:
“这些东西到底处于知识获取链路的哪一层?”
因为它们本身就不是同一层的概念。
例如:
- RAG 是一种知识增强范式
- Agentic Search 是一种主动搜索范式
- Wiki 是一种知识组织与承载方式
- Ontology 是一种领域知识模型
- Knowledge Graph 是一种结构化知识表示
- Elasticsearch 是一种搜索基础设施
- Tool 是 Agent 获取知识或能力的调用接口
所以第一步不是背定义,而是先建立一张架构地图。
1.2 企业知识获取整体架构
可以先把企业知识获取抽象成两条主要路线:
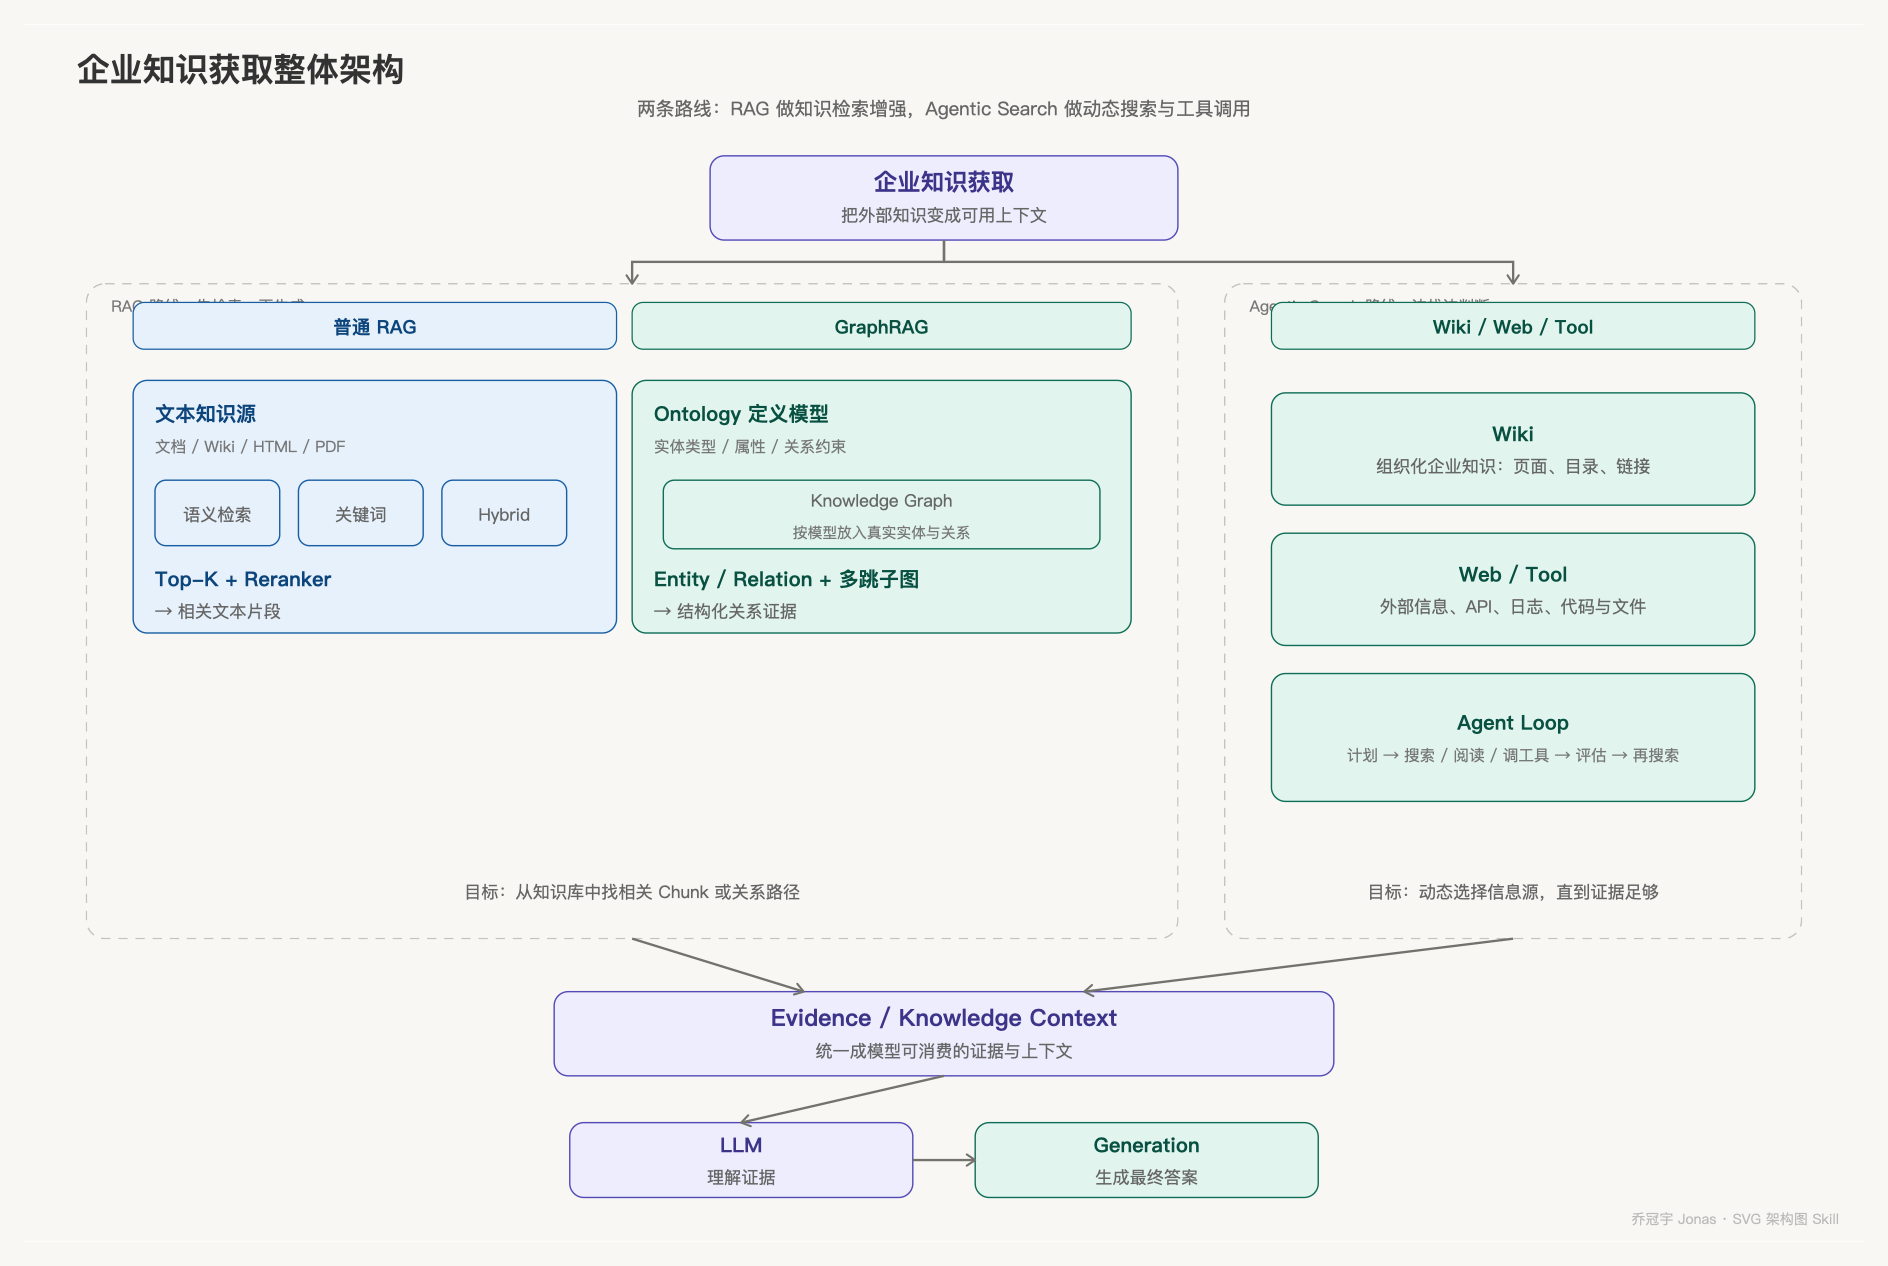
这张图最重要的不是让大家记住每一个框,而是建立层级关系。
1.3 这些概念分别是什么角色?
| 概念 | 定位 |
|---|---|
| RAG | 一种知识增强范式 / Pipeline |
| 普通 RAG | 基于文本 Chunk 的检索增强 |
| GraphRAG | 利用图结构进行知识检索的 RAG |
| Agentic Search | Agent 主动规划、选择和执行搜索的范式 |
| Wiki | 组织和承载企业知识的知识库 / 知识源 |
| Ontology | 描述领域中有哪些实体、类型以及关系的知识模型 |
| Knowledge Graph | 按实体和关系组织起来的结构化知识 |
| Elasticsearch | 搜索 / 检索基础设施 |
| Vector DB | 向量存储与向量检索基础设施 |
| Tool | Agent 获取外部知识或能力的调用接口 |
| LLM | 最终理解上下文并生成答案 |
因此:
这些东西不能简单地放在同一个维度上比较。
例如:
RAG ≠ Wiki
Wiki ≠ Ontology
Ontology ≠ Knowledge Graph
Elasticsearch ≠ RAG
Agentic Search ≠ RAG 的一个子类型
它们解决的是不同层面的问题。
1.4 RAG 到底处于什么位置?
RAG 全称:
Retrieval-Augmented Generation
即:
检索增强生成。
它解决的核心问题是:
LLM 本身不知道或者不应该直接依赖的外部知识,能不能在生成答案之前先检索出来,再提供给模型?
最基本的过程:
User Query
    ↓
Retrieval
    ↓
Relevant Knowledge
    ↓
Context
    ↓
LLM
    ↓
Answer
所以 RAG 更像是一套:
“先找知识,再让模型基于知识回答”的知识增强范式。
1.5 Agentic Search 又是什么?
Agentic Search 的核心思路有所不同。
传统 RAG 往往是:
Query
 ↓
固定 Retrieval Pipeline
 ↓
Top-K
 ↓
LLM
而 Agentic Search 更强调:
User Query
    ↓
Agent
    ↓
分析问题
    ↓
决定去哪里找
    ↓
执行 Search / Read / Tool
    ↓
观察结果
    ↓
继续搜索 / 换搜索方式
    ↓
Evidence
    ↓
LLM
也就是说:
不是预先规定一条固定的检索链路,而是让 Agent 根据问题动态决定“去哪里找、怎么找、是否继续找”。
1.6 Wiki、Ontology、Knowledge Graph 又处于哪里?
这里尤其容易混淆。
Wiki
Wiki 更接近:
知识的组织和承载方式。
例如企业 Wiki:
支付服务
│
├── 服务介绍
├── 技术架构
├── API 文档
├── 负责人
├── 常见故障
└── 相关事故
它强调的是:
知识如何被组织、编辑和关联。
Ontology
Ontology 更接近:
领域知识模型。
例如研发领域:
Service
Employee
Department
API
Incident
Document
以及:
Employee ── belongs_to ──> Department

Employee ── owns ──> Service

Service ── calls ──> API

Service ── affected_by ──> Incident
Ontology 规定:
这个领域里有哪些类型,以及这些类型之间允许存在什么关系。
Knowledge Graph
Knowledge Graph 则是在这样的模型下,把实际知识组织起来。
例如:
张三
 │
 └── owns ──> 支付服务
                  │
                  └── calls ──> 支付宝 API
                                    │
                                    └── affected_by
                                              ↓
                                       9月29日超时事故
所以可以记住一句话:
Ontology 定义“怎么描述这个世界”,Knowledge Graph 描述“这个世界里具体有什么”。
二、具体拆解:这些东西到底怎么工作?
2.1 第一条路线:普通 RAG
最简单的 RAG:
用户问题
   ↓
Query
   ↓
Retrieval
   ↓
Top-K Documents / Chunks
   ↓
Context
   ↓
LLM
   ↓
Answer
它的核心思想其实非常简单:
把模型不知道的知识,在生成之前检索出来,然后放进 Context。
2.2 第二条路线:GraphRAG
普通 RAG 有一个非常典型的特点:
它主要围绕“文本相关性”寻找信息。
例如用户问:
为什么昨天晚上支付服务大量超时?
普通 RAG 可能找到:
支付服务超时事故文档
支付宝接口说明
支付服务架构文档
历史故障复盘
这些文档都和问题相关。
但如果问题真正关心的是:
这些实体之间到底是什么关系?
那么仅仅找几个相关 Chunk 可能不够。
例如:
支付服务
   │
   ├── calls ──> 支付宝 API
   │
   ├── belongs_to ──> 支付中心
   │
   ├── owned_by ──> 张三
   │
   └── affected_by ──> 2026-09-29 超时事故
                                  │
                                  ├── caused_by ──> 下游 API 延迟
                                  │
                                  └── affected ──> 订单支付
这里真正重要的不是某一个 Chunk。
而是:
实体 + 关系 + 关系链路。
这就是图结构能够提供的信息。
2.2.1 Ontology:先定义“这个世界长什么样”
假设我们要建立一个企业研发知识图谱。
首先需要定义:
Service
Employee
Department
API
Incident
Document
然后定义它们之间可以有什么关系:
Employee ── belongs_to ──> Department

Employee ── owns ──> Service

Service ── calls ──> API

Service ── affected_by ──> Incident

Incident ── documented_by ──> Document
这就是 Ontology 所做的事情。
可以理解成:
Ontology 是对一个领域进行抽象建模。
它规定:
- 有哪些实体类型?
- 每种实体有哪些属性?
- 实体之间有哪些关系?
- 哪些关系是合法的?
2.2.2 Knowledge Graph:再把真实知识放进去
有了 Ontology 以后,我们才能把真实企业数据组织起来。
例如:
Employee
张三

Department
支付中心

Service
支付服务

API
支付宝 API

Incident
9月29日支付超时事故
然后建立真实关系:
张三
 │
 └── owns ──> 支付服务
                  │
                  └── calls ──> 支付宝 API
                                    │
                                    └── affected_by
                                              ↓
                                      9月29日超时事故
因此:
Ontology
    ↓
规定知识应该怎么描述

Knowledge Graph
    ↓
按照这个模型组织真实知识
一句话:
Ontology 是“知识模型”,Knowledge Graph 是“结构化知识”。
2.2.3 GraphRAG:利用图结构进行知识检索
理解了 Ontology 和 Knowledge Graph,再来看 GraphRAG 就很自然。
一个抽象流程:
User Query
    ↓
Query Understanding
    ↓
Entity / Relation Identification
    ↓
Graph Retrieval
    ↓
Subgraph / Entity / Relation Retrieval
    ↓
Evidence
    ↓
Context
    ↓
LLM
    ↓
Answer
例如:
用户:
为什么支付服务昨天晚上大量超时?

        ↓

识别实体:
支付服务
支付宝 API
超时事故

        ↓

图检索:

支付服务
   ↓ calls
支付宝 API
   ↓ affected_by
超时事故
   ↓ caused_by
下游 API 延迟

        ↓

形成结构化 Evidence

        ↓

LLM

        ↓

最终回答
因此可以这样理解:
普通 RAG 更强调从文本中找到相关内容;GraphRAG 则进一步利用实体、关系和图结构组织与检索知识。
但这里不要把两者说成绝对的能力边界。
普通 RAG 也可以处理关系信息,GraphRAG 也仍然可以使用文本证据。
真正的区别在于:
知识的组织方式以及检索时是否显式利用图结构。
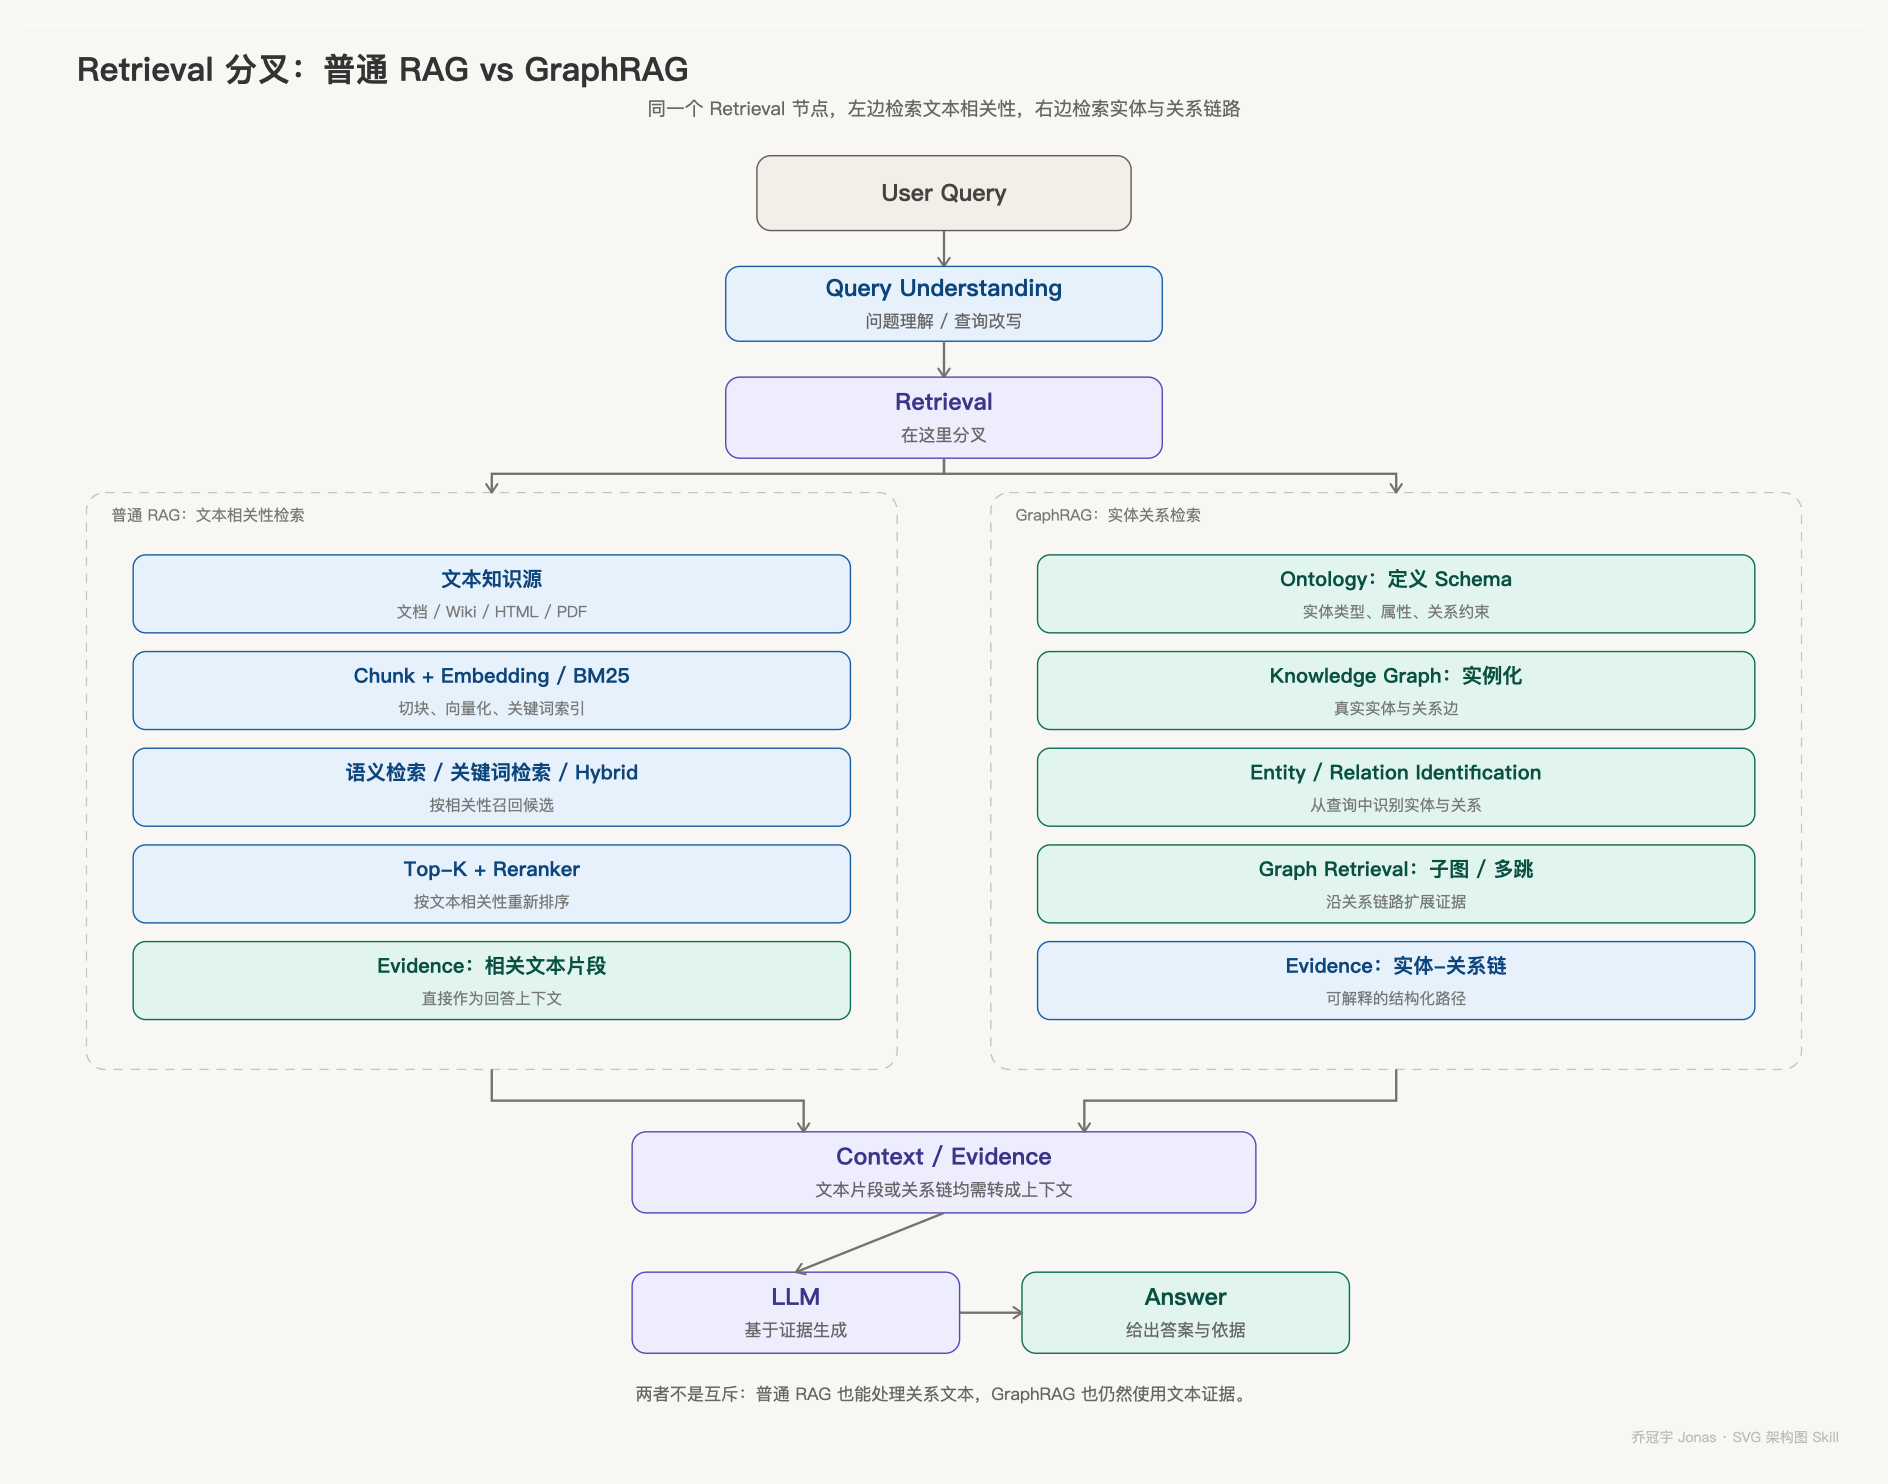
这张图把 2.1 和 2.2 放在同一个 Retrieval 节点下对比:左边检索文本相关性,右边显式检索实体与关系链路。
2.3 第三条路线:Agentic Search
前面讲的是:
RAG 路线。
另一种思路是:
让 Agent 自己决定怎么搜索。
传统 RAG:
Query
 ↓
固定 Retrieval Pipeline
 ↓
Top-K
 ↓
LLM
Agentic Search:
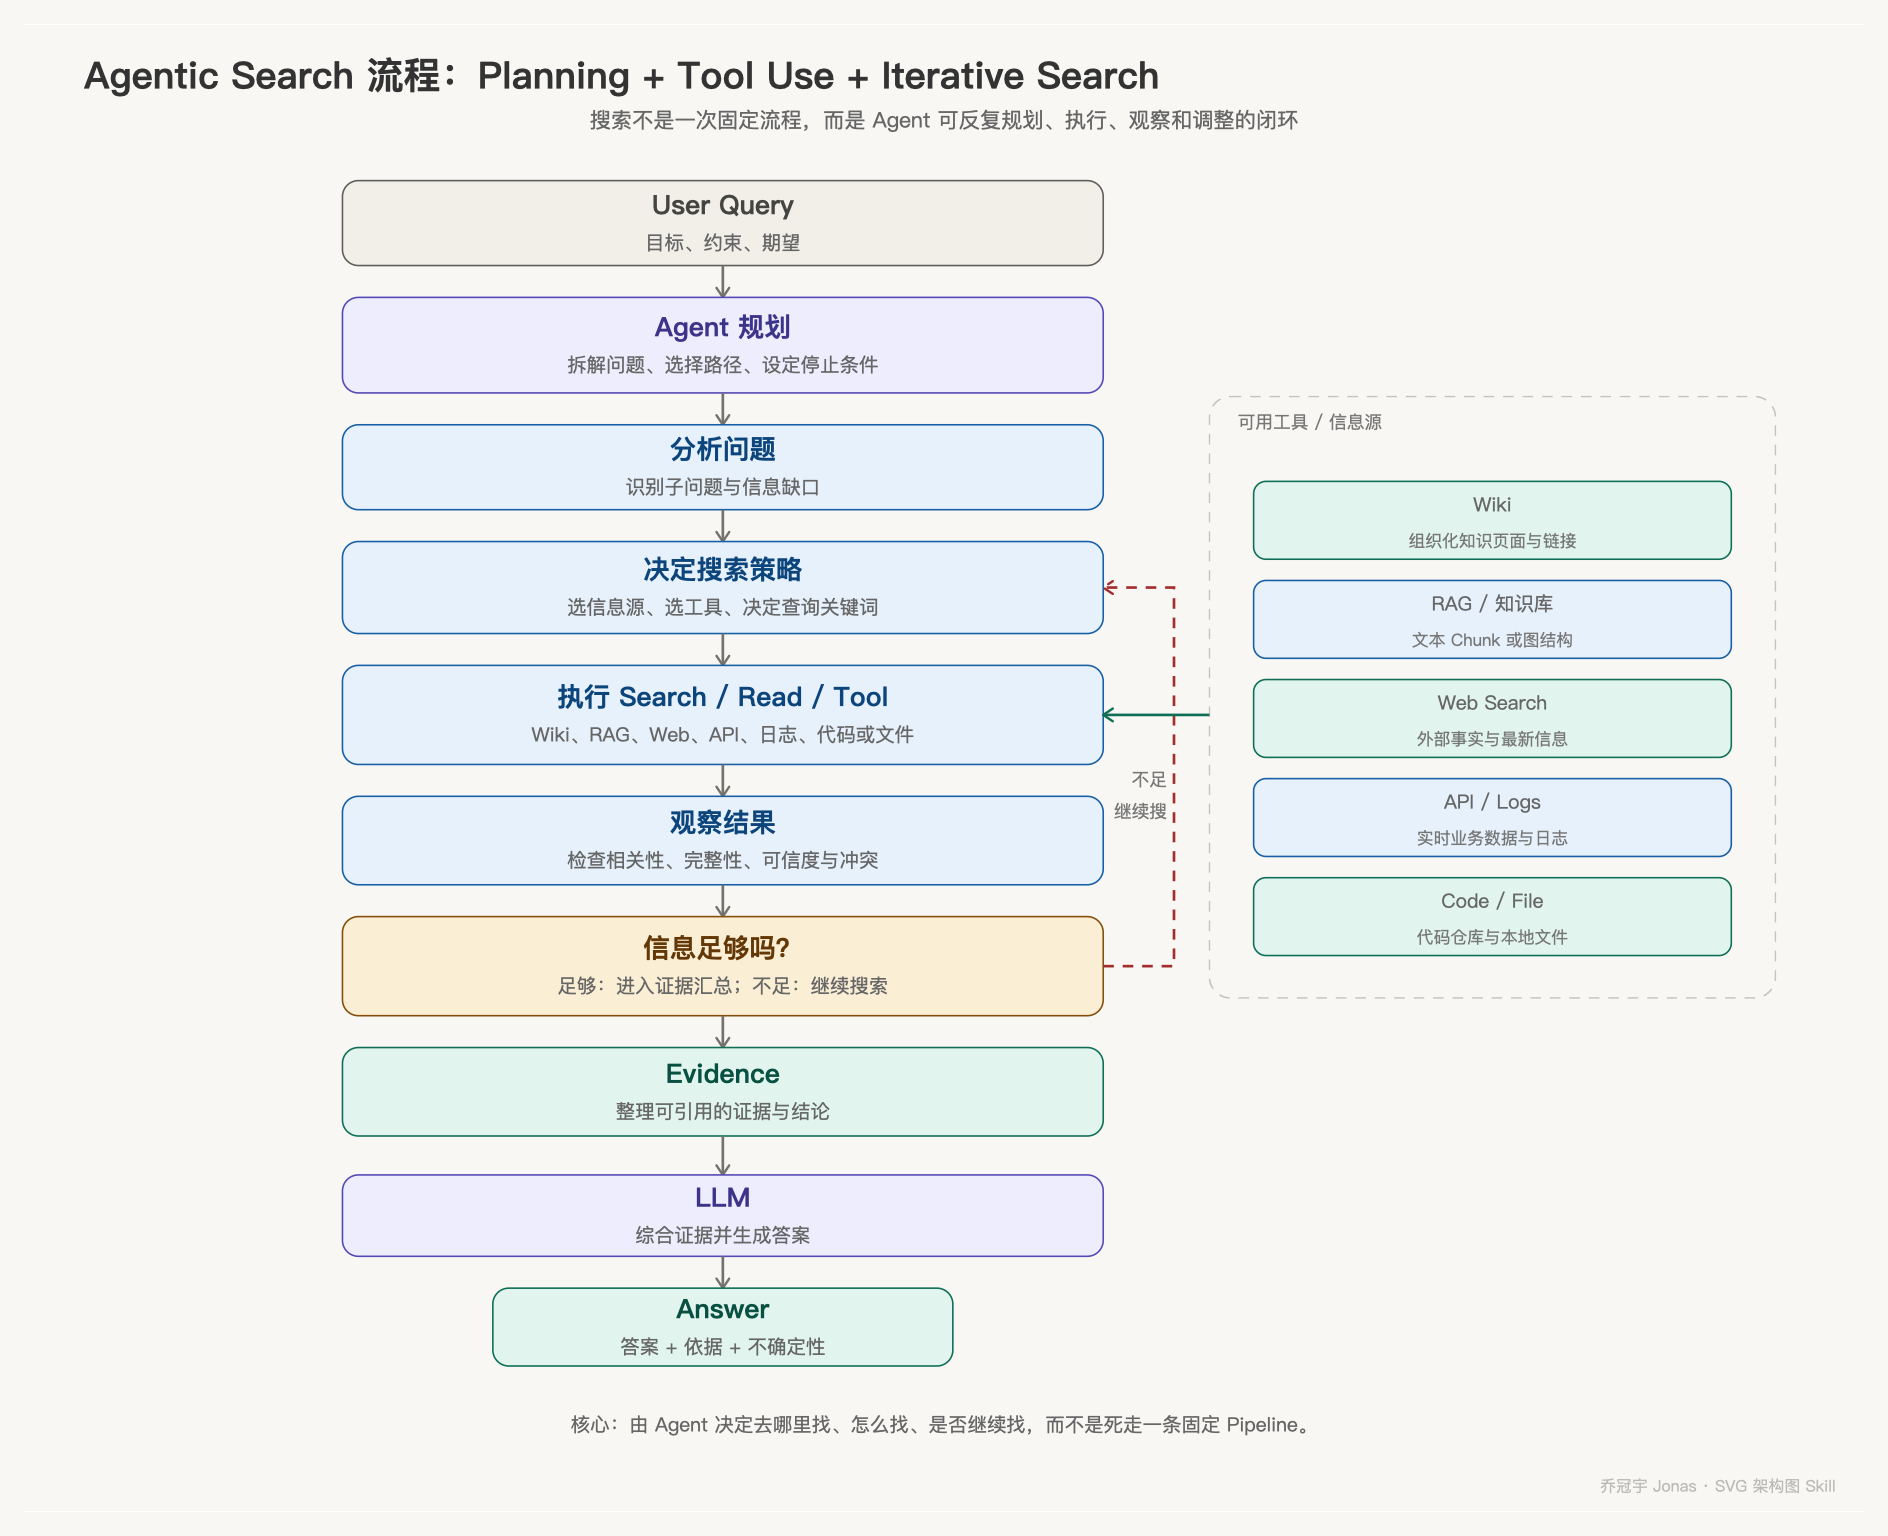
所以 Agentic Search 的核心关键词是:
Planning + Tool Use + Iterative Search
2.3.1 Wiki 在 Agentic Search 中是什么角色?
企业 Wiki 是非常典型的知识源。
例如:
支付服务
│
├── 服务介绍
├── 技术架构
├── API 文档
├── 负责人
├── 常见故障
└── 相关事故
传统 RAG 可以:
Wiki
 ↓
Chunk
 ↓
Embedding
 ↓
Vector Search
 ↓
Top-K
但 Agentic Search 还可以直接把 Wiki 暴露成 Tool:
Agent
  │
  ├── search_wiki()
  │
  ├── read_wiki()
  │
  └── follow_link()
例如:
Agent
 ↓
search_wiki("支付服务")
 ↓
找到支付服务页面
 ↓
read_wiki()
 ↓
发现“常见故障”
 ↓
follow_link()
 ↓
进入“支付超时事故”
 ↓
继续读取
这里 Agent 并不是简单执行一次向量检索。
而是在:
搜索 → 阅读 → 发现新线索 → 再搜索
不断推进。
2.4 RAG 与 Agentic Search 能一起用吗?
完全可以。
实际上,在真实企业 Agent 中,两者往往不是二选一。
例如:
                    User Query
                         │
                         ▼
                       Agent
                         │
          ┌──────────────┼──────────────┐
          │              │              │
          ▼              ▼              ▼
         RAG        Agentic Search     Tools
          │              │              │
     ┌────┴────┐     ┌───┴────┐         │
     ▼         ▼     ▼        ▼         ▼
 普通RAG   GraphRAG  Wiki     Web    Logs / API
     │         │     │        │         │
     └────┬────┴─────┴────────┴─────────┘
          │
          ▼
   Evidence / Context
          │
          ▼
         LLM
          │
          ▼
        Answer
这时候:
- RAG 负责从知识库中检索
- GraphRAG 负责利用图结构检索
- Wiki 提供组织化知识
- Web 提供外部信息
- Log Tool 提供实时日志
- API Tool 提供实时业务数据
- Agent 决定什么时候调用什么
最终全部汇聚成:
Evidence / Knowledge Context
然后交给 LLM。
2.5 一个企业研发排障案例
现在把前面的所有概念真正串起来。
用户问:
“为什么昨天晚上支付服务大量超时?现在问题解决了吗?”
Agent 首先判断:这是一个需要多来源信息的问题。
于是可能调用:
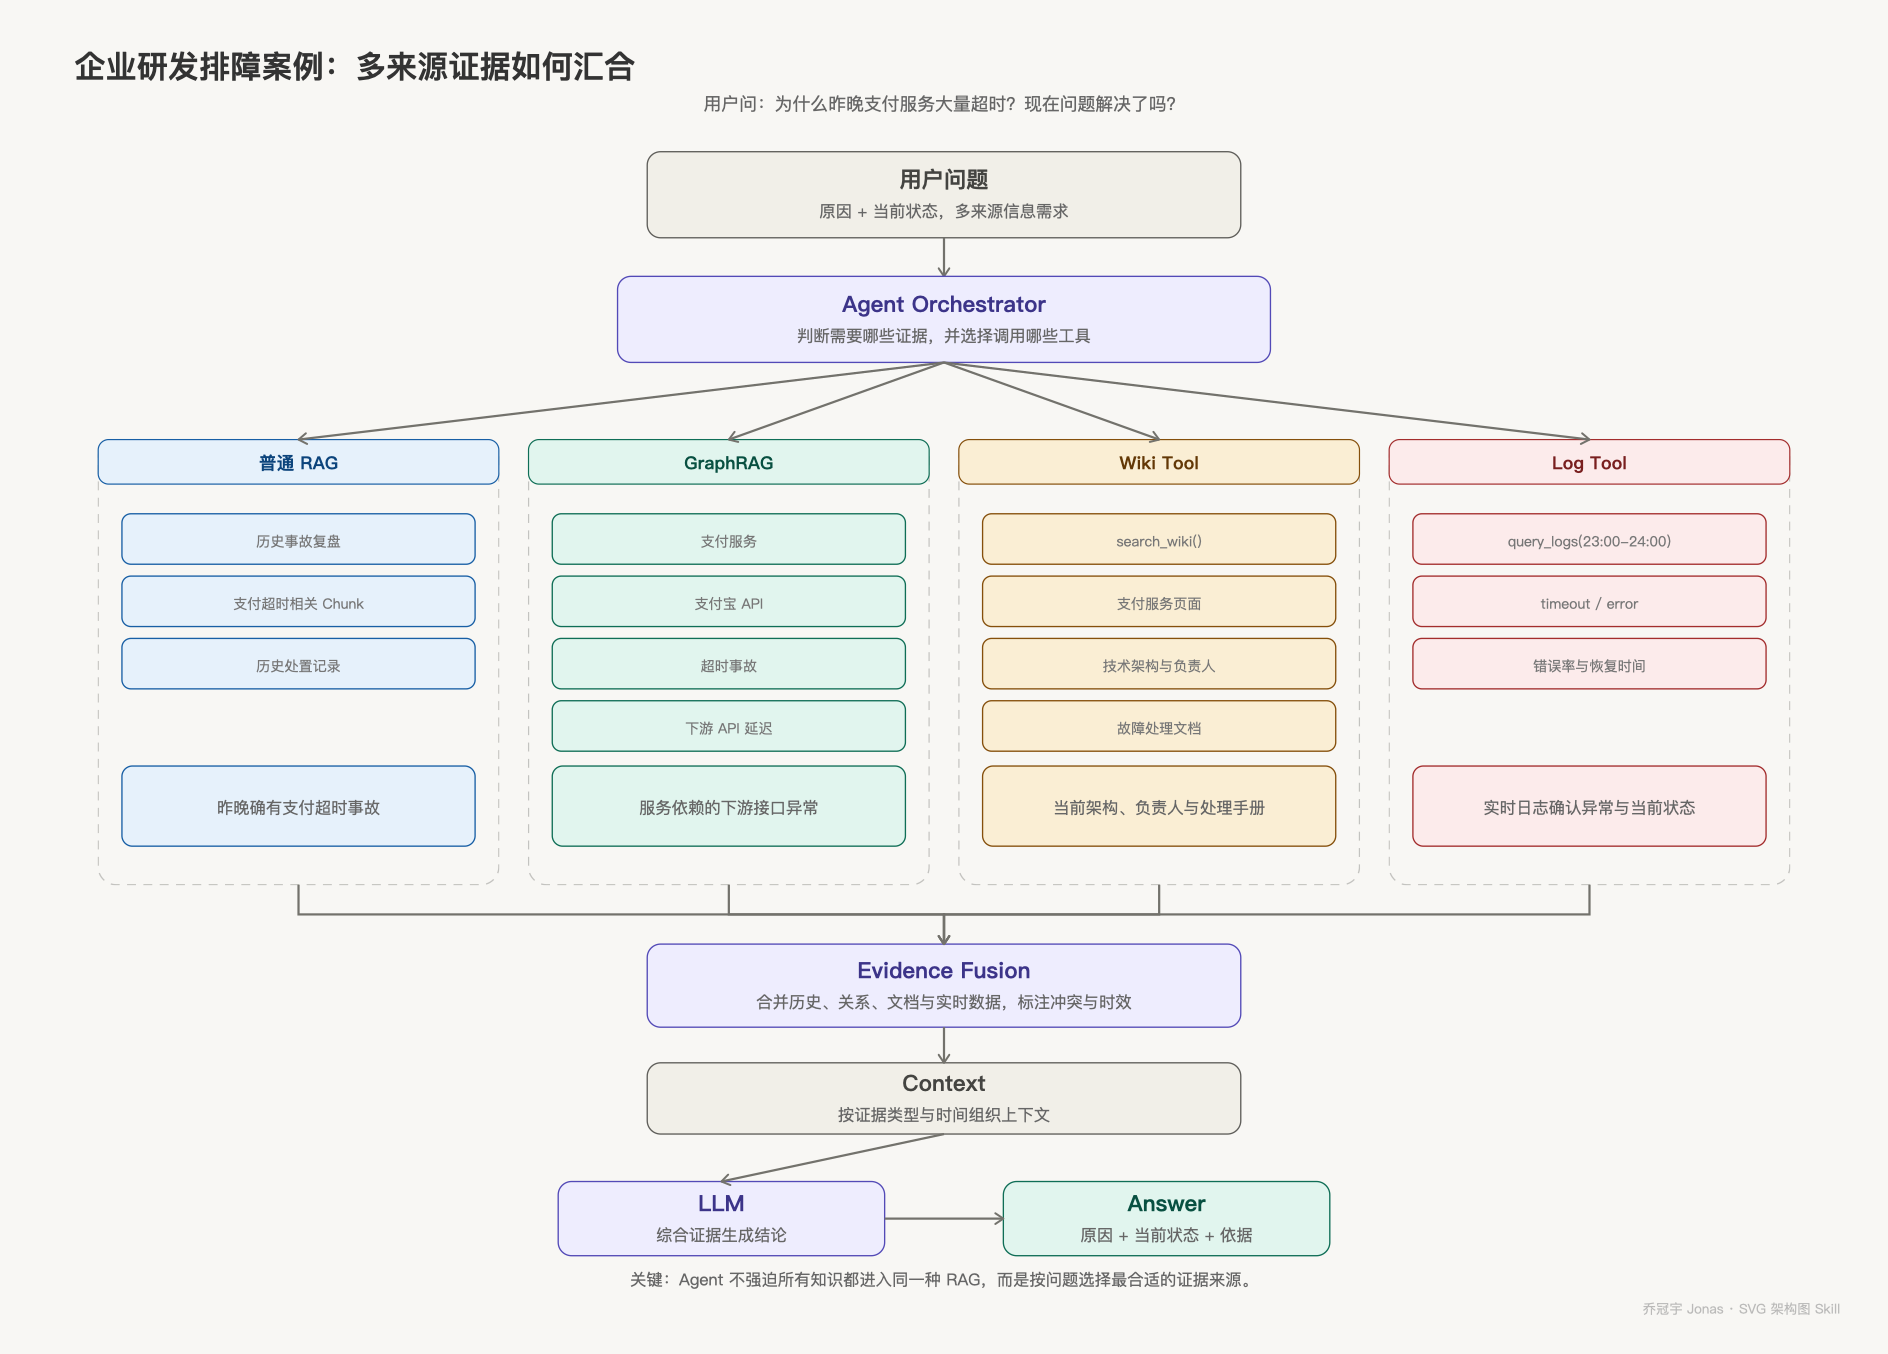
① 普通 RAG
查询历史事故文档:
RAG
 ↓
历史事故复盘
 ↓
支付超时相关 Chunk
得到:
昨晚曾经发生支付超时事故。
② GraphRAG
查询实体和关系:
支付服务
   ↓
支付宝 API
   ↓
超时事故
   ↓
下游 API 延迟
得到:
支付服务依赖的下游接口发生异常。
③ Wiki Tool
查询当前系统知识:
search_wiki()
      ↓
支付服务
      ↓
技术架构
      ↓
负责人
      ↓
故障处理文档
得到:
当前服务架构、负责人以及故障处理方式。
④ Log Tool
继续查询实时数据:
query_logs()
     ↓
昨天 23:00 ~ 24:00
     ↓
timeout / error
得到:
昨晚确实存在大量 timeout。
⑤ Evidence Fusion
最终:
历史文档
    +
图关系
    +
Wiki
    +
实时日志
    ↓
Evidence Fusion
    ↓
Context
    ↓
LLM
最终模型再基于这些证据回答:
昨晚支付服务超时主要与下游支付接口响应延迟有关;从当前日志来看,异常已经恢复……
这里最重要的是:
不同知识来源可以同时存在,Agent 不需要强迫所有知识都进入同一种 RAG。
三、总结
一张表记住所有概念
真正需要记住的不是单个定义:
- RAG 是什么?
- Wiki 是什么?
- Ontology 是什么?
| 概念 | 可以把它理解成 |
|---|---|
| RAG | 怎么把外部知识拿给 LLM |
| 普通 RAG | 从文本中找相关 Chunk |
| GraphRAG | 利用实体、关系和图结构检索知识 |
| Ontology | 定义这个领域“有哪些东西、有什么关系” |
| Knowledge Graph | 按实体和关系组织起来的结构化知识 |
| Agentic Search | 让 Agent 自己决定“去哪里找、怎么找、是否继续找” |
| Wiki | 企业知识的组织与承载方式 |
| Elasticsearch | 搜索 / 检索基础设施 |
| Vector DB | 向量存储与检索基础设施 |
| Tool | Agent 获取知识或能力的调用入口 |
| LLM | 最终理解 Evidence 并生成答案 |
而是一张分层地图:
RAG 是知识增强范式;GraphRAG 是利用图结构进行知识检索的一类 RAG 思路;Ontology 和 Knowledge Graph 提供图知识的模型与结构;Wiki 是组织和承载企业知识的一种方式;Agentic Search 让 Agent 主动决定去哪里、怎么寻找知识。