一、概念
思路:概念 → 解决的问题
1. Redis 是什么
- Redis 是一个基于内存的 Key-Value 非关系型数据库。
- 支持丰富的数据结构,比如 String、Hash、List、Set、ZSet,读写性能极高。
- 可以用作缓存、分布式协调,甚至消息队列。
2. Redis 解决了什么问题
- 数据库访问压力过大,如高并发场景。(缓存)
- 单级锁的问题。(分布式)
- Token 管理、Session 共享等。(分布式)
Session 在分布式下实现用户数据共享;JWT 中服务端不需要存储用户信息,但可以用作权限的校验。
二、Redis 为什么快 —— 底层
思路:基于内存 → 单线程 + IO 多路复用 → 高效的数据结构和底层编码 → 非阻塞操作
1. 基于内存
- 数据存储在内存中,避免磁盘 I/O,访问速度快。
2. 单线程 + IO 多路复用
- 单线程:减少了多线程上下文切换带来的开销。
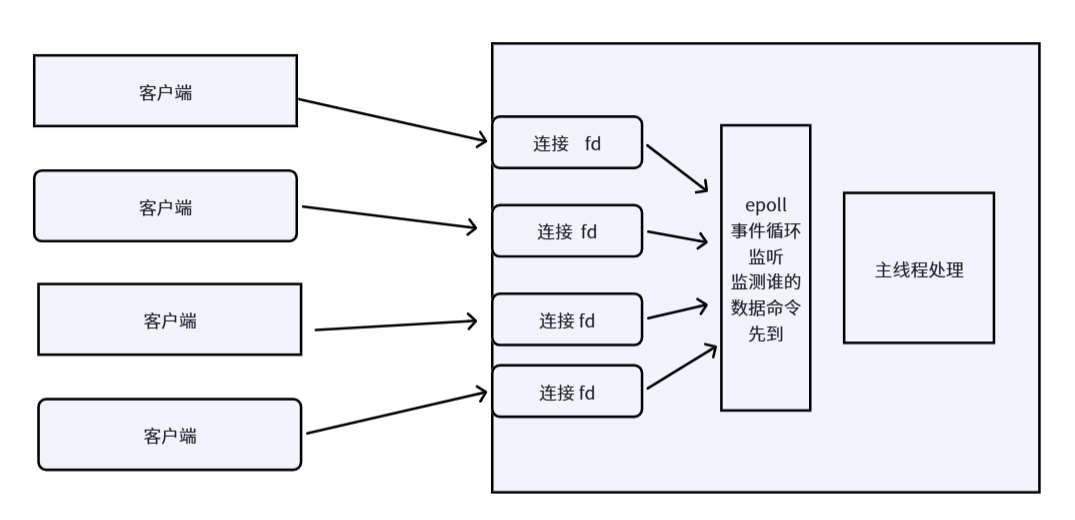
- IO 多路复用:
- "多路"是多个客户端连接,对应生成多个 fd 文件描述符;
- "复用"是复用同一个线程处理这些连接的网络 I/O 请求;
- epoll 负责事件循环监听,监听到哪个网络连接的数据准备好了,就让 Redis 主线程执行,本质上实现了网络 I/O 与命令执行的解耦。
3. 高效的数据结构和底层编码
每种数据结构都有对应的底层编码优化,提高查询效率,节省内存。比如:
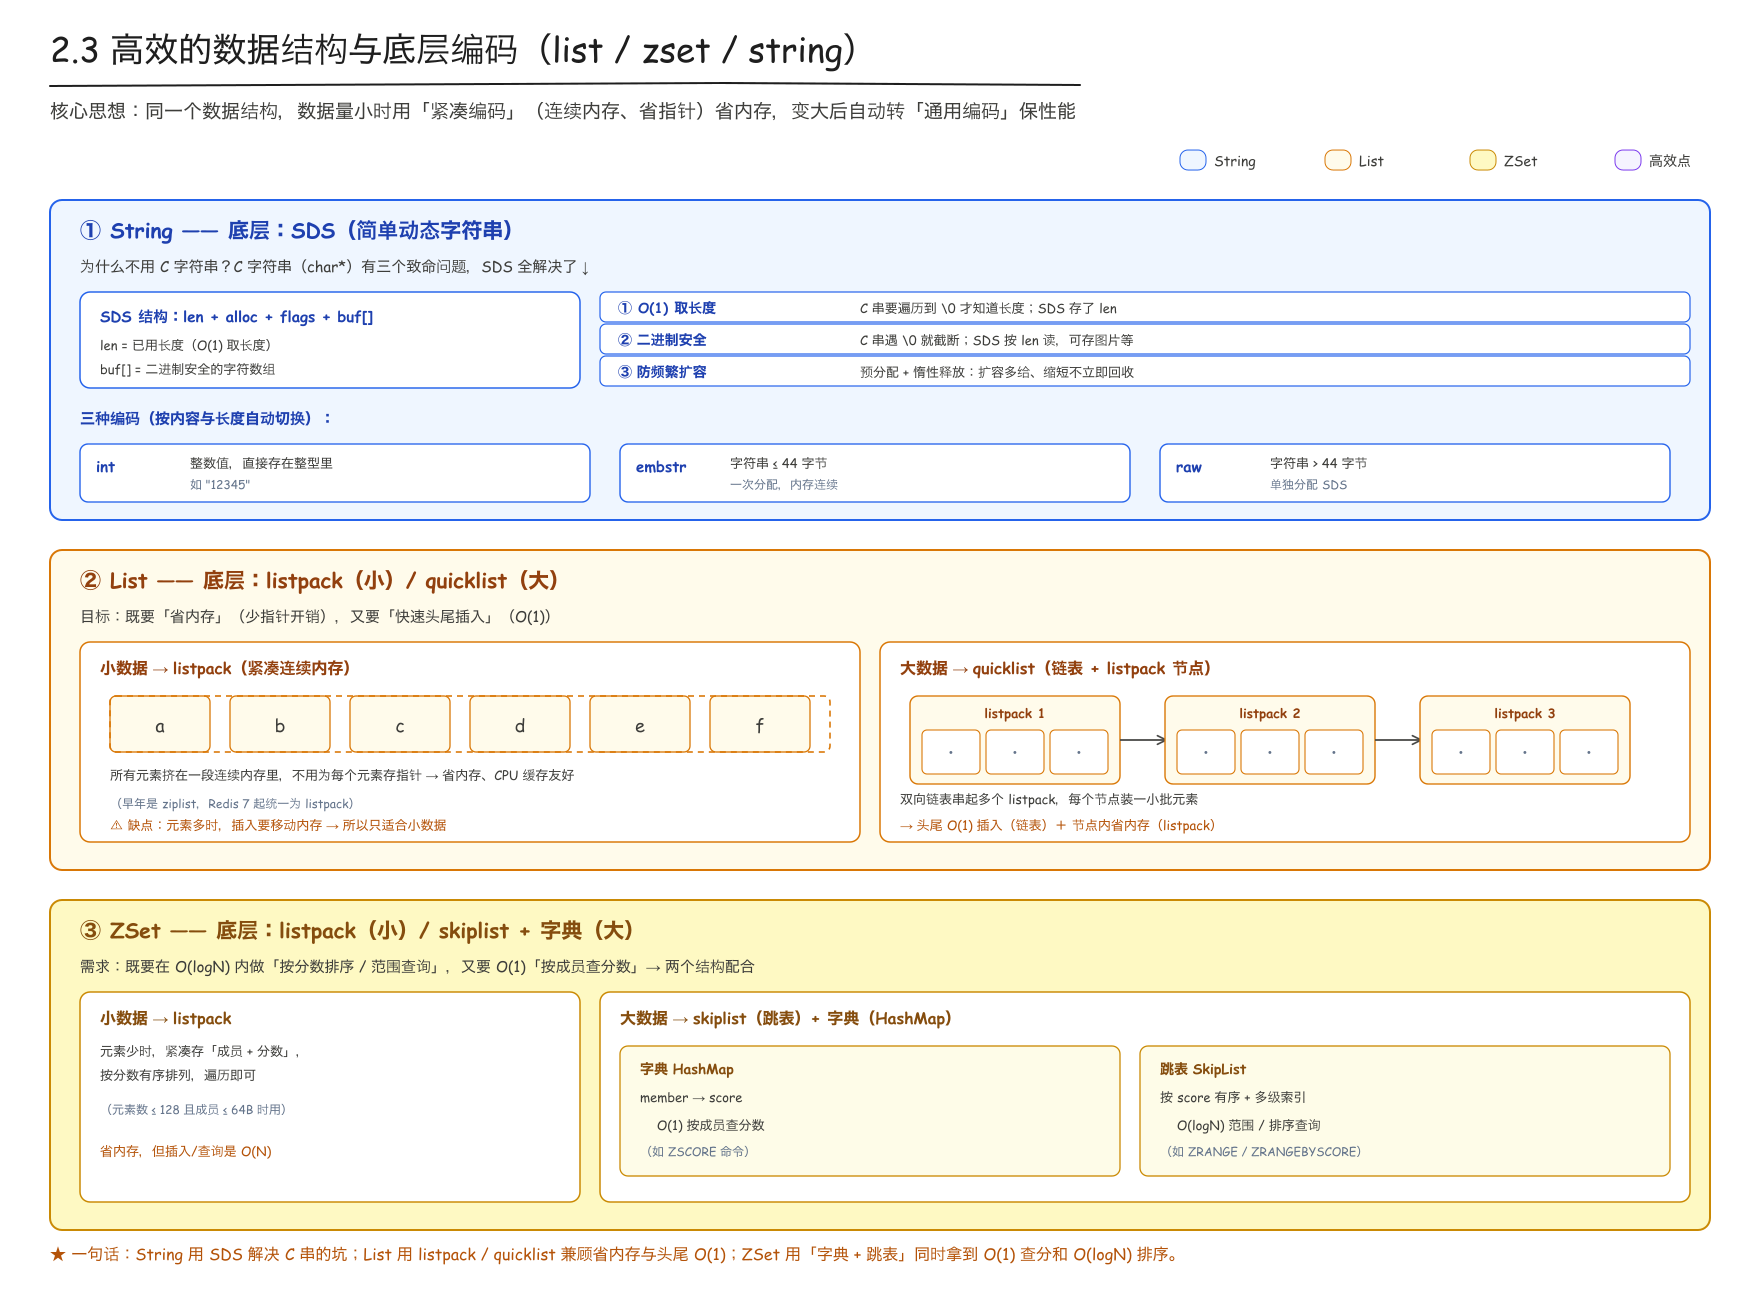
- list / hash 数据量较小时,会使用内存更紧凑的 ziplist 压缩列表存储;
- zset 使用 HashMap + SkipList,既支持 O(1) 的成员查找,又支持 O(logN) 的排序和范围查询;
- String 使用 SDS(简单动态字符串),根据存储内容不同,自动切换 int、embstr、raw 三种编码方式。
4. 非阻塞操作
所有耗时操作 Redis 都会创建子进程,主进程只负责读写。 如:持久化时,主进程调用系统函数 fork 生成子进程进行持久化,避免阻塞主进程。
三、数据结构
思路:5 种基本数据结构 → 3 种高级数据结构
Redis 的数据模型是 Key-Value 模型,Key 通常是字符串,而 Value 可以是多种数据类型。
1. 五种基本数据结构
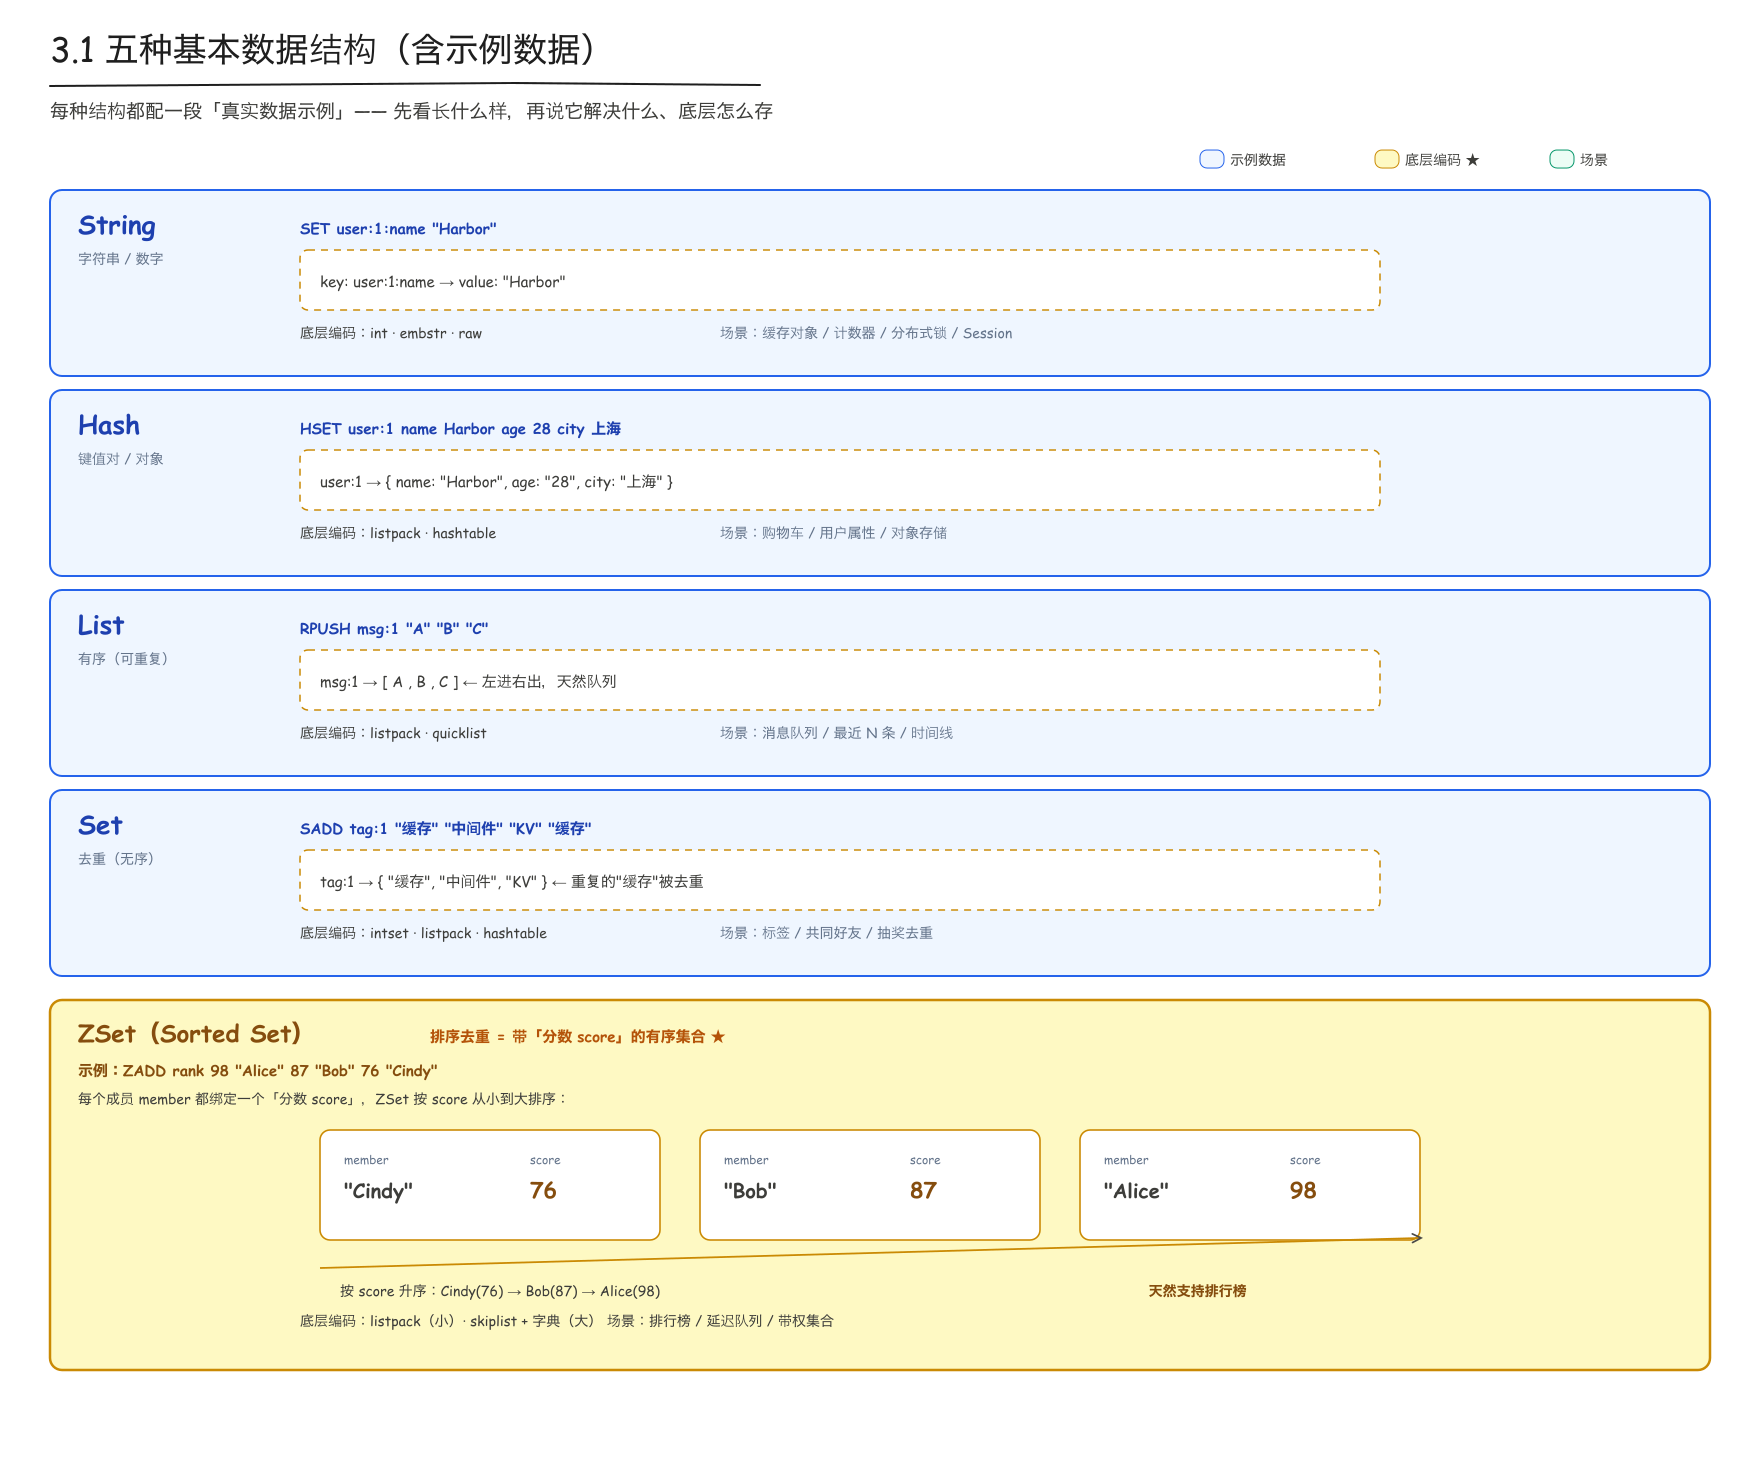
| 结构 | 说明 |
|---|---|
| String | 字符串 |
| Hash | 存键值对 / 对象 |
| List | 有序 |
| Set | 去重 |
| ZSet(Sorted Set) | 排序去重 |
2. 三种高级数据结构
HyperLogLog
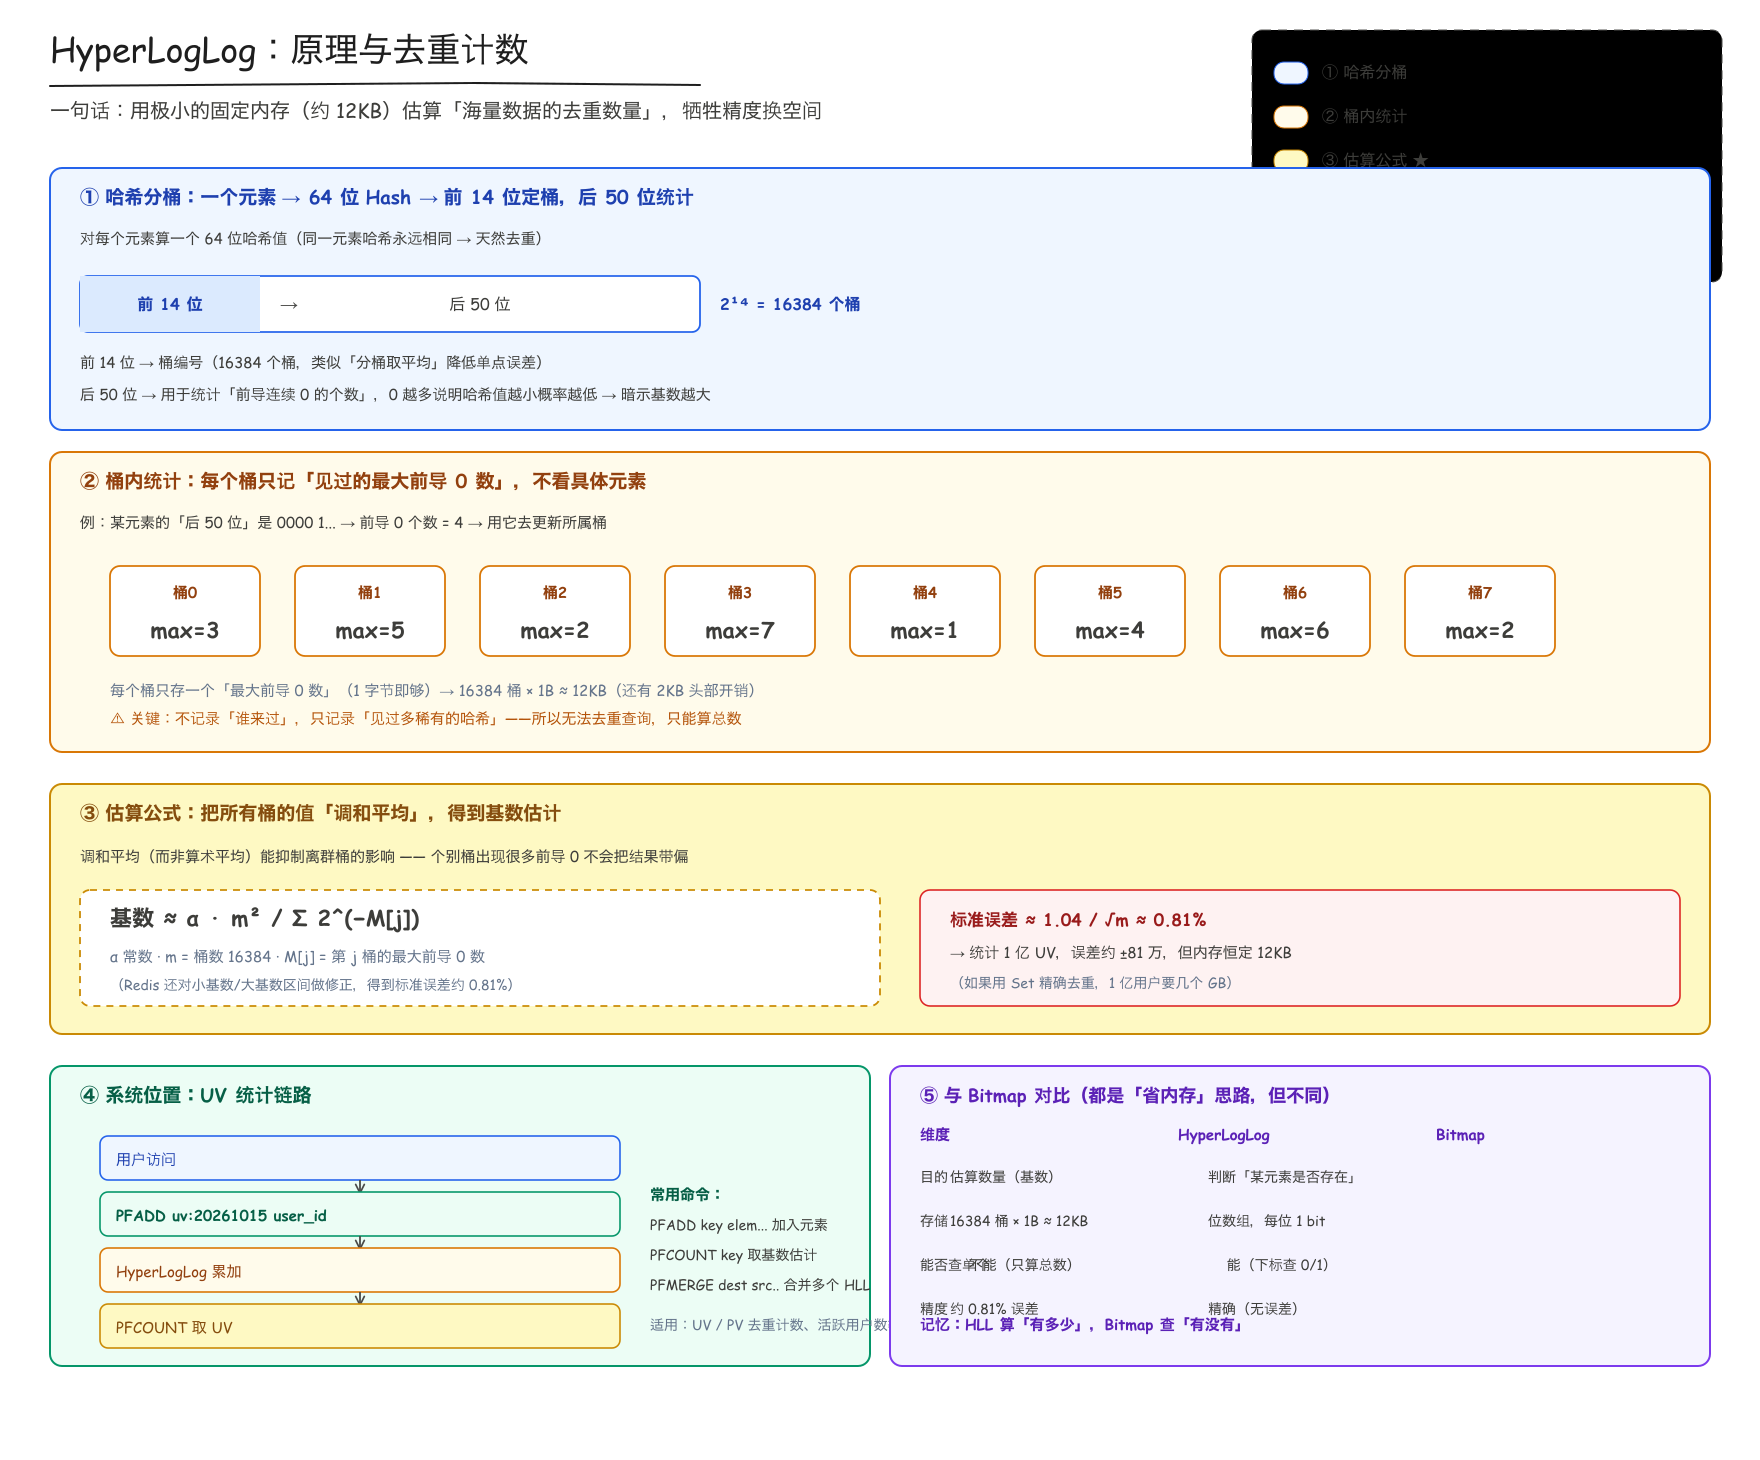
一种用 12KB 内存计算海量数据的去重非精确计数的数据结构,基于增强的 LogLog 算法,用于 UV(unique visitor)统计等场景。
原理:先对元素计算一个 64 位 Hash,使用前 14 位确定元素落入哪个桶(共 2¹⁴ = 16384 个桶),再利用后 50 位统计前导连续 0 的个数。每个桶只记录最大的前导 0 数,最终结合概率统计算法估算去重后的元素数量 —— 因此仅需约 12KB 内存即可统计数十亿级数据,误差约 0.81%。
Bitmap
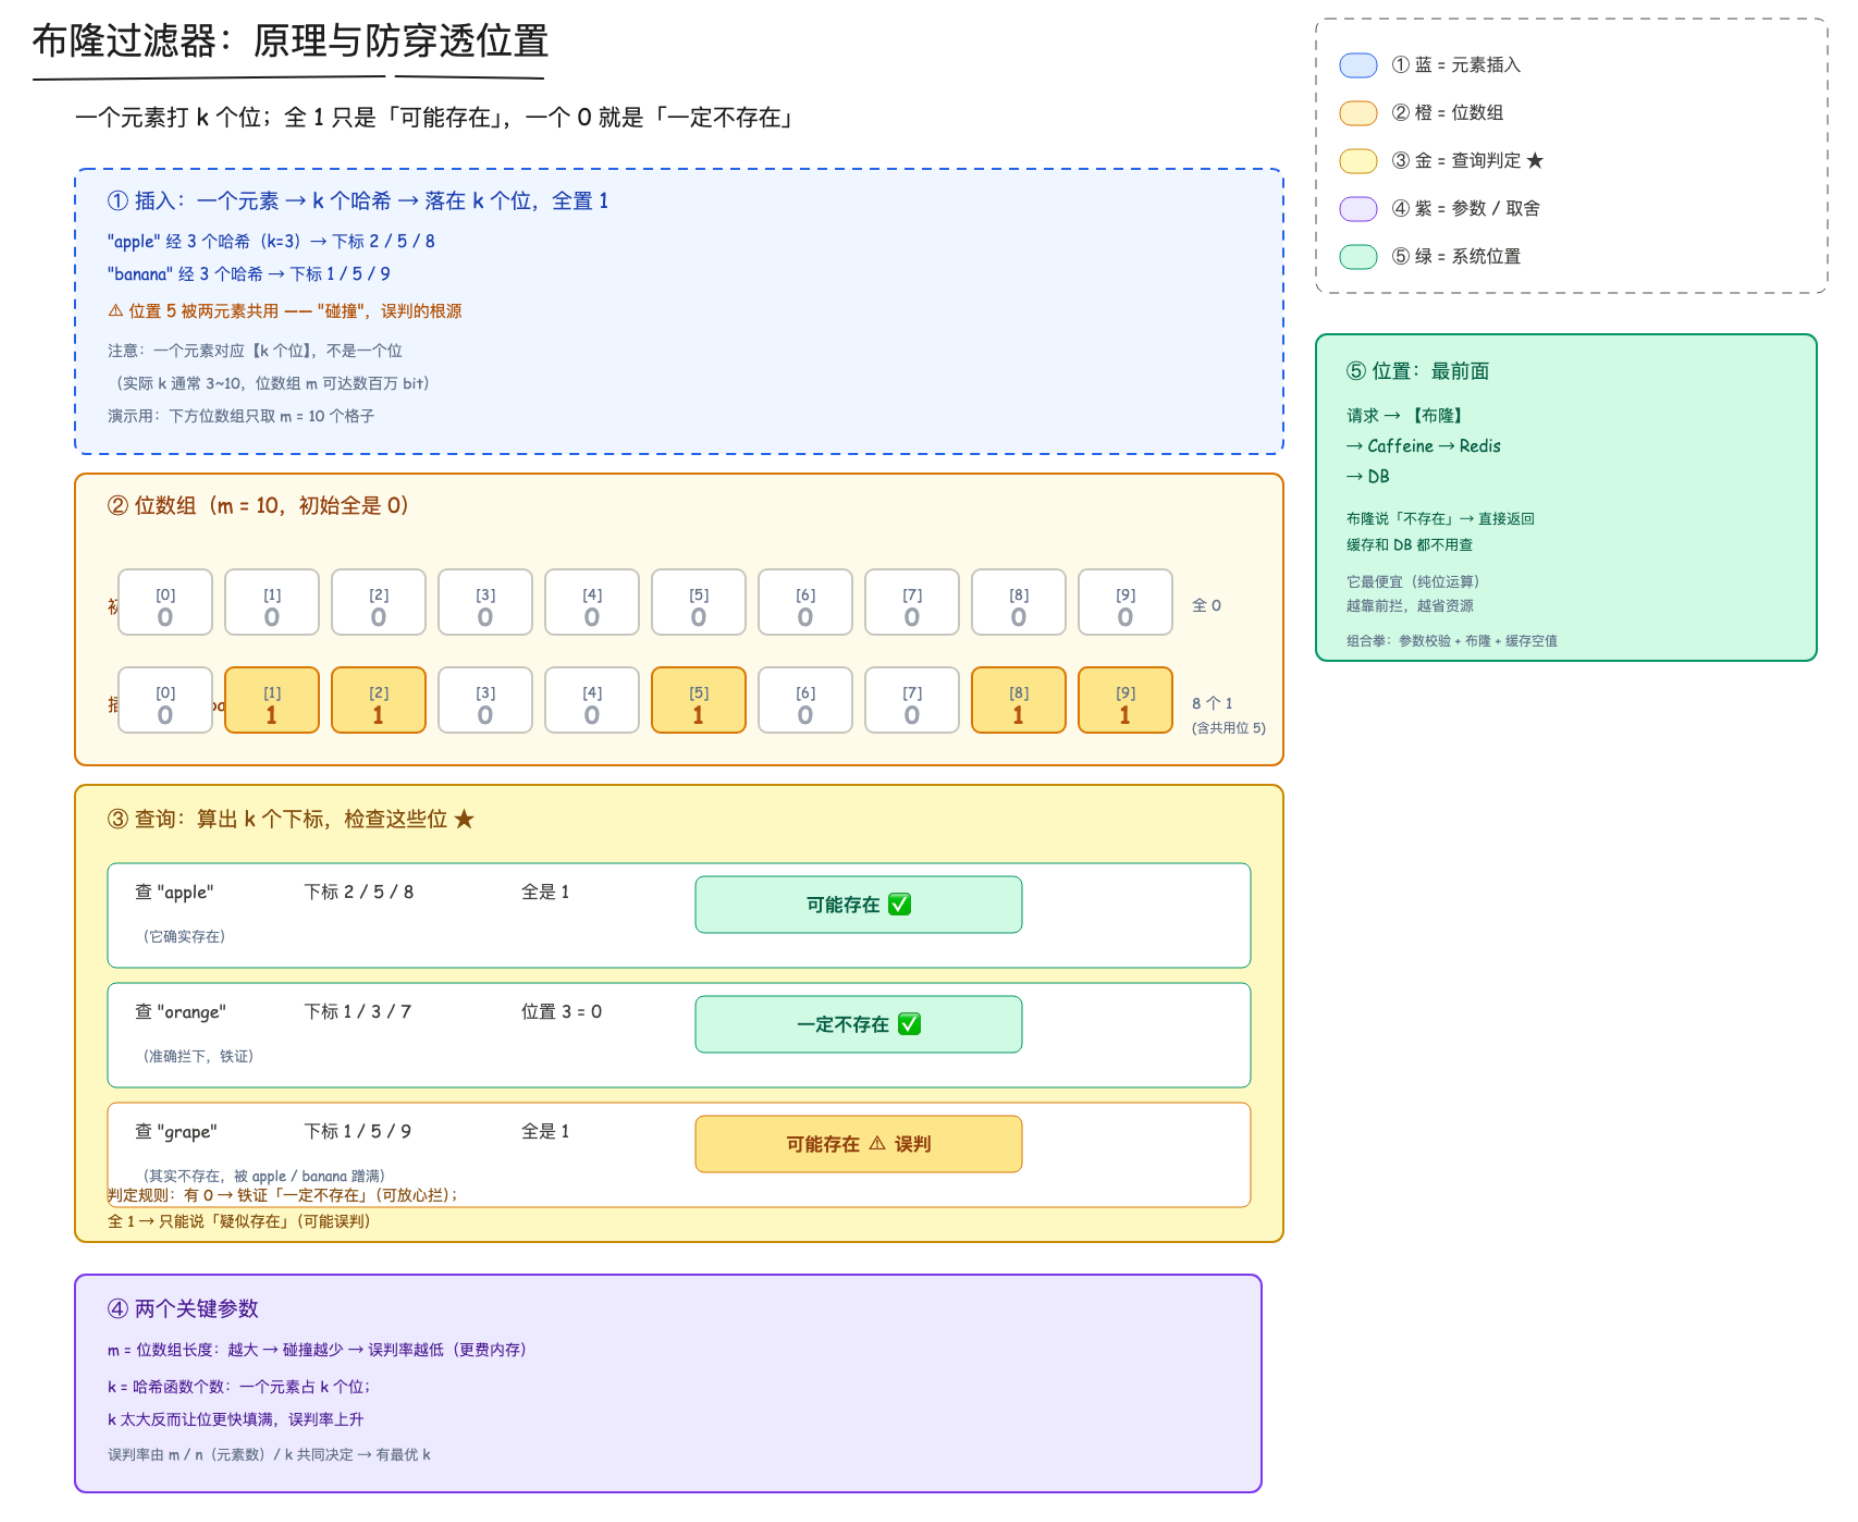
位图,本质上是一个超大的二进制数组,大小为 2³²,每个位置基于 SDS,只能存 0/1,用于判断二值状态。
用途:如布隆过滤器。将对象(如用户 ID)映射为数组下标,用 0/1 表示数据库中有无此数据,快速判断。
布隆过滤器 = 一个 bitmap + k 个 hash 函数 + 判定规则 加在 Caffeine、Redis、MySQL 最前面。
GEO
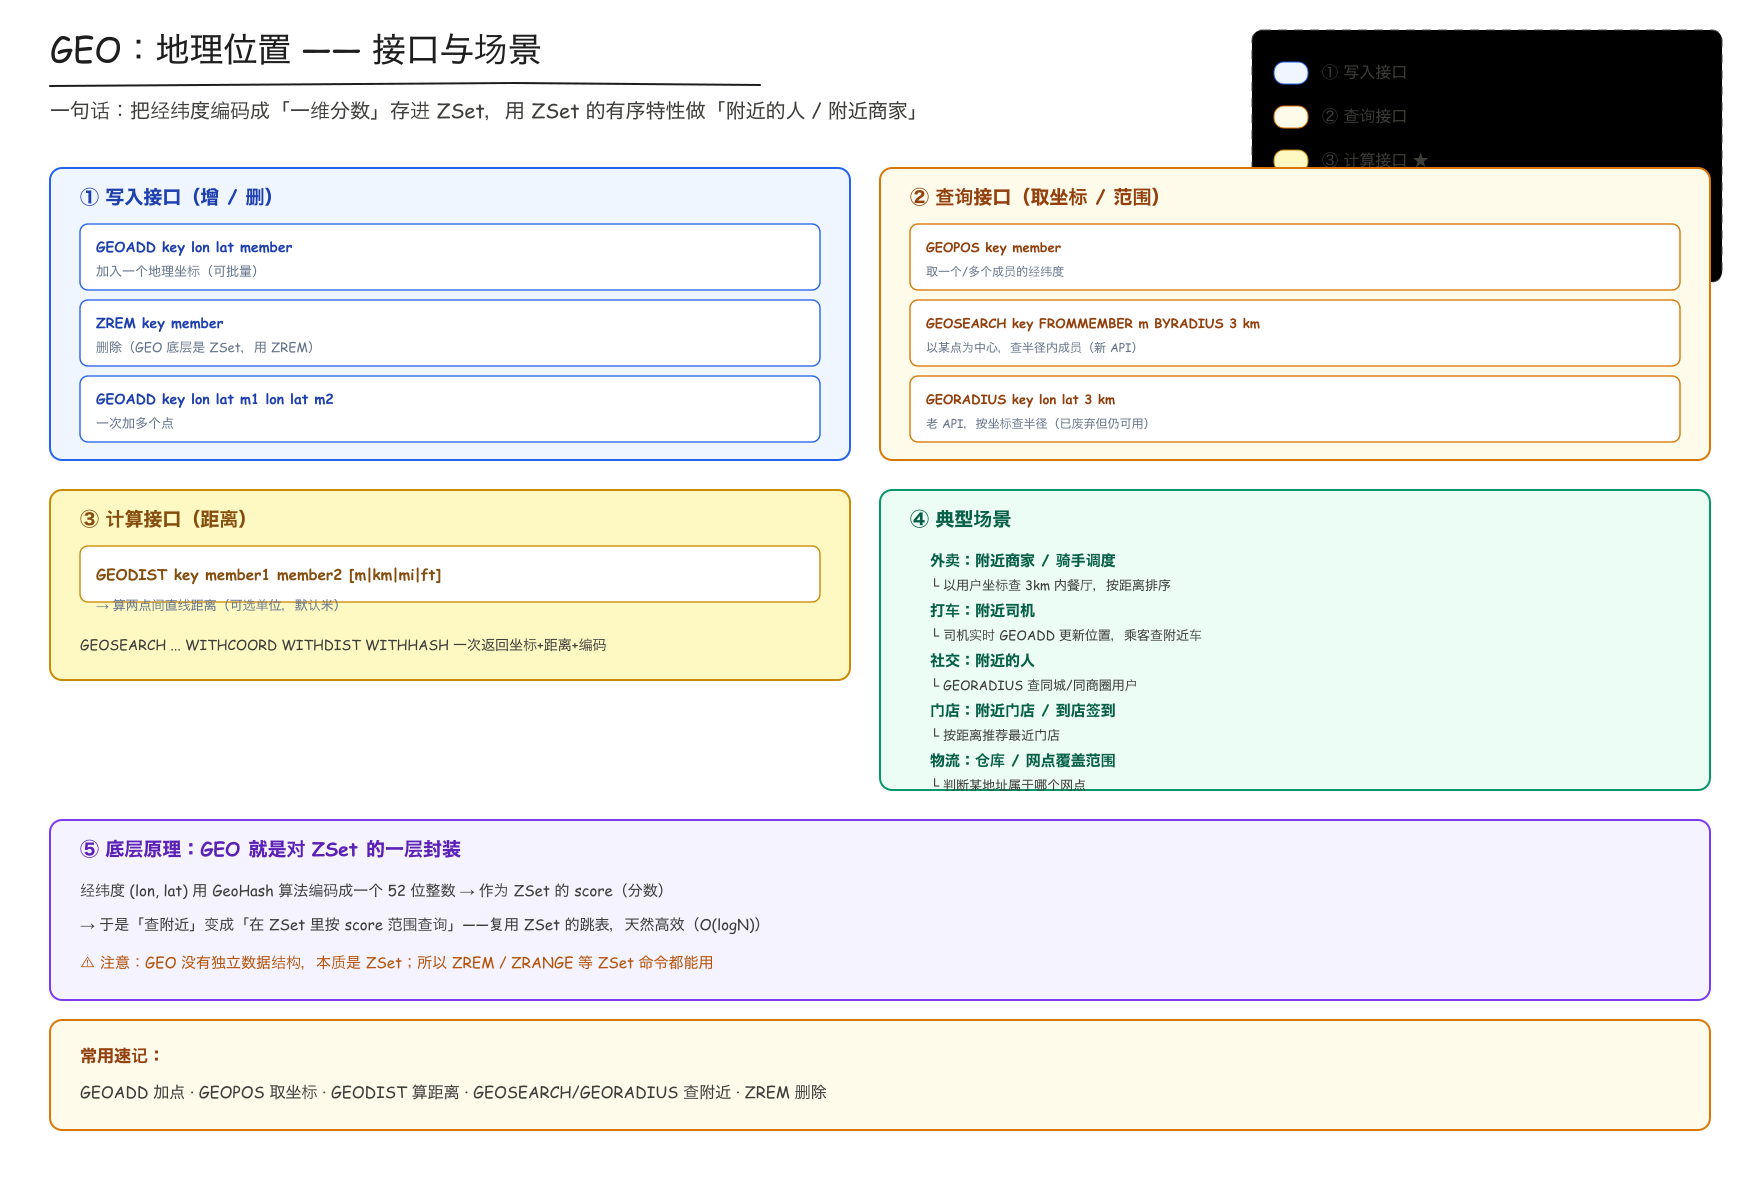
地理位置,用于查询、添加、计算距离、范围查询等地理功能。
四、内存管理
思路:Key 过期删除策略 → 内存淘汰策略
1. Key 过期删除策略
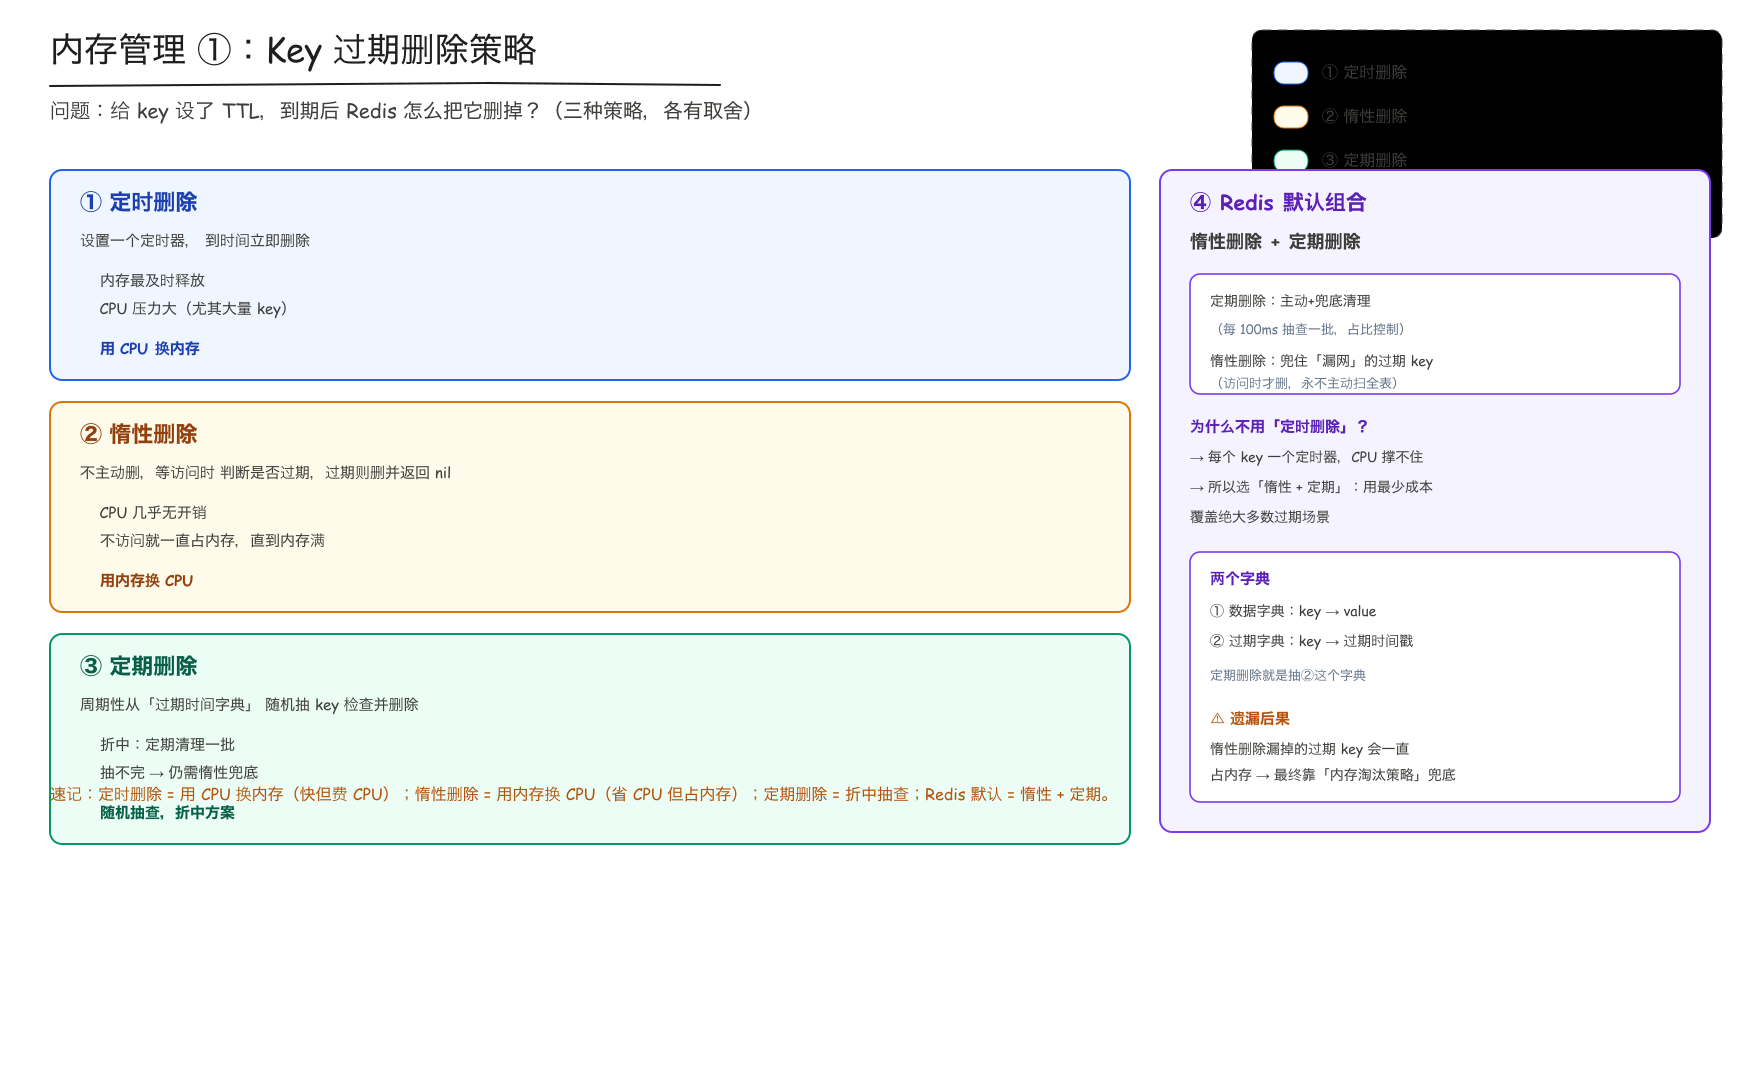
默认:惰性删除 + 定期删除
定时删除
每个 key 设置一个定时器,到时间立即删除。
- 缺点:CPU 压力很大。
惰性删除
不主动删除过期键,而是在访问的时候判断是否过期,过期就删除并返回 nil。
- 缺点:长期不被访问的 key 会一直占用内存直到占满,依赖内存淘汰策略。
定期删除
从过期时间字典中周期性随机抽取设置了过期时间的 key,检查并删除过期的 key。
Redis 有两个字典:数据字典 + 过期时间字典。ttl
2. 内存淘汰策略
三大类、八种。
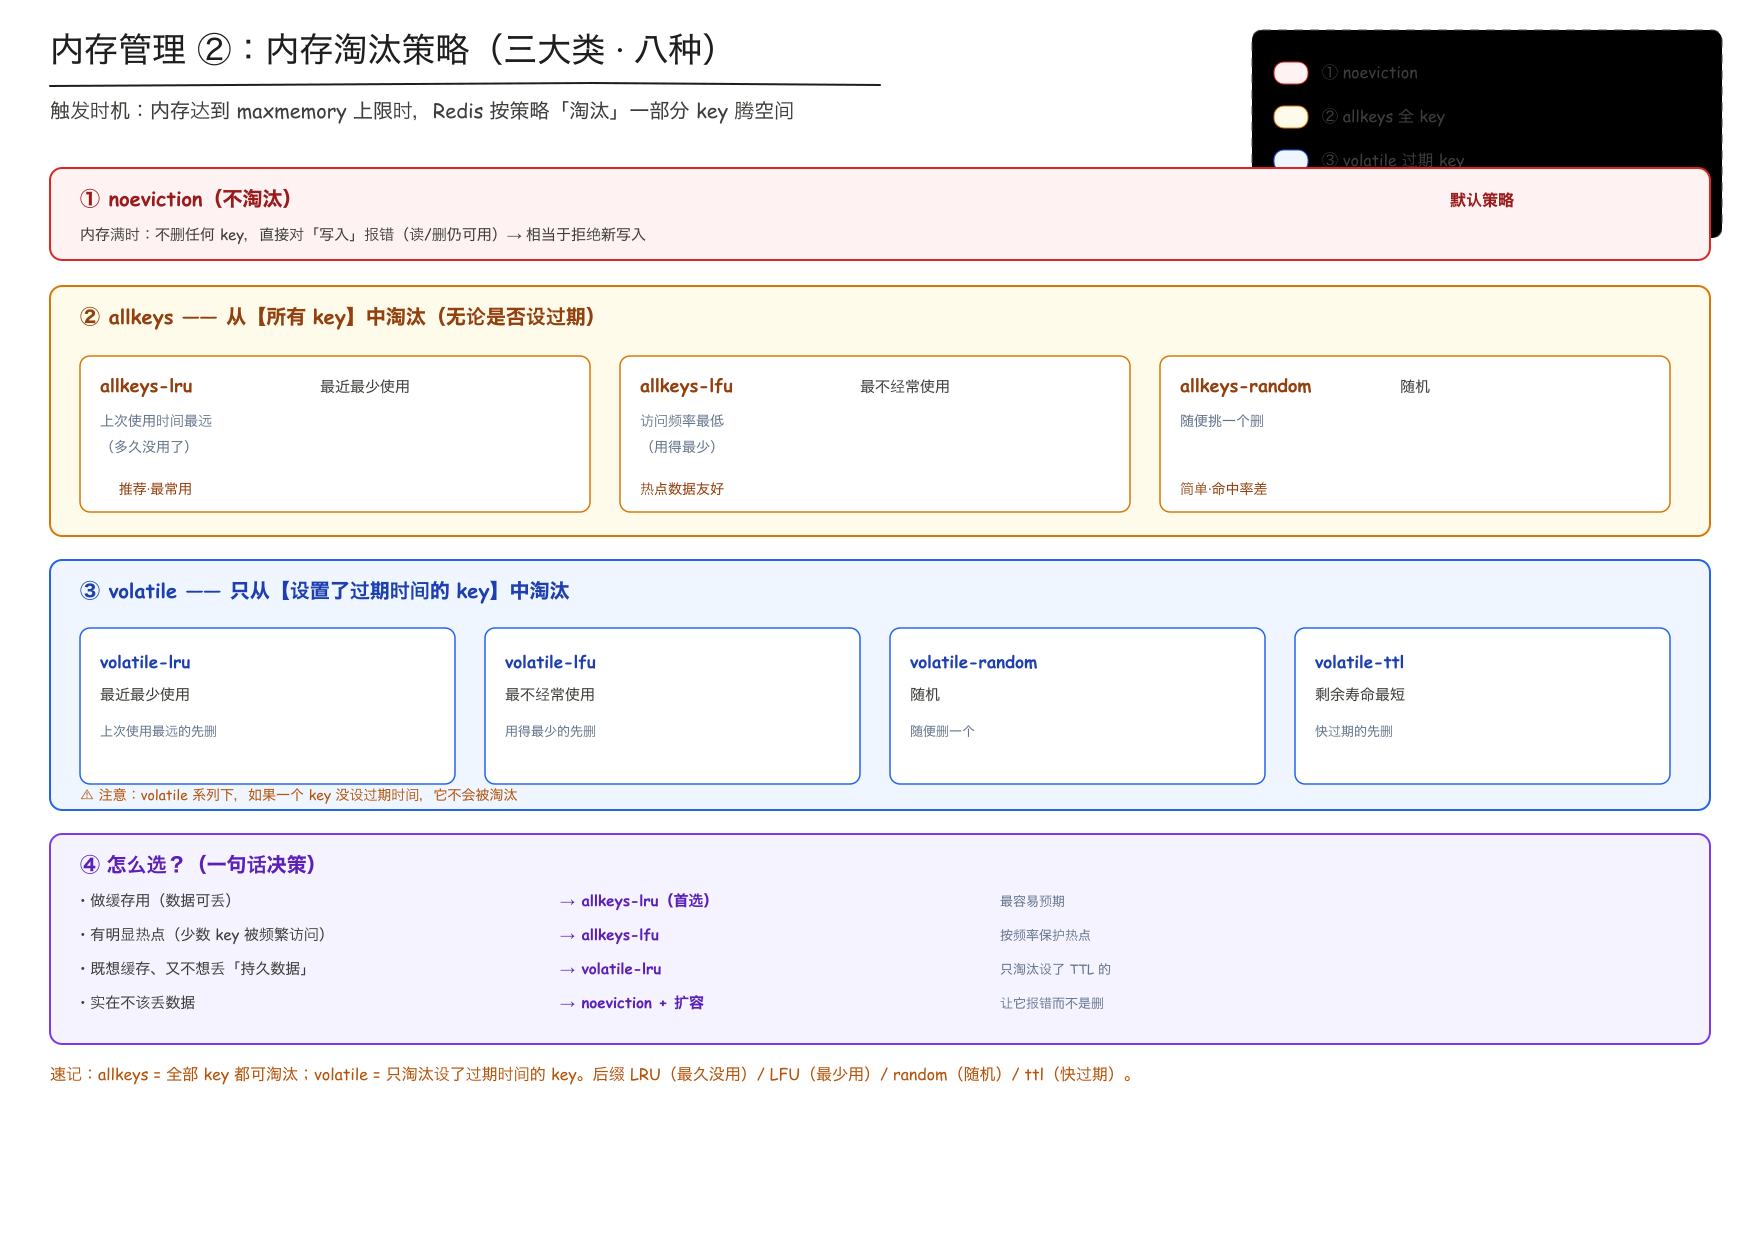
noeviction
不淘汰,禁止新的写入。
allkeys —— 全 key 淘汰
| 策略 | 含义 |
|---|---|
| allkeys-lru(推荐) | 上一次使用时间最远 |
| allkeys-lfu | 使用频率最少 |
| allkeys-random | 随机 |
volatile —— 过期 key 淘汰
| 策略 | 含义 |
|---|---|
| volatile-lru | 上一次使用时间最远 |
| volatile-lfu | 使用频率最少 |
| volatile-random | 随机 |
| volatile-ttl | 剩余过期时间最短的 key |
五、缓存问题及方案
思路:旁路缓存 → 缓存穿透 → 缓存击穿 → 缓存雪崩 → 缓存一致性
0. 旁路缓存
概念(理解)
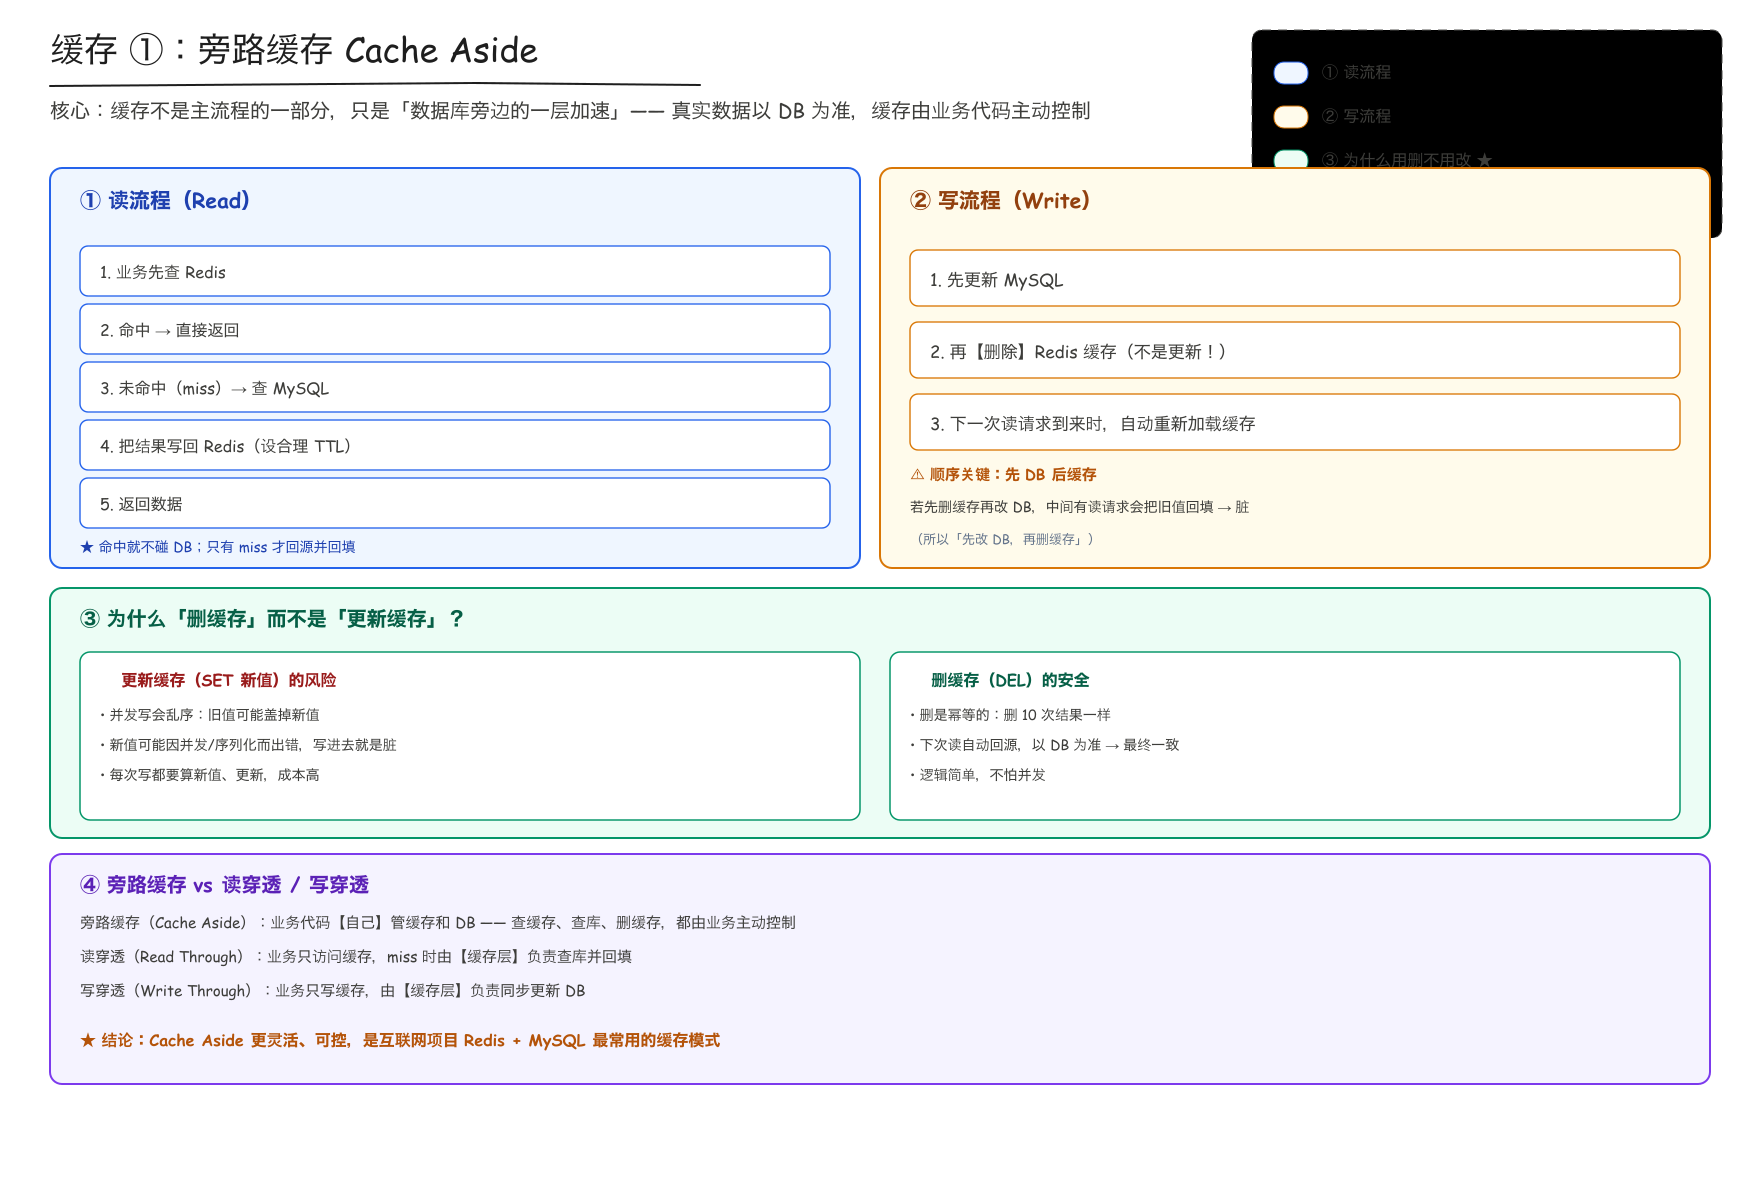
旁路缓存(Cache Aside)是一种常见的缓存设计模式,它的核心理念是:缓存并不是业务主流程中的一部分,而是作为数据库旁边的一个加速层存在。系统中的真实数据仍然以数据库(如 MySQL)为准,Redis 等缓存只是用于提高查询效率、降低数据库压力。
在这种模式下,缓存和数据库之间的数据交互逻辑由业务代码主动控制 —— 业务代码决定什么时候查询缓存、什么时候查询数据库,以及什么时候更新或删除缓存。
例如查询数据时,业务先查询 Redis,如果缓存命中则直接返回;如果缓存不存在,则查询 MySQL,并将查询结果写入 Redis。
例如删除 / 更新数据时,业务先改 MySQL,再删除 Redis 中的旧缓存,而不去更新它,等到下次查询时再更新 Redis。
这里不采用"直接更新"而是"删除",主要原因是:更新缓存需要写入一个新值,而这个新值可能因为并发、业务逻辑、序列化等原因变成错误的数据。所以直接删除,等待下一次请求打到数据库时重新写 Redis。
旁路缓存主要是相对于 Read Through(读穿透) 和 Write Through(写穿透) 来理解的:
- 读穿透:业务只访问缓存,如果缓存没有数据,由缓存层负责查询数据库并回填缓存;
- 写穿透:业务只负责写入缓存,由缓存层负责同步更新数据库;
- 旁路缓存:不依赖缓存层自动完成数据库操作,而是由业务代码同时管理缓存和数据库。
因此 Cache Aside 模式更加灵活,也是实际互联网项目中 Redis + MySQL 架构最常使用的一种缓存模式。
读流程
- 查询 Redis;
- 命中则直接返回;
- 未命中则查询 MySQL;
- 将数据写入 Redis(设置合理 TTL);
- 返回数据。
写流程
- 更新 MySQL;
- 删除 Redis 缓存;
- 下一次读取时重新加载缓存。
为什么删除缓存,而不是更新缓存? 更新数据库后直接删除缓存,可以避免"更新缓存失败"导致的数据库与缓存数据不一致;删除缓存后,由后续读请求重新加载缓存,更容易保证最终一致性。
1. 缓存穿透
概念:Redis 和数据库中数据都不存在,但每次都查数据库。
三者(穿透 / 击穿 / 雪崩)一张图分清 ↓
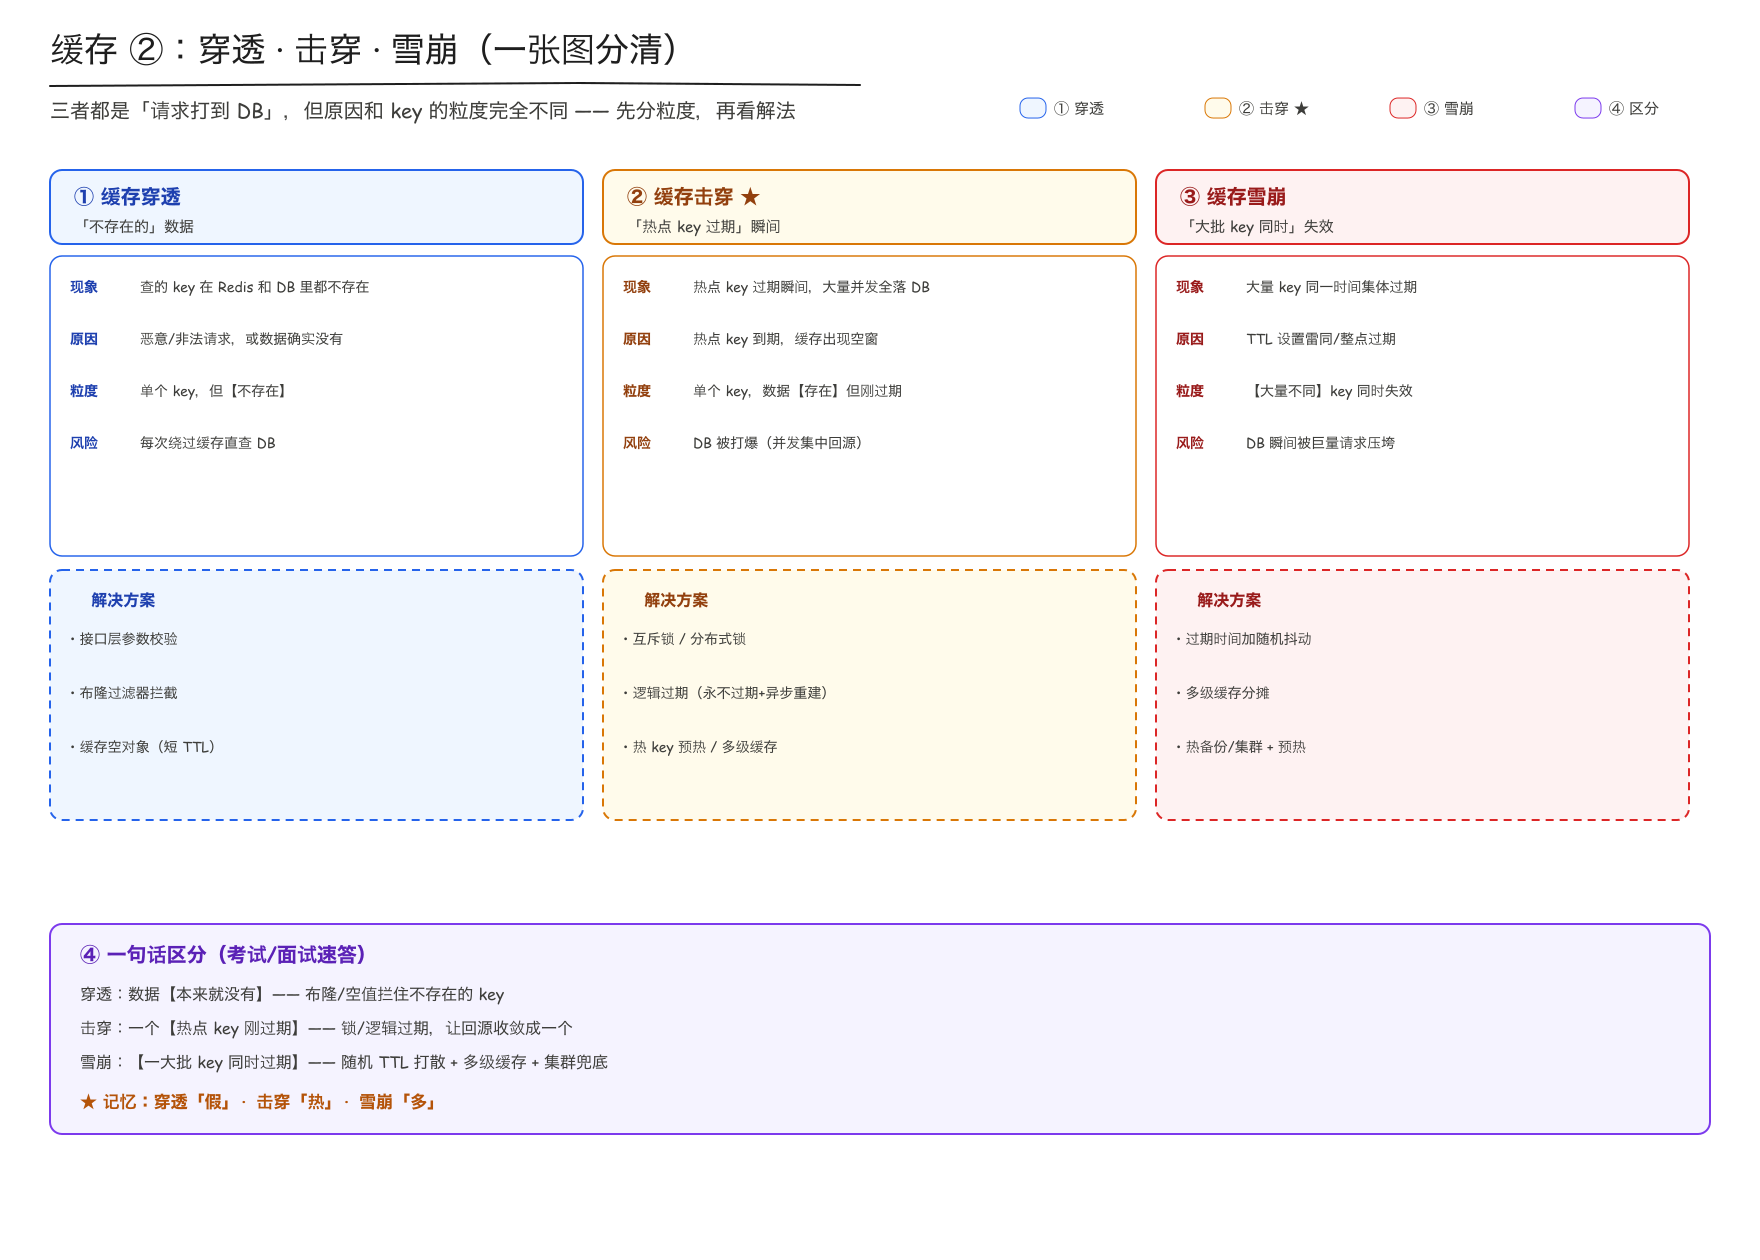
解决方案
- 接口层加强参数校验;
- 布隆过滤器(见前面 Bitmap);
- 缓存空对象。
2. 缓存击穿
概念:大量请求集中访问某些热点 key,Redis 中刚好没有,打到数据库中,导致数据库压力很大。
解决方案
- 多级缓存:本地缓存(Guava Cache / Caffeine,几秒到几十秒)+ Redis(几分钟)+ MySQL 三层;
- 热 key 预加载:提前识别并加载某些 key 到 Redis;
- 逻辑过期(很少用,部分秒杀场景,破坏了旁路缓存的策略)—— 由业务代码控制:
- key 不设置过期时间,而是加一个过期时间戳字段;
- 查询时如果过期,就去数据库中重新查一遍,然后在 Redis 重建缓存数据和过期时间;
- 比如 10000 个请求过来,会
tryLock():如果抢到锁,就去 Redis 重建缓存数据和过期时间;其他抢不到锁的返回旧值。
3. 缓存雪崩
概念:同一时间大量 key 集中失效,打到数据库。
解决方案
- 多级缓存:本地缓存(Guava Cache / Caffeine)+ Redis + MySQL 三层;
- 热备份:多个 Redis 集群,雪崩时切换;
- 热 key 预加载:提前识别并加载某些 key 到 Redis;
- 随机过期时间:存 key 的时候为过期时间加随机偏移,避免同时过期。
4. 缓存一致性
概念:MySQL 和 Redis 数据不同步。
解决方案:3 种方案均为"通知 Redis 删除缓存",而非更新,保证旁路缓存策略。
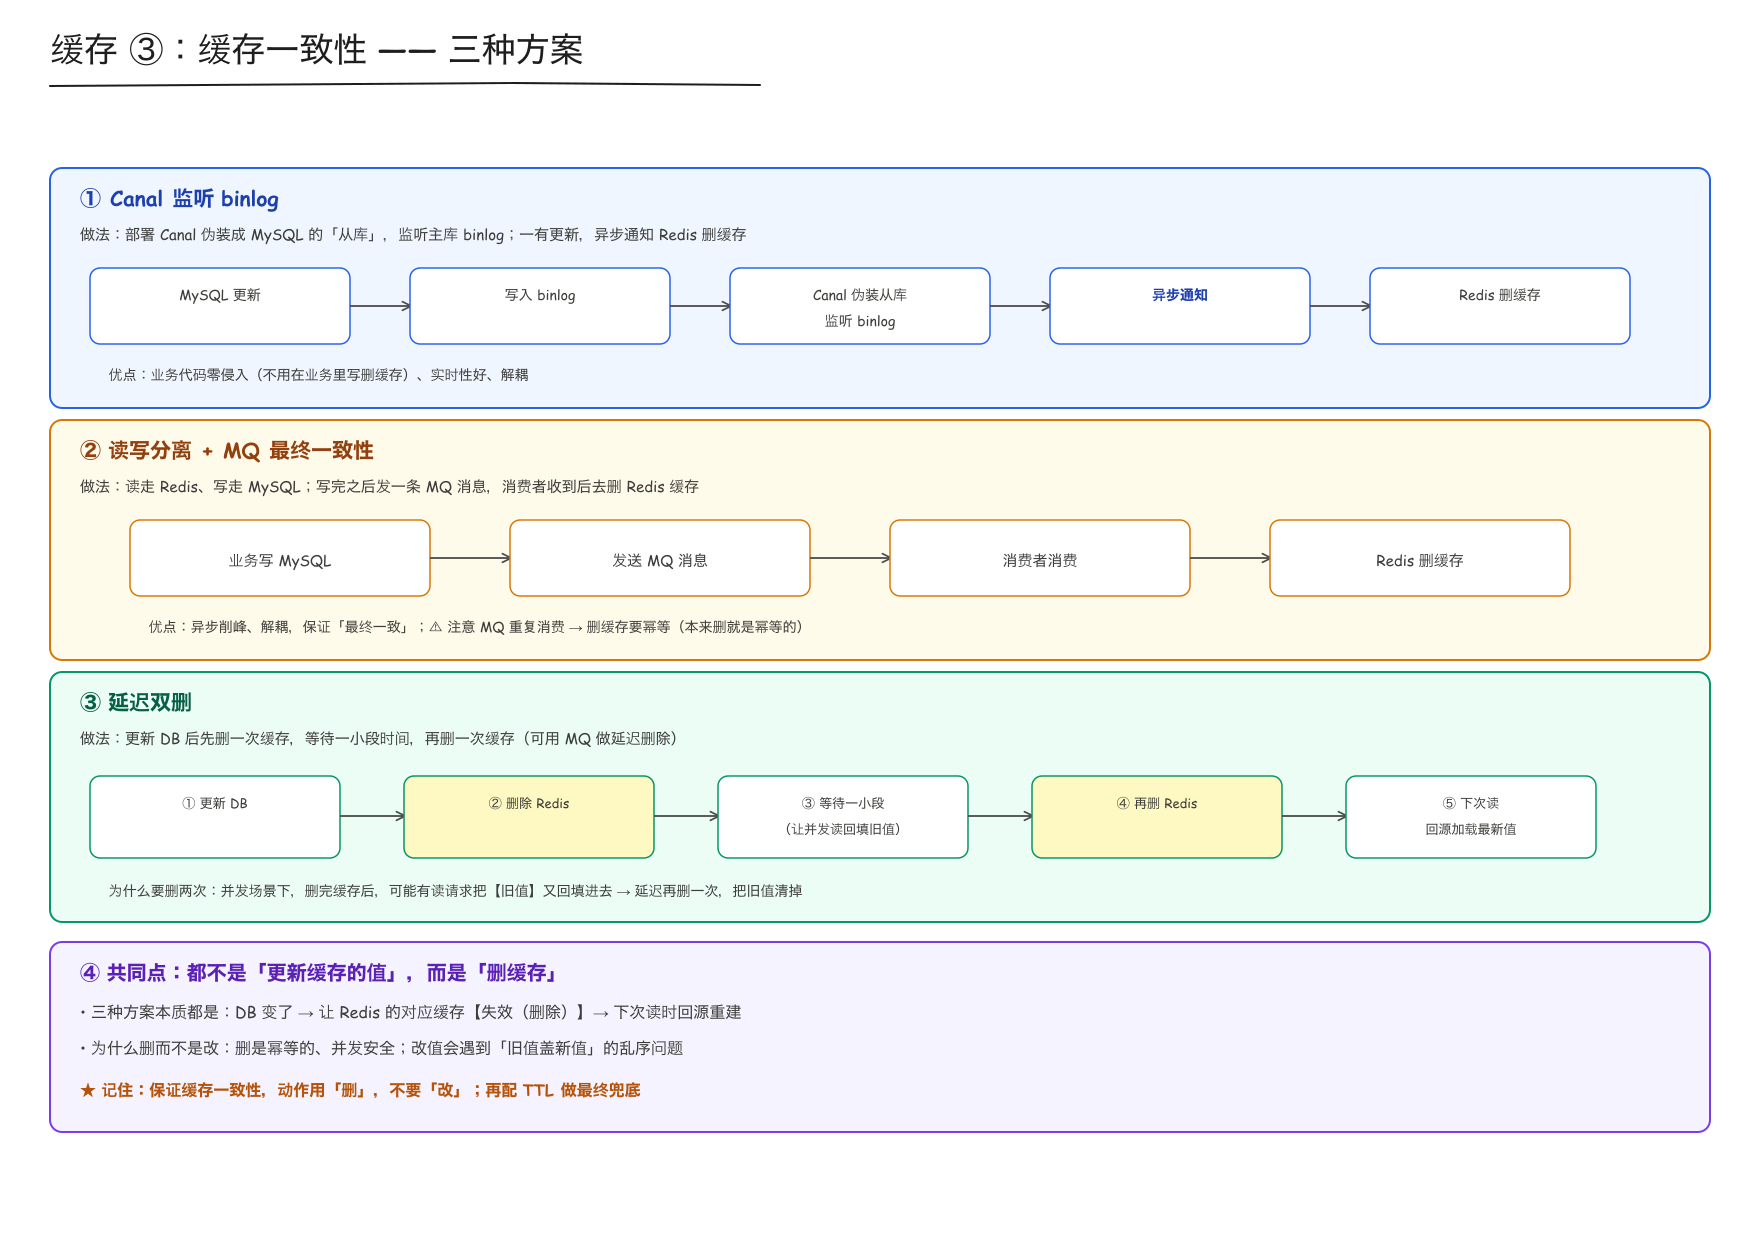
- Canal 监听 binlog:部署 Canal 伪装成从库监听主库的 binlog,监测到更新之后异步通知 Redis 删缓存,实现实时同步。
- 读写分离 + MQ 最终一致性:读从 Redis,写从 SQL,写后通过 MQ 通知消费者让 Redis 删除缓存,保证最终一致性。
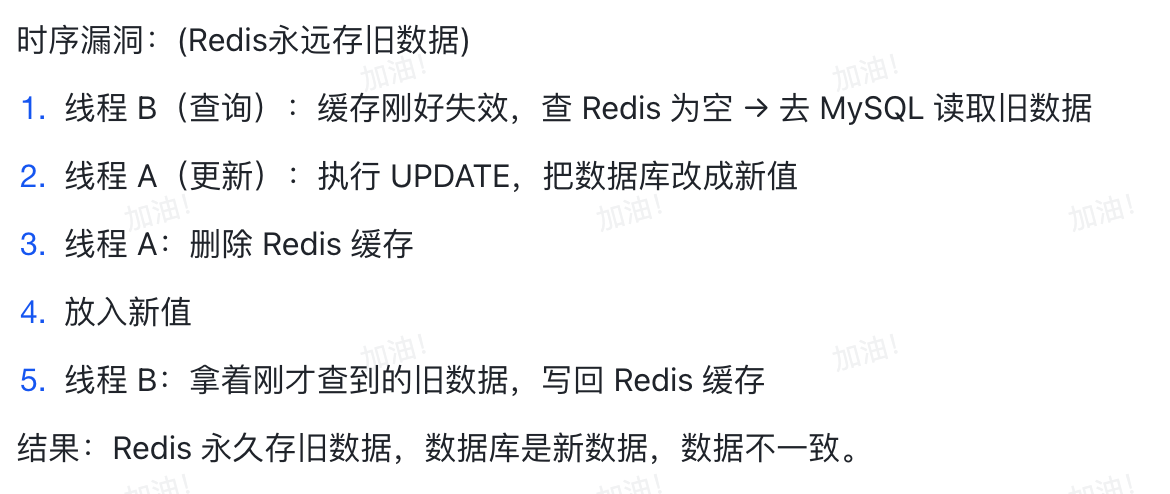
- 延迟双删:更新 DB 之后,先删除 Redis,等待一段时间(让其他读线程读到旧数据并更新到 Redis),再删除一次 Redis,然后加载最新数据到 Redis。可以使用 MQ 进行延迟删除。
为什么要进行延迟双删?
六、分布式锁
思路:什么是分布式锁 → 解决了什么问题 → Redis 实现分布式锁的 7 大问题 → Redisson 完美解决方案
1. 什么是分布式锁
分布式服务下,多个服务都可以访问到的、控制共享资源的锁,就是分布式锁。
2. 为什么需要分布式锁
单机系统中的 synchronized 或者 Lock 只能实现对单机系统内资源的控制,在分布式系统中就需要使用分布式锁。
比如:超卖库存扣减问题、优惠券重复领取问题。
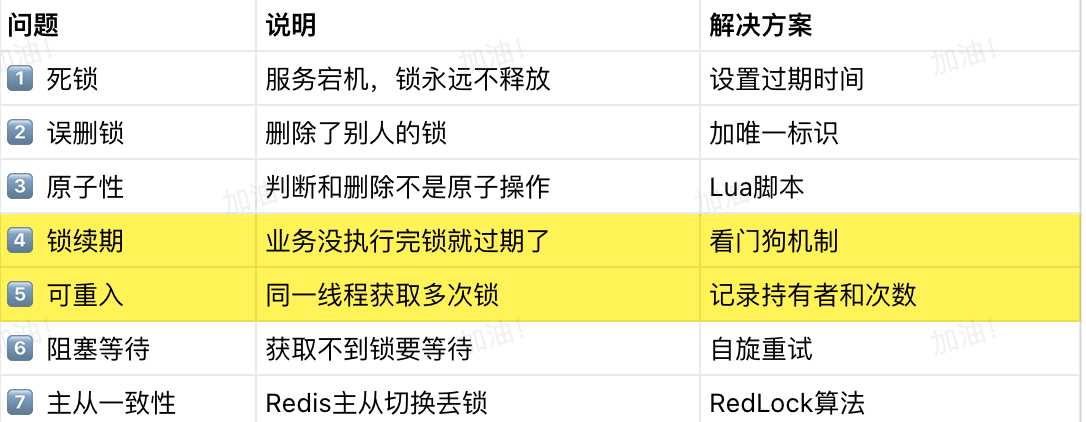
3. Redis 实现分布式锁及问题
SETNX key value(SET if Not eXists):如果不存在则 set。
4. Redisson 完美解决方案
Redisson = Redis 的增强版客户端,解决了上面的所有问题。
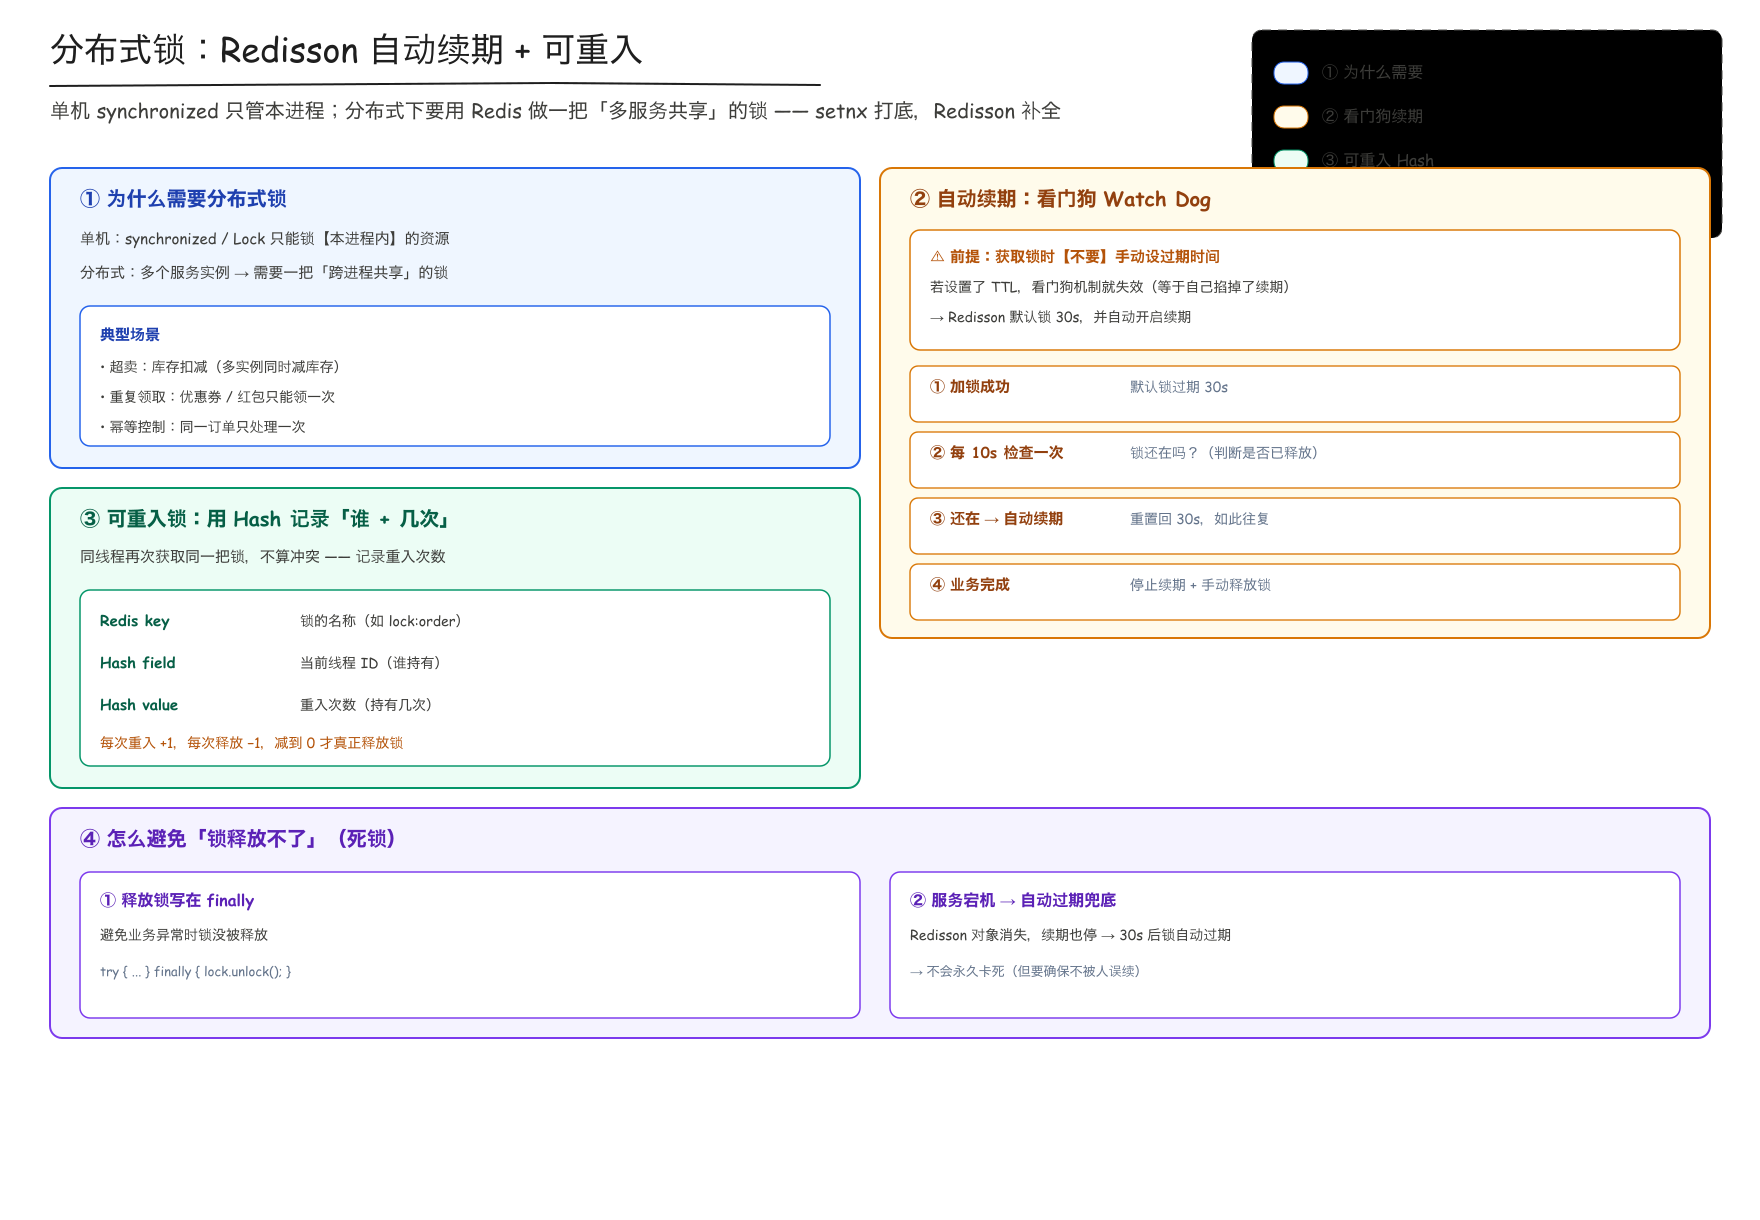
这里着重说一下锁续期和可重入,Redisson 是怎么做的。
自动续期
即看门狗机制(watch dog)。
前提:使用 Redisson 获取分布式锁时不要设置过期时间,如果设置了,看门狗就会失效。
流程:
- 默认锁过期时间 30s;
- 每隔 10s 检查一次,检查这个锁还在不在 —— 如果不在说明你手动释放了;如果在,自动续期到 30s;
- 业务完成后,停止续期,手动删除 / 释放锁。
如何避免锁释放不了?
- 释放锁的代码写在
finally中,避免异常情况下不能释放锁; - 服务宕机了,Redisson 对象也不在了,也不会自动续期,默认 30s 后锁自动过期释放。
可重入锁
原理:Redisson 创建分布式锁时使用的是 Hash 结构 ——
- Redis 的 key 就是锁的名称;
- Hash 中的 field 是当前线程的 ID;
- Hash 中的 value 是当前线程重入的次数。
每次重入都会 +1,每释放一次就 -1,直到为 0,锁就释放掉了。
七、持久化
思路:RDB → AOF → 混合持久化
1. RDB
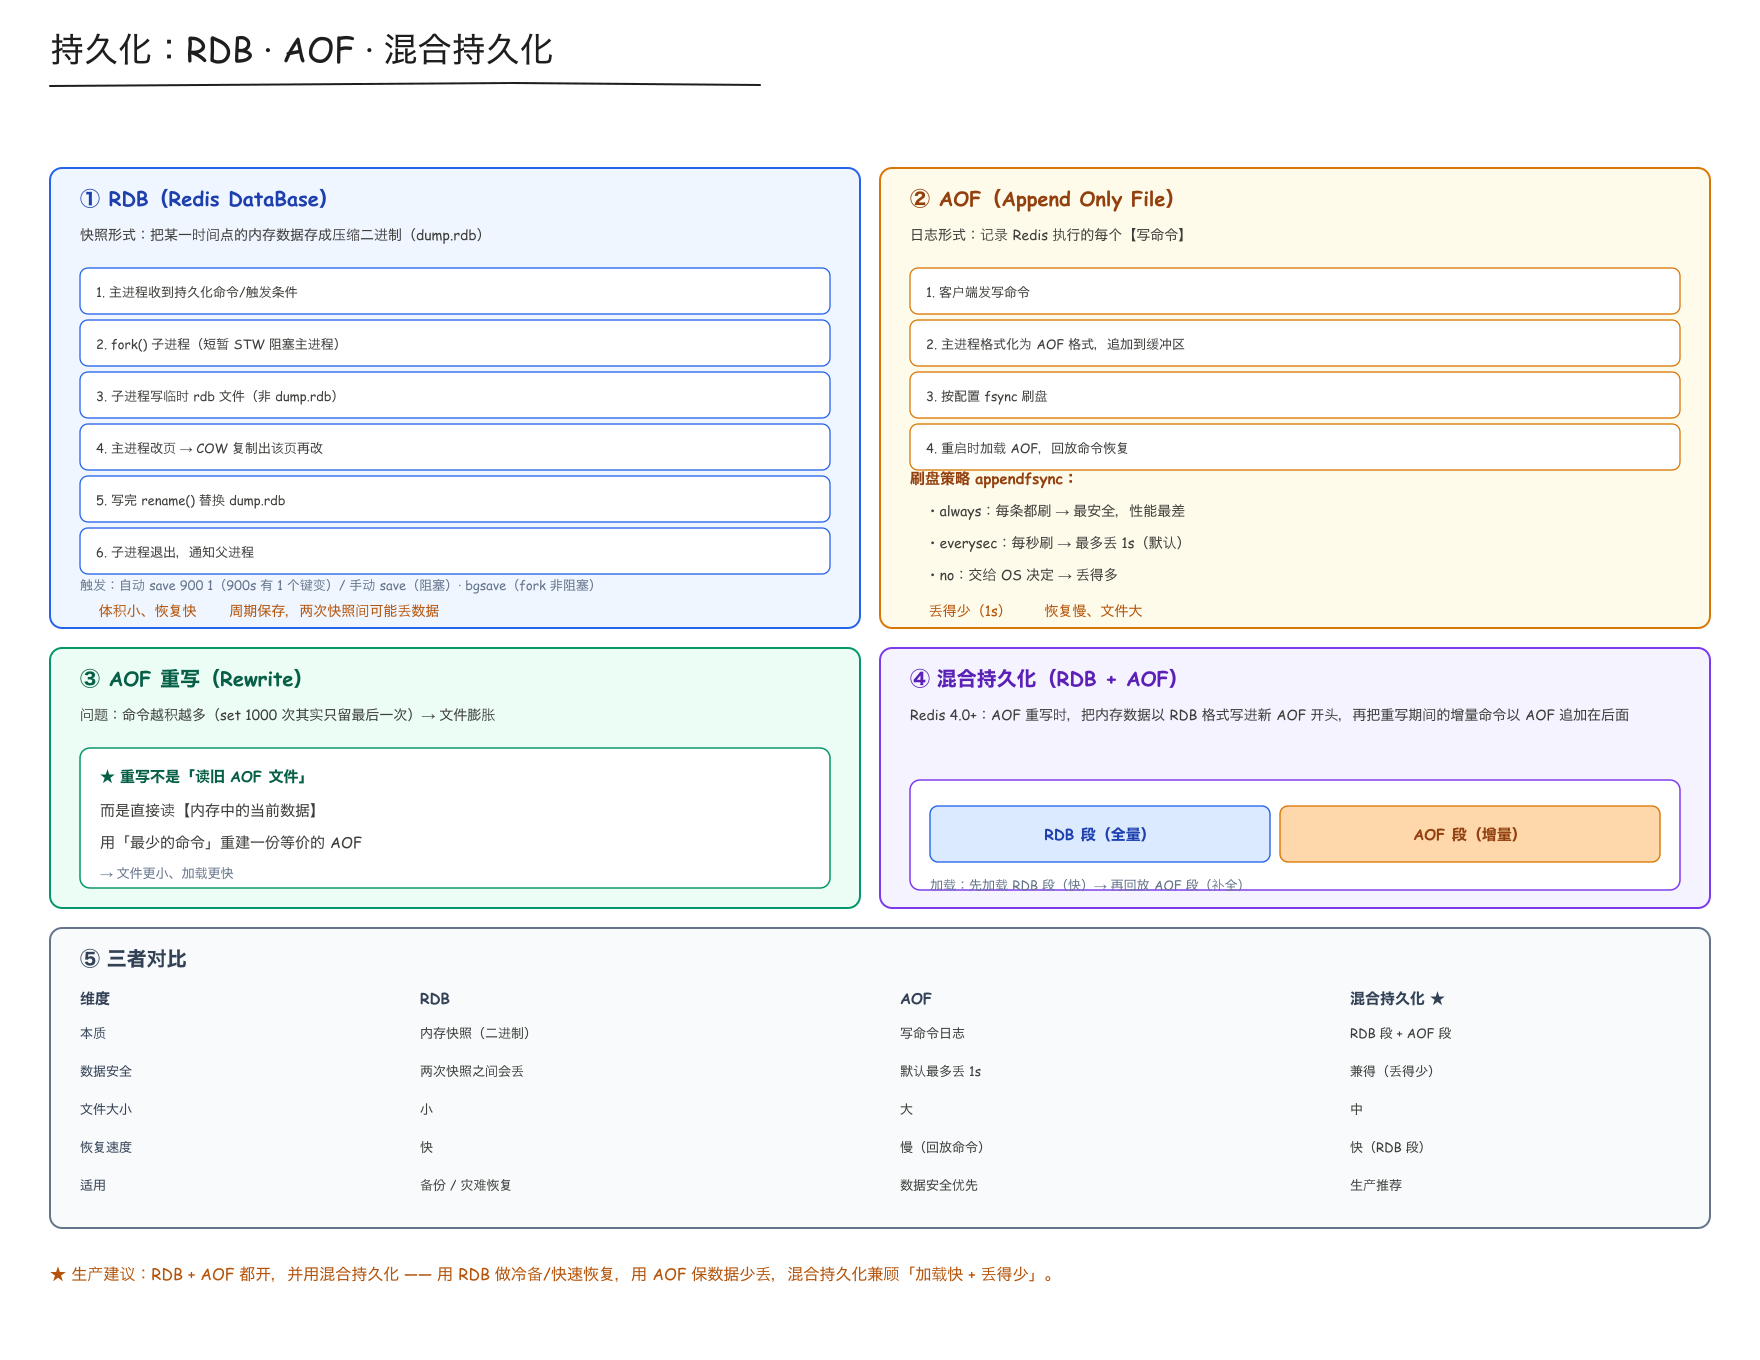
Redis DataBase:快照形式,把一个时间点的内存数据保存到磁盘,生成一个经过压缩的二进制文件(.rdb 文件)。
持久化过程
- 主进程接收到持久化命令或者触发条件;
- 主进程执行
fork()操作创建子进程,此时会短暂地 stop the world 阻塞主进程。创建完后主进程和子进程共享同一块内存数据; - 此时子进程开始写入临时的 rdb 文件(而不是主进程的 dump.rdb);
- 这个过程中如果主进程要修改页数据,需要 COW(Copy On Write) 复制出要修改的页,在新页上修改;
- 子进程完全写入 rdb 文件后调用
rename()将临时 rdb 改名为 dump.rdb,替换掉旧文件; - 子进程退出,通知父进程,父进程用新页替换掉旧页。
触发时机
自动触发:配置文件 save 900 1 —— 每 900s 有 1 个键发生变化,就触发持久化。
手动触发:
save:阻塞式触发,主进程生成快照;bgsave:非阻塞触发,使用 fork。
优缺点
- 优点:只保留最后的数据状态,体积小,恢复快;
- 缺点:周期性保存,可能有部分数据丢失(如两次快照之间主进程写入的新数据)。
2. AOF
Append Only File:日志形式,记录 Redis 执行的每个写命令。
持久化过程
- 客户端发送写命令;
- Redis 主进程把命令格式化为 AOF 格式,追加到 AOF 缓冲区;
- 根据配置,使用
fsync系统调用刷盘,确保持久性; - 下次重启 Redis 时,加载 AOF 文件,回放命令。
刷盘策略
| 策略 | 行为 |
|---|---|
always |
每次命令都刷盘 |
everysec |
每秒一次刷盘 |
no |
操作系统自己决定何时刷盘 |
AOF 重写
随时间推移,AOF 文件会越来越大,因为包含很多重复、过期、无效的命令 —— 比如 set 了 1000 次,其实只保留最后一次就可以。
重写不是读旧的 AOF 文件,而是直接读取内存中的当前数据,用最少的命令重建数据。
优缺点
- 优点:数据丢失少(最多 1s);
- 缺点:恢复慢;文件大(记录了所有命令)。
3. 混合持久化
Redis 4.0 的持久化方式是:先将内存中的数据以 RDB 形式写入到 AOF 文件的开头,再将重写期间主线程发生的增量命令以 AOF 的格式追加到 RDB 数据后面。
- 优势:先加载 RDB,很快;再执行 AOF,保证数据完整性。
八、高可用
思路:单机——>主从 + 哨兵 + 集群(最重要)
1. 主从模式
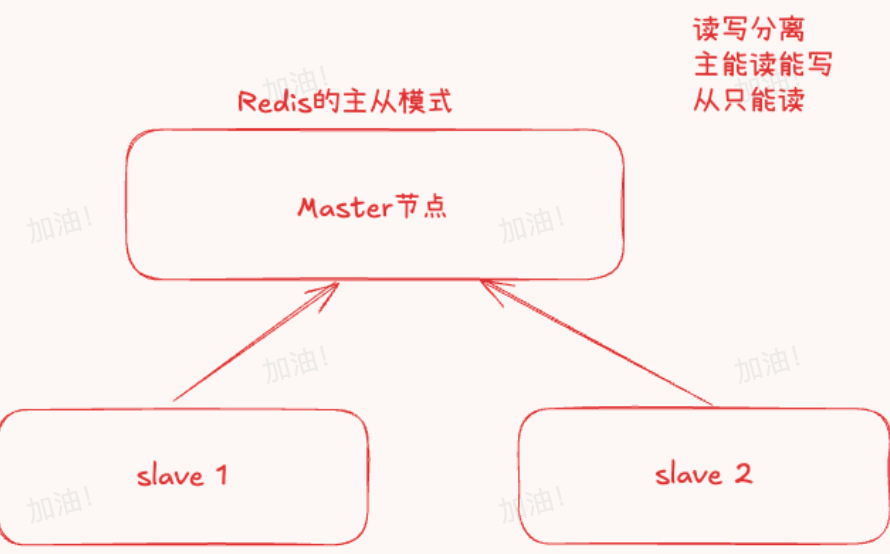
1 个 master + N 个 slave。
- 读写分离;
- master 宕机需要手动切换到 slave。
2. 哨兵模式
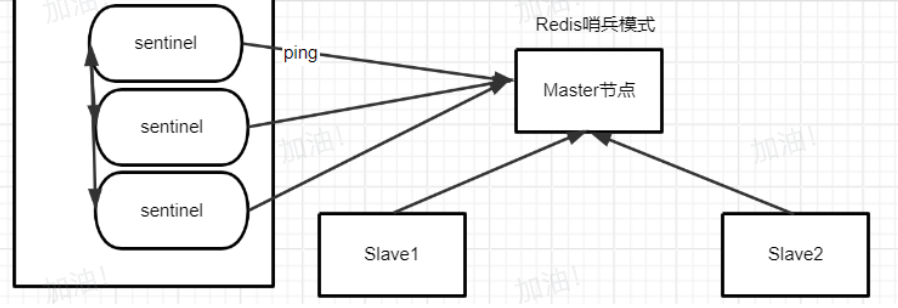
实现高可用。
会有奇数个哨兵发送 ping 命令监听 master 是否存活:
- 一个哨兵 ping 不通,认为 master 主观下线;
- 一半多哨兵 ping 不通,认为 master 客观下线;
- 此时会自动从 slave 中进行选举,选举出新的 master,实现自动的故障转移。
3. 集群模式
自己公司部署 Redis 服务的时候才需要考虑;用云厂商的 Redis 服务由他们维护。
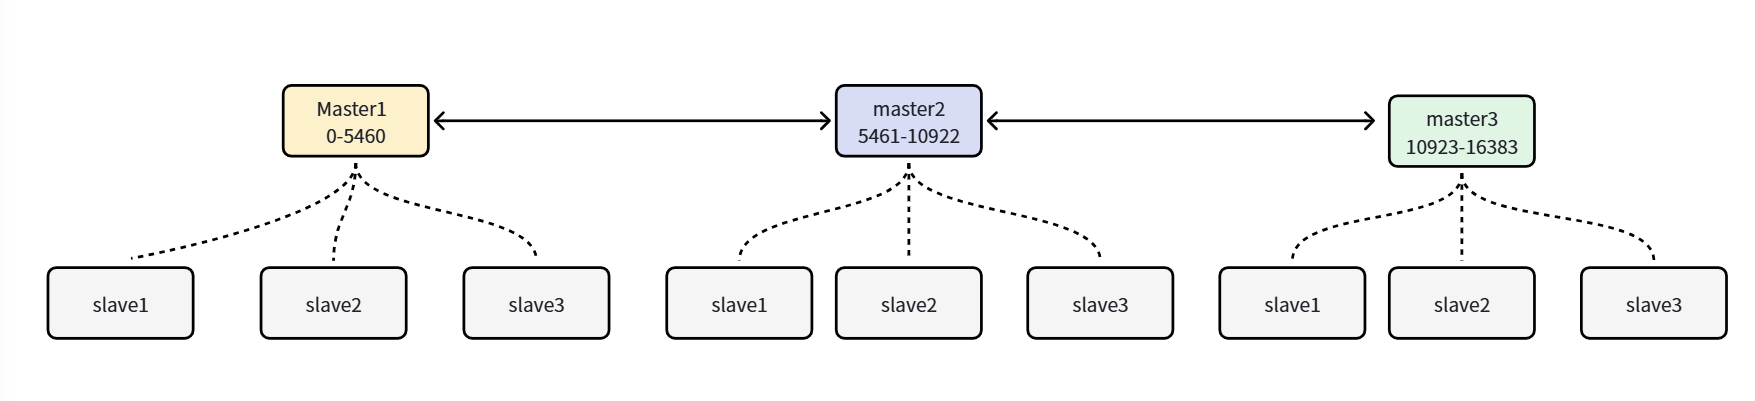
Redis Cluster:实现高可用 + 数据分片。
相关概念
槽位Slot,Redis Cluster 的数据分片单位,一共有 2¹⁴ = 16384 个槽,每个 Master 负责一部分槽位,默认平分,也可以配置文件手动指定。
槽位计算CRC16 算法:slot = CRC16(key) % 16384,取模。
HashTag:使用 HashTag 可以让多个 key 存储在同一个节点,实现同一条命令对多个 key 的事务和批量操作 —— 因为 Redis Cluster 不支持分布式事务,无法保证不同节点的事务。
优点
高可用 + 数据分片,实现水平扩展,解决单机瓶颈。
读写流程
写入流程- 客户端写入
key1=value1,连接任意节点(例如 Master1); - Master1 计算槽位
slot = CRC16("key1") % 16384 = 8888(哈希槽的索引数),并检查槽位归属:槽位 8888 属于 Master2; - 返回重定向信息(自动帮你连接到 Master2):
MOVED 8888 192.168.1.102:6379; - 客户端连接 Master2,执行写入
SET key1 value1; - Master2 同步给 Slave 从库。
读取流程与写入类似:
- 客户端连接任意节点;
- 节点根据 key 计算槽位;
- 如果槽位在本节点,直接返回数据;
- 如果槽位不在本节点,返回 MOVED 重定向;
- 客户端连接正确的节点读取数据。
故障转移
同哨兵模式,不同点:
- 没有专门的 sentinel,而是所有从节点都参与;
- 选举出新 master 后要更新槽位信息;如果原 master 恢复,也只能沦为从节点。
扩容缩容
核心:槽的迁移。
扩容流程- 启动新节点;
- 加入集群;
- 分配槽位(比如计算平均值,或者手动指定);
- 槽位迁移。
| 节点 | 原槽位 | 变化 | 结果 |
|---|---|---|---|
| Master1 | 5461 | −1365 | 4096 |
| Master2 | 5462 | −1366 | 4096 |
| Master3 | 5461 | −1365 | 4096 |
| Master4 | 0 | +4096 | 4096 |
- 添加从节点。
- 迁移槽位(比如计算平均值,或者手动指定);
- 删除从节点(如果有);
- 删除主节点;
- 关闭节点。
可以。
场景:槽位 1000 正在从 Master1 迁移到 Master4。
客户端请求 key1(在槽位 1000):
- 客户端连接 Master1;
- Master1 检查:key1 已经迁移;
- Master1 返回:
ASK 1000 Master4IP:6383; - 客户端先发送
ASKING(告诉 Master4 接受临时请求); - 客户端再发送
GET key1; - Master4 返回数据。
ASK vs MOVED:
- ASK:临时重定向,槽位迁移中,访问旧节点时返回 ASK;
- MOVED:永久重定向,槽位已经迁移完成,访问旧节点返回 MOVED。