串讲思路:MQ是什么 → 分类选型 → RocketMQ架构 → 持久化 → 消息类型 → 常见问题
一、什么是 MQ
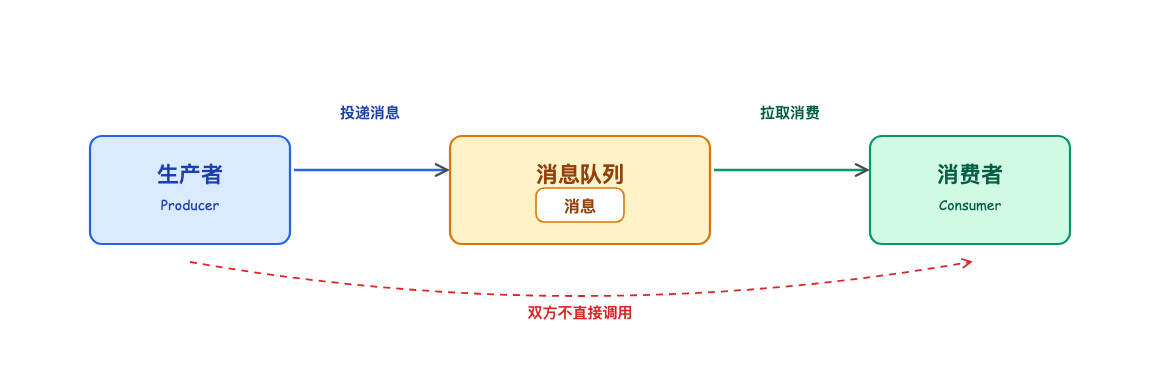
MQ(Message Queue)是应用之间的异步通信中间件:生产者把消息投进队列,消费者从队列里取出来处理,双方不需要直接调用。
1. 使用场景
- 异步:下单后要发短信、加积分、发优惠券。串行调用要等三个都返回,用 MQ 只需写入队列就返回,下游各自慢慢处理。
- 解耦:订单系统不再关心谁要消费订单事件。新增一个下游,订阅同一个 Topic 即可,订单系统一行代码不改。
- 削峰:秒杀瞬间 10 万 QPS 灌进来,下游只有 2000 的处理能力。消息先堆在 MQ,下游按自己的节奏消费。
- 数据分发:一条订单消息,库存、积分、风控、数据仓库各订阅一个消费者组,各拿一份互不影响。
2. 作用
| 作用 | 说清楚 |
|---|---|
| 异步解耦 | 生产者和消费者互不感知,下游只认消息不认接口 |
| 削峰填谷 | 洪峰进队列缓冲,下游按能力匀速消费,保护数据库 |
| 数据分发 | 一条消息多组各取所需,天然的一对多广播 |
| 最终一致性 | 事务消息保证「本地事务成功 ⇒ 消息一定发出去」 |
MQ 的价值是把「同步等待」换成「异步通知」,代价是引入了一致性、重复、积压这三个必须自己解决的问题(见第六章)。
二、分类
1. 模型分类
两种基本模型:
| 模型 | 语义 | 代表 |
|---|---|---|
| 队列模型 | 一条消息只被一个消费者消费,多个消费者竞争 | RabbitMQ 的普通队列 |
| 发布订阅 | 一条消息被所有订阅者各消费一次 | Kafka / RocketMQ 的 Topic |
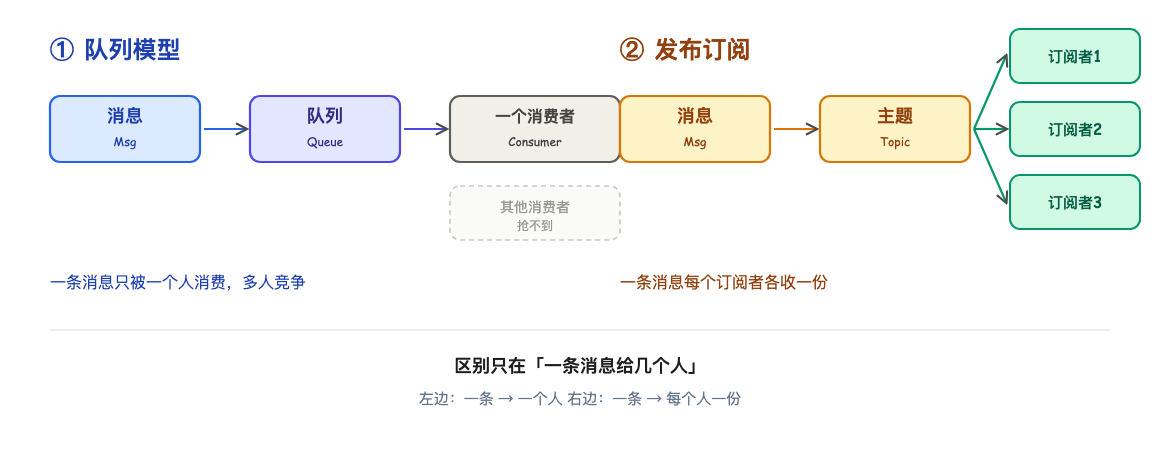
RocketMQ 的 ConsumerGroup 把两者合在一起:
组内可以选择队列模型或发布订阅对应集群消费(默认)和广播消费两种配置;
组间则是固定的发布订阅。
2. 产品分类
| 维度 | RabbitMQ | Kafka | RocketMQ |
|---|---|---|---|
| 语言/协议 | Erlang,AMQP | Scala/Java,自定义 | 纯 Java,自定义 |
| 延迟 | 微秒级,最低 | 毫秒级 | 毫秒级 |
| 吞吐 | 万级 | 十万级,最高 | 十万级 |
| 存储 | 内存优先,队列删即丢 | 每分区一个日志文件 | 混合:全部混写 CommitLog + 独立索引(见第四章) |
| 特色能力 | 路由灵活(direct/topic/fanout) | 流处理、数据回放 | 事务、顺序、延迟消息完备 |
| 适用 | 传统业务解耦、路由复杂 | 大数据管道、日志流 | 电商交易、需要事务/顺序的场景 |
要事务和顺序选 RocketMQ;
要吞吐和数据回放选 Kafka;
要复杂路由、生态成熟选 RabbitMQ。
三、RocketMQ 的架构
思路:物理架构(机器上有什么)→ 逻辑架构(业务怎么用)→ 两者交汇 → 一条消息怎么流转
1. 物理架构
| 组件 | 职责 | 关键点 |
|---|---|---|
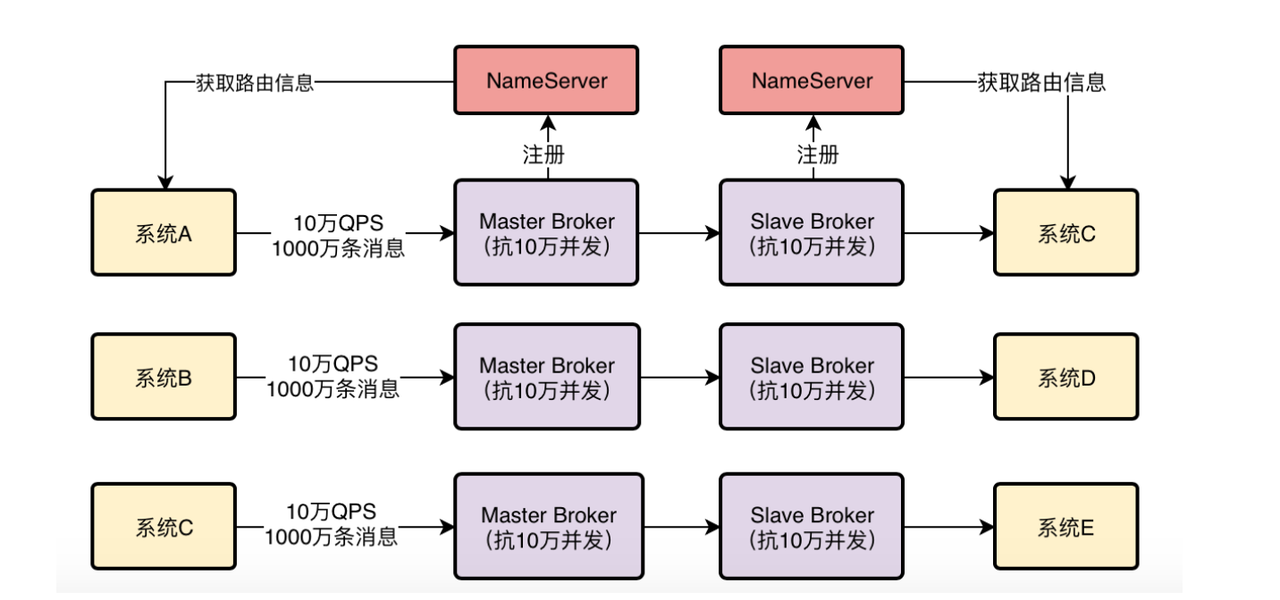
| NameServer | 注册中心,存 Topic → Broker 的路由 | 无状态、互不通信,部署多台即可高可用 |
| Broker | 存储与转发消息 | 分 Master / Slave,消息只写 Master |
| Producer | 发送消息 | 从 NameServer 取路由,只投 Master |
| Consumer | 消费消息 | 从 NameServer 取路由,默认只拉 Master(Slave 仅作订阅异常时的兜底) |
心跳机制:Broker 每 30s 向所有 NameServer 发心跳;NameServer 每 10s 扫描一次;某 Broker 超过 120s 无心跳即判定下线。(CAP)
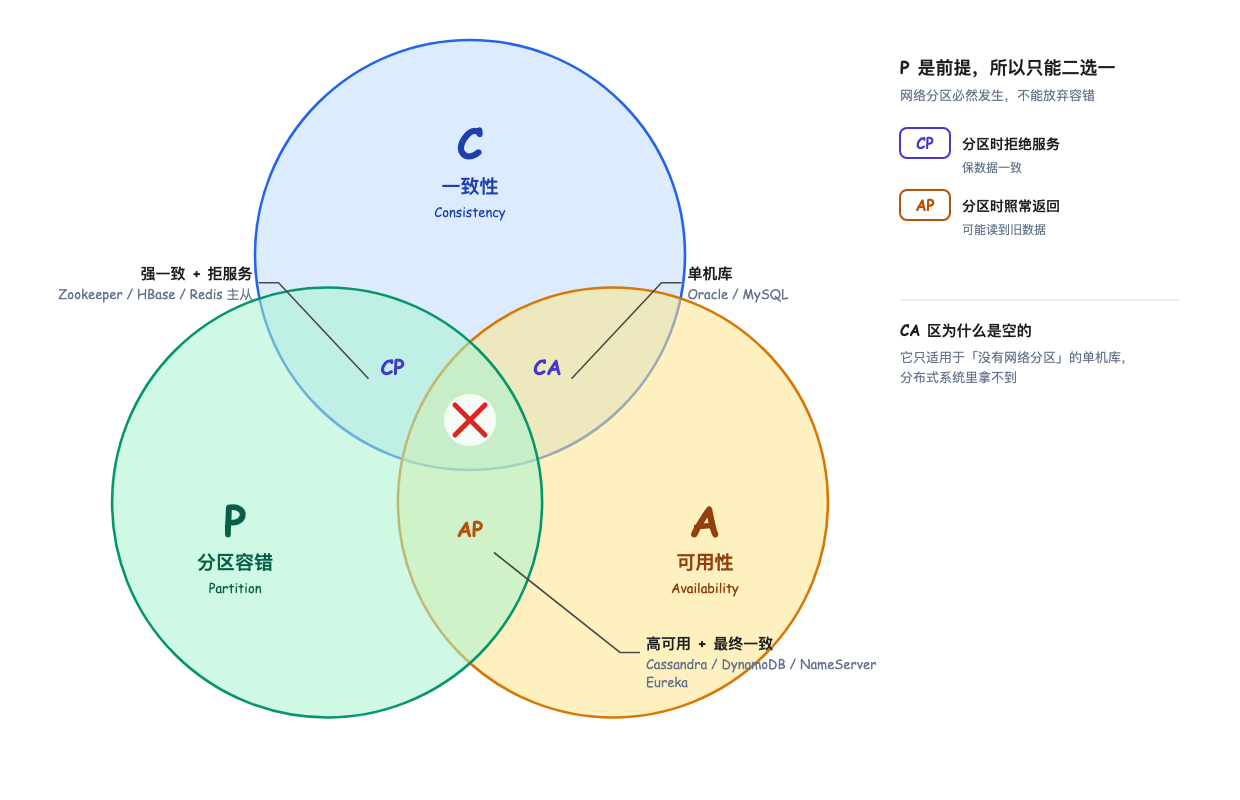
为什么不用 Zookeeper?ZK 是 CP,选举期间整个集群不可用,而注册中心应该优先保可用性(AP);且 NameServer 极轻量、可水平扩展,客户端还会缓存路由,NameServer 全挂短时间内也不影响发送。
CAP理论
2. 逻辑架构
| 概念 | 说明 |
|---|---|
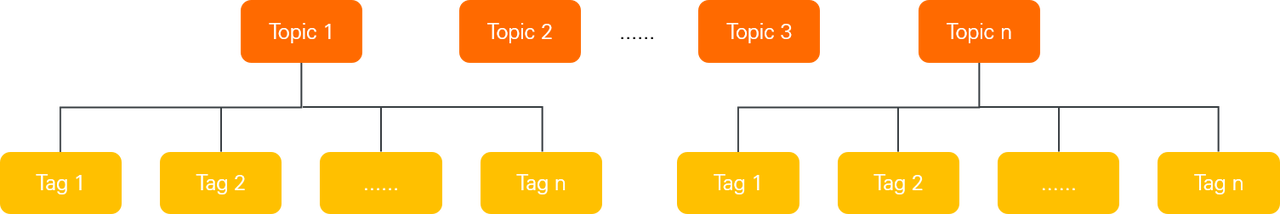
| Topic | 消息的业务分类(订单 Topic、短信 Topic),一级分类 |
| MessageQueue | Topic 的分片,一个 Topic 有多个 Queue,按照一定的路由规则分散在不同 Broker |
| Tag | Topic 内的二级分类,用于过滤,不是隔离;比如 订单_鲜花、订单_家电 |
| Key | 业务唯一标识,用于查询和去重 |
| ConsumerGroup | 一组消费逻辑相同的实例,组内竞争、组间广播 |
| Offset | 消费进度,按 (Group, Topic, Queue) 独立记账 |
// 生产端
rocketTemplate.asyncSend("OrderTopic:TAG_JD",      // Topic:主题,决定路由到哪些 Queue
    MessageBuilder.withPayload(orderDTO)           // Tag:消息的二级标签(冒号后)
        .setKeys("orderId_12345")                  // Key:消息的业务唯一标识
        .build(),
    callback);                                     // 回调收结果,不阻塞主线程

// 消费端
@RocketMQMessageListener(
    topic              = "OrderTopic",            // ← 队列级:订阅一个 Topic
    selectorExpression = "TAG_JD || TAG_TMALL",   // ← 消息级:按 Tag 过滤消息
    consumerGroup      = "order-consumer-group"    // ← 消费者组
)
public class OrderConsumer implements RocketMQListener<MessageExt> {
    public void onMessage(MessageExt msg) {
        String tag = msg.getTags();   // Tag 挂在每条消息上,不是队列属性
        String key = msg.getKeys();
    }
}
3. 物理与逻辑的交汇
这是最容易搞混的地方:Queue 是逻辑分片,落地在物理 Broker 上。
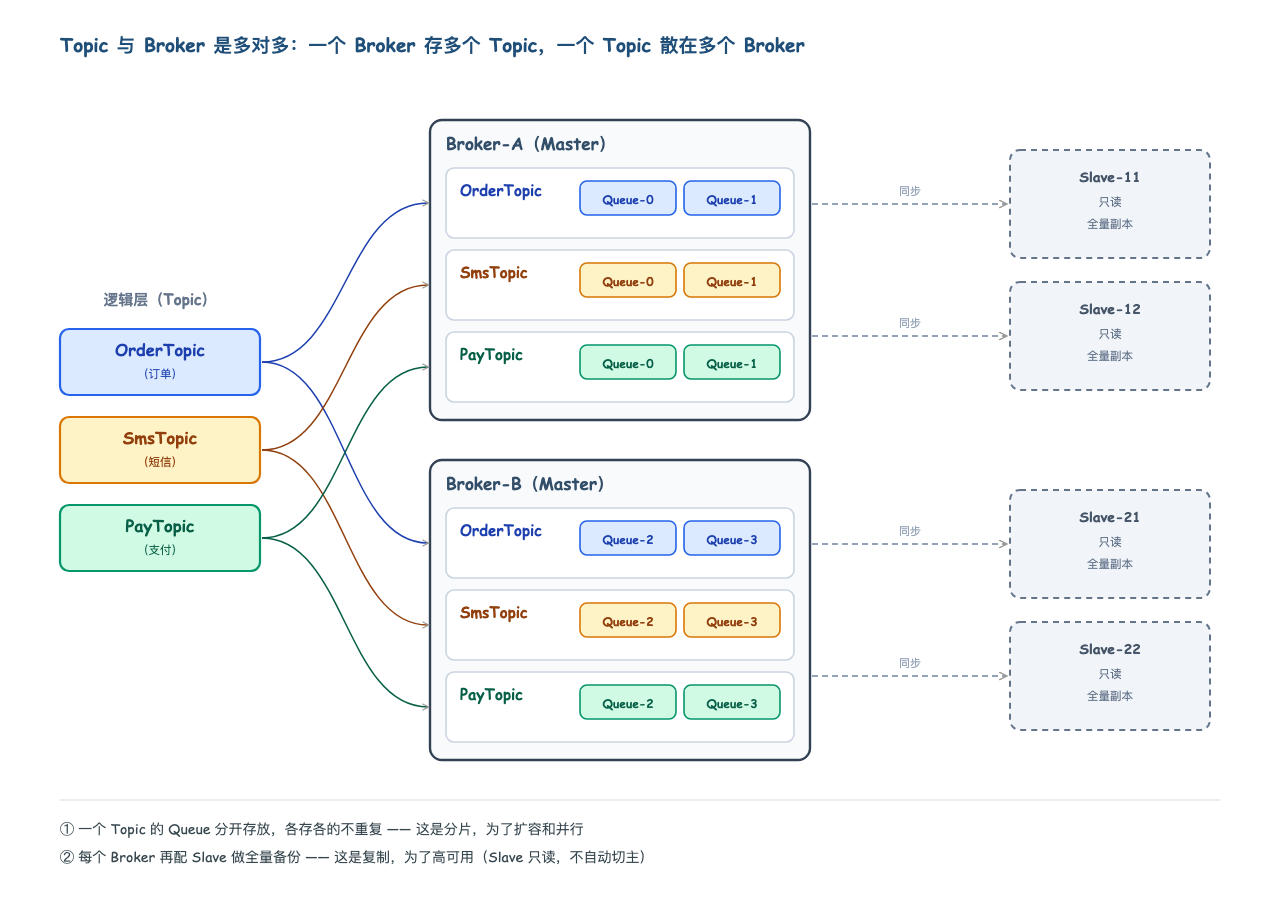
消费分配是按 Queue 分的,根本不看 Queue 在哪台 Broker 上,配置好物理上会自动根据Queue找到对应的Broker。
- 消费层:
Group → 分 → Consumer → 拉 → Queue - 存储层:
Broker ← 装 → Queue
所以 Queue 数 = 单个消费组的并行度天花板。
一个组内 4 个 Queue 最多养 4 个有效消费者,第 5 个能启动但分不到 Queue,只会空转(同一个 Queue 同一时刻只能被组内一个消费者持有,否则 Offset 记账和顺序都会乱)。
注意这是组内上限,不是 Topic 上限——不同消费组之间互不抢占,各自独立 Offset(组间广播),有 N 个组就有 4N 个消费者在干活。
4. 主从与高可用
| 维度 | 怎么保证 |
|---|---|
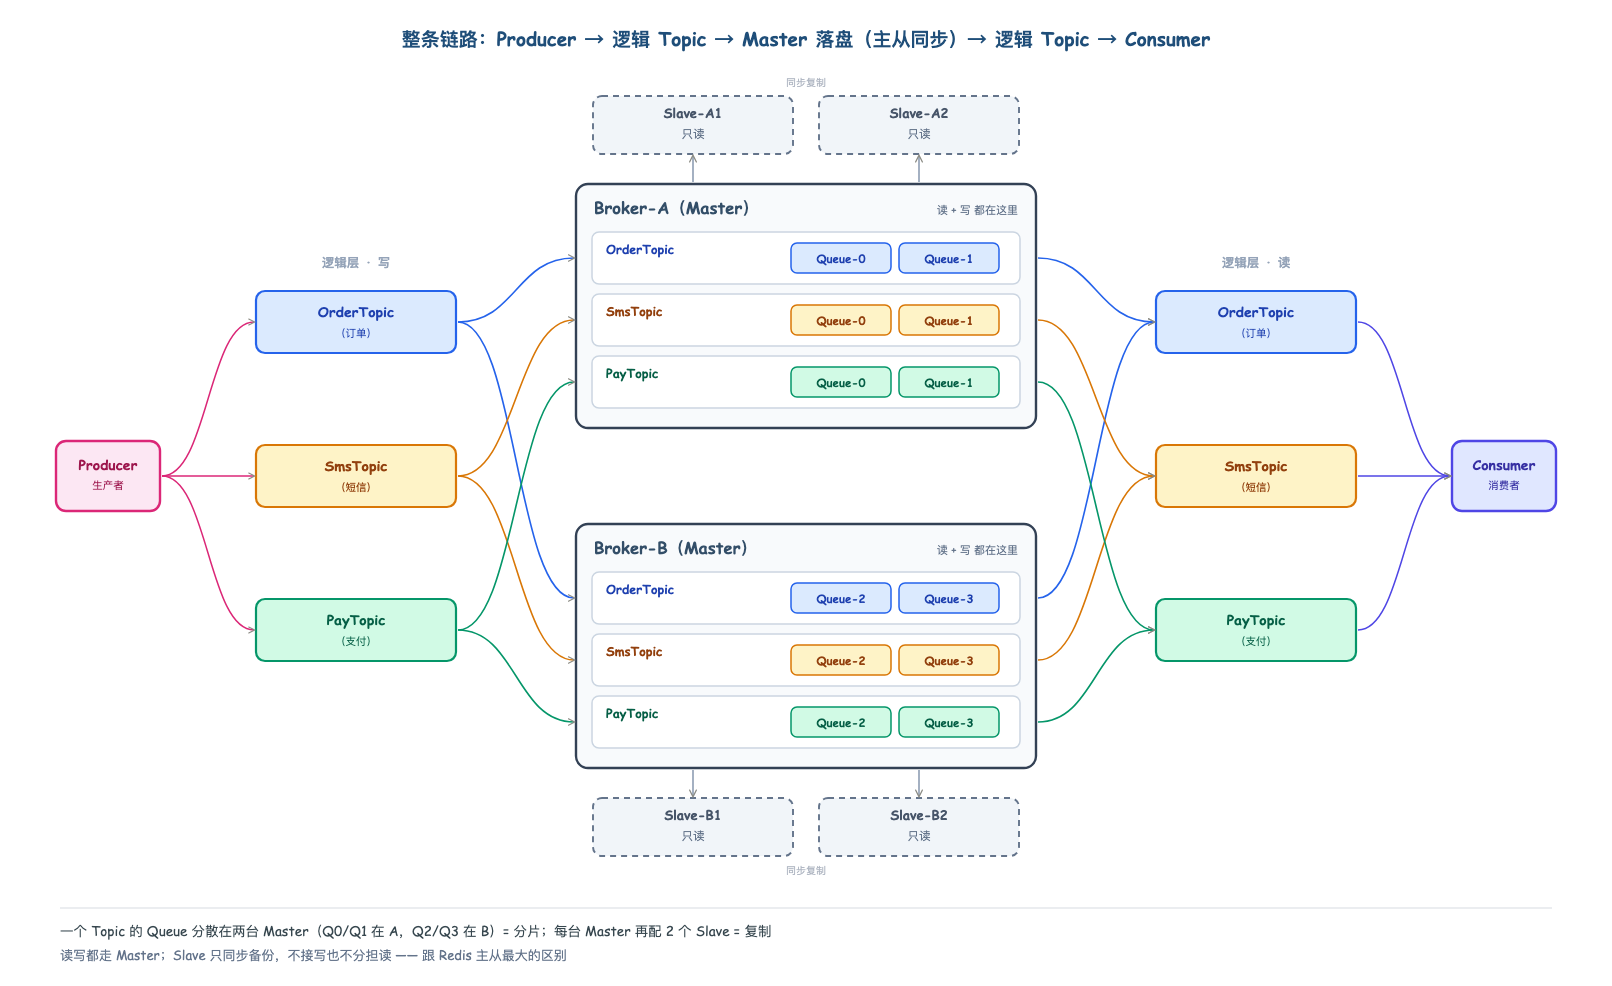
| 读写都在 Master | Topic 的 Queue 分片落在多台 Master 上,生产写入、消费拉取都走 Master |
| 写高可用 | 建 Topic 时把 Queue 分散到多个 Broker 组,某组 Master 挂了,其他组仍可写 |
| 存储不丢 | Master 同步/异步复制给 Slave,Master 宕机消息仍在 Slave 上 |
主从切换:4.5 之前 Slave 无法自动转 Master,需手工改配置重启;4.5 之后支持 Dledger + Raft 协议自动选举,一个 Master 可对多个 Slave,Master 挂了几秒内选出新 Master。
5. 消息流转
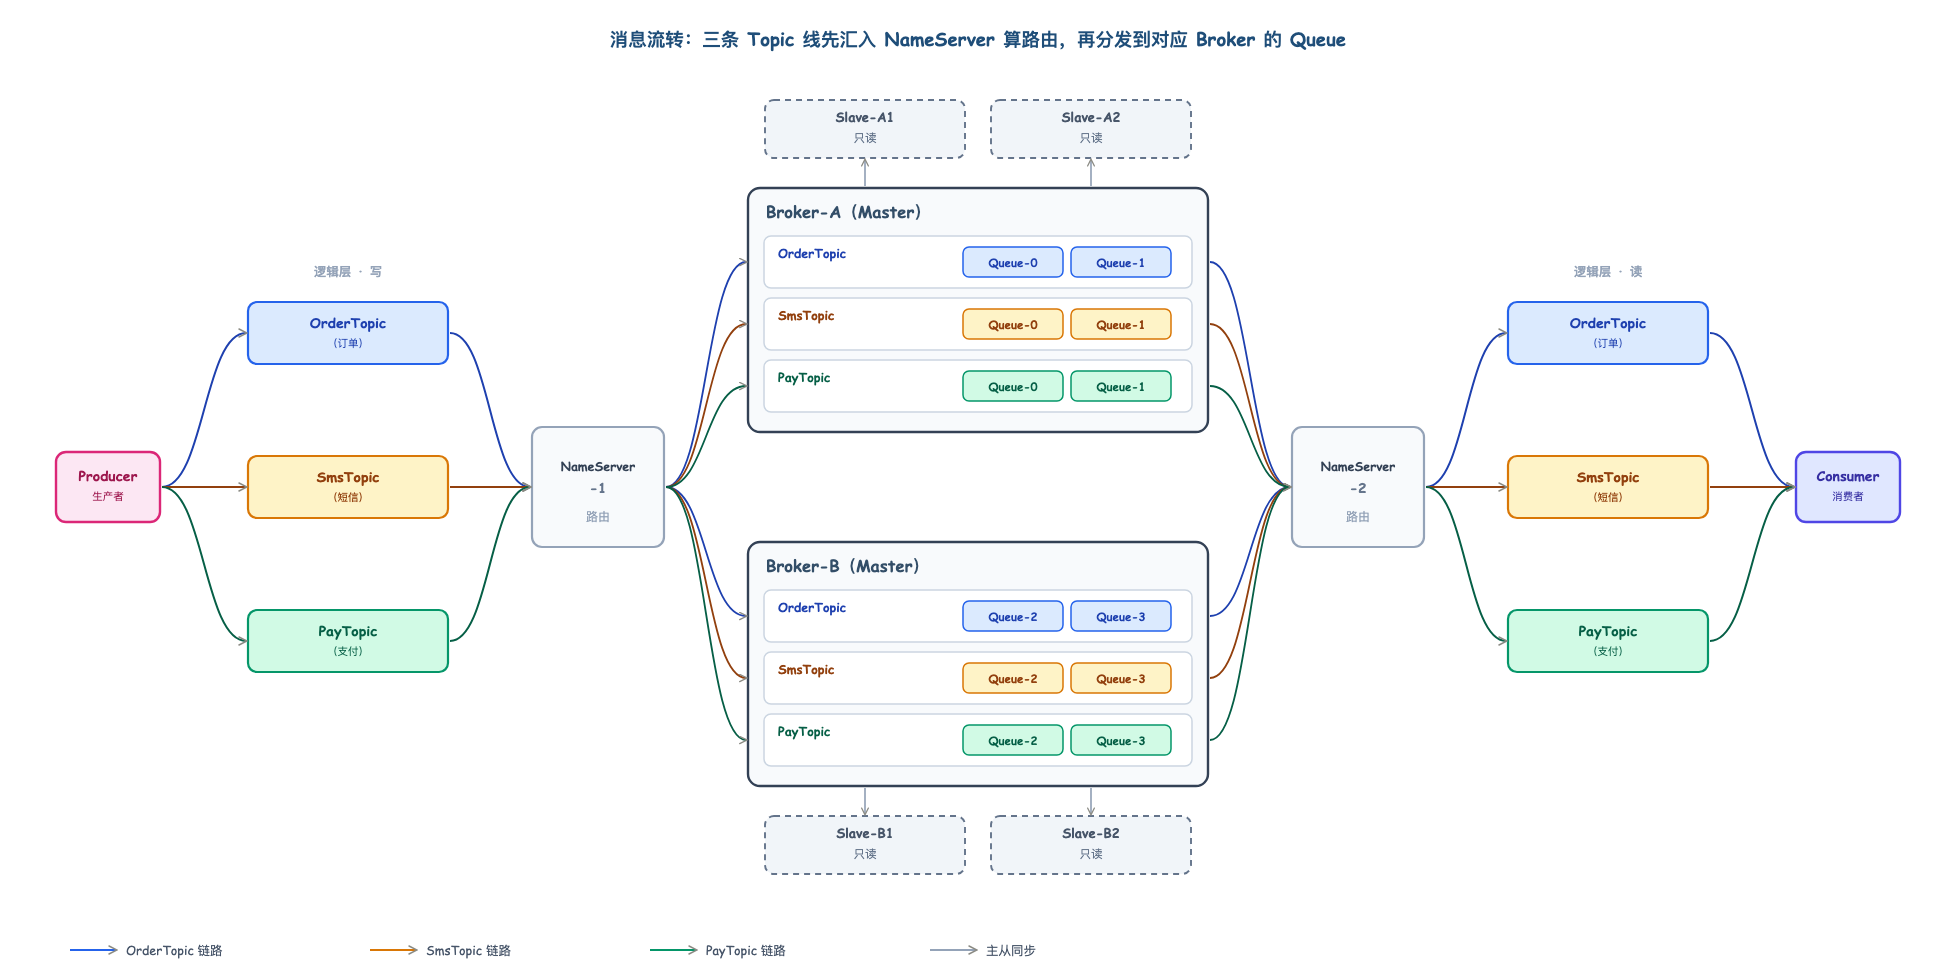
消息流转的顺序:
- Broker 启动 → 向所有 NameServer 注册,保持长连接,每 30s 心跳
- Producer 发消息 → 从 NameServer 取路由 → 按负载均衡算法选一台 Broker → 选一个 Queue → 发往 Master
- Broker 落盘 → 写入 CommitLog(详见第四章)→ 同步给 Slave
- 建索引 → 后台 ReputMessageService 异步构建 ConsumeQueue 和 IndexFile
- Consumer 拉取 → 从 NameServer 取路由 → 向 Broker 发拉取请求;没有消息时 Broker 挂起请求(长轮询),最多等 30s,期间来新消息立即返回
- 消费并 ACK → 业务处理完成后提交 Offset,失败则触发重试
四、持久化
1. 三个文件:CommitLog + 两个索引
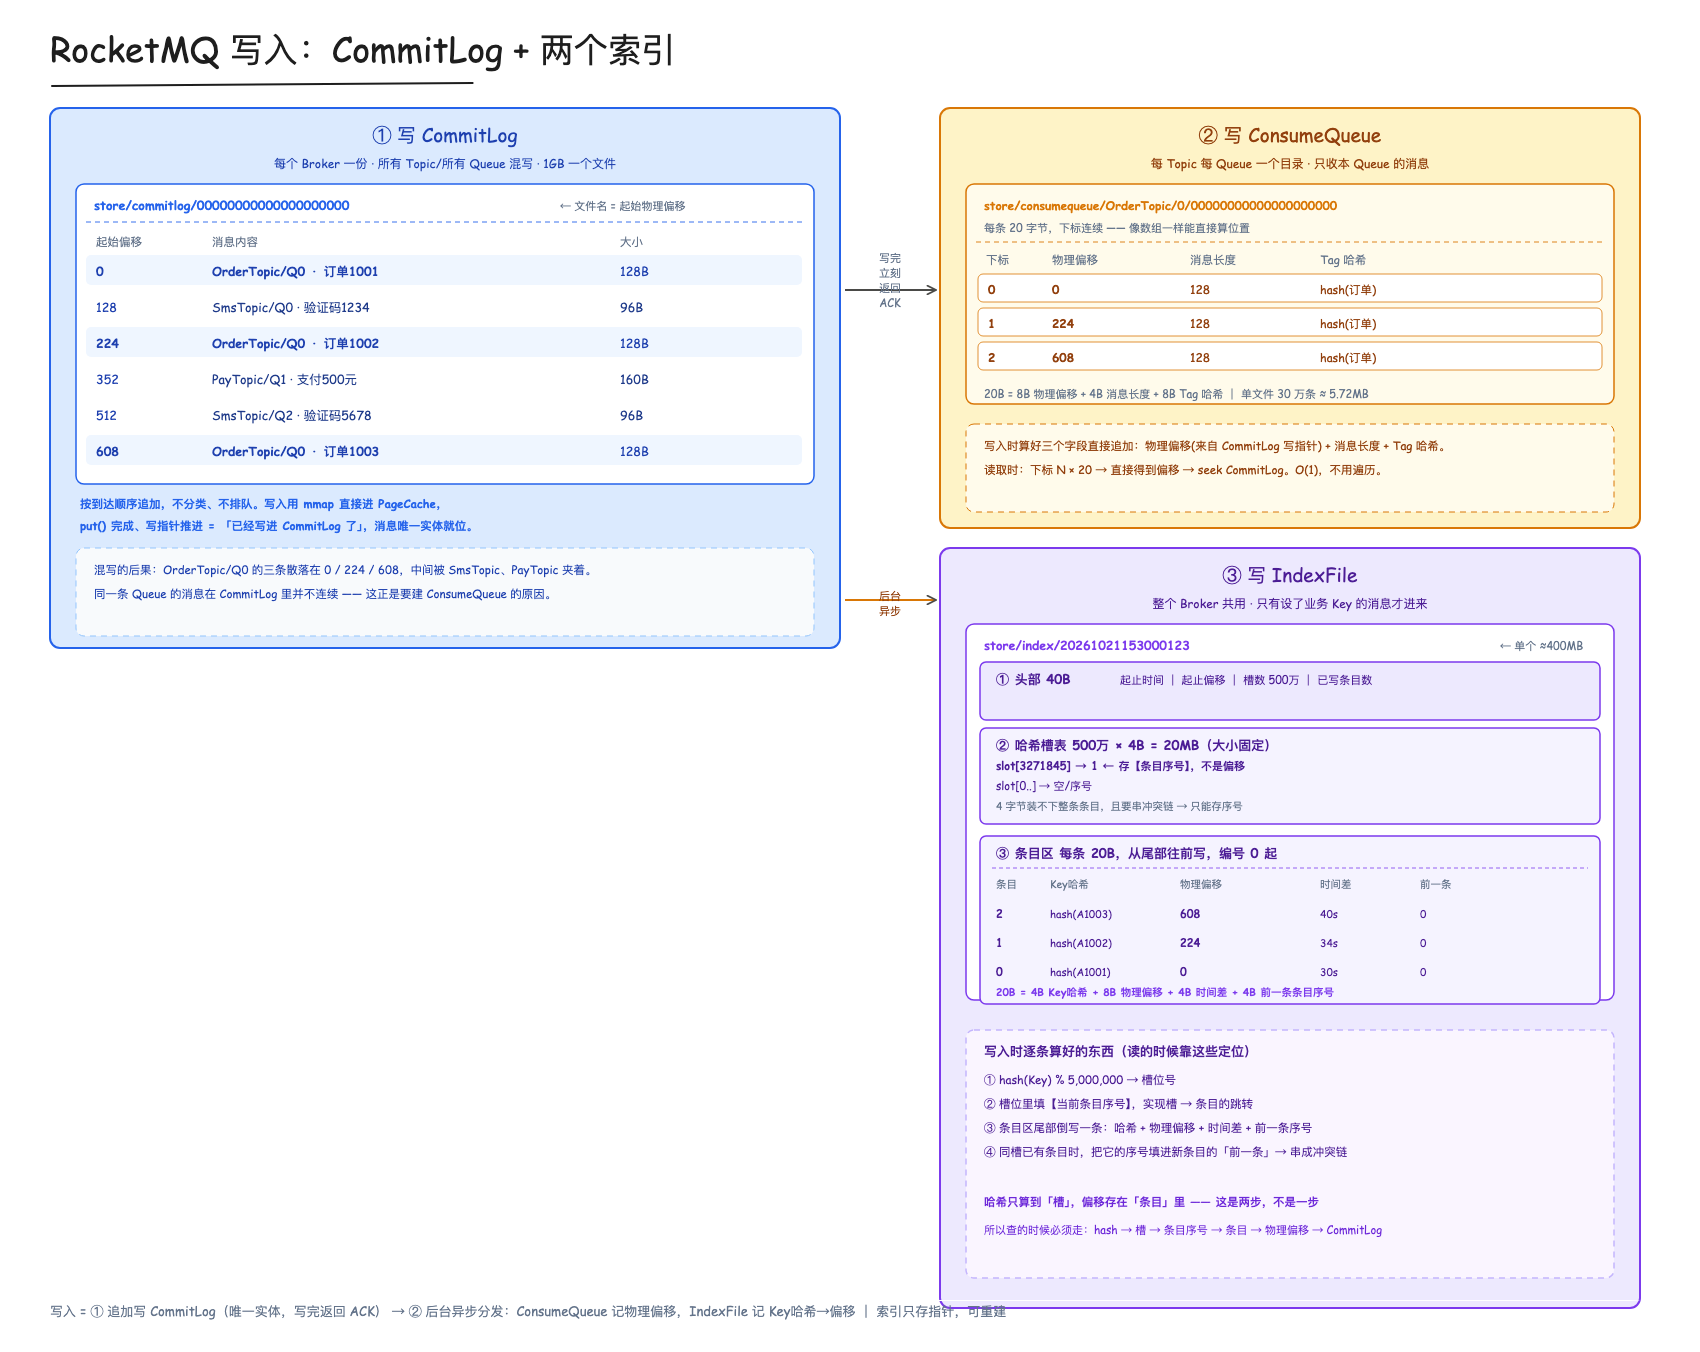
RocketMQ 的存储由三部分组成:一份 CommitLog 和两个索引文件。
| 文件 | 数量 | 存什么 | 作用 |
|---|---|---|---|
| CommitLog | 每个 Broker 一份,所有 Topic/Queue 混写 | 消息本体 | 唯一存储实体,消息只存这一份 |
| ConsumeQueue | 每 Topic 每 Queue 一个目录 | 20 字节指针 | 按顺序消费时 O(1) 定位 |
| IndexFile | 整个 Broker 共用 | Key 哈希 + 指针 | 按业务 Key 反查 |
CommitLog 默认 1GB 一个文件,写满新建下一个;文件名是 20 位数字,就是该文件的起始物理偏移(00000000000000000000 → 00000000001073741824)。
两个索引都只存指针不存内容,删掉可以从 CommitLog 完整重建。
2. 写入
假设 Broker 先后收到这 6 条:
| 次 | Topic | QueueId | 内容 | Tag | Key |
|---|---|---|---|---|---|
| 1 | OrderTopic | 0 | 订单1001 | 订单 | A1001 |
| 2 | SmsTopic | 0 | 验证码1234 | 验证 | — |
| 3 | OrderTopic | 0 | 订单1002 | 订单 | A1002 |
| 4 | PayTopic | 1 | 支付500元 | 支付 | — |
| 5 | SmsTopic | 2 | 验证码5678 | 验证 | — |
| 6 | OrderTopic | 0 | 订单1003 | 订单 | A1003 |
① 写 CommitLog:追加到写指针位置——不排队、不分类。写成什么样:
| 起始偏移 | 消息 | 大小 |
|---|---|---|
| 0 | OrderTopic/Q0 订单1001 | 128B |
| 128 | SmsTopic/Q0 验证码1234 | 96B |
| 224 | OrderTopic/Q0 订单1002 | 128B |
| 352 | PayTopic/Q1 支付500元 | 160B |
| 512 | SmsTopic/Q2 验证码5678 | 96B |
| 608 | OrderTopic/Q0 订单1003 | 128B |
三个 Topic 混在一起,OrderTopic/Q0 的三条散落在 0 / 224 / 608,中间被别人的消息夹着。
写入用 mmap 直接写进文件的 PageCache——put() 完成、写指针推进,这一步就叫「已经写进 CommitLog 了」。
② 建索引:后台线程 ReputMessageService 追着 CommitLog 新内容分发到两个索引。
store/consumequeue/OrderTopic/0/ —— 只有本 Queue 的,3 条 × 20 字节:
| 下标 | 物理偏移 | 长度 | Tag 哈希 |
|---|---|---|---|
| 0 | 0 | 128 | hash(订单) |
| 1 | 224 | 128 | hash(订单) |
| 2 | 608 | 128 | hash(订单) |
每条 20B = 8B 偏移 + 4B 长度 + 8B Tag 哈希,单文件 30 万条约 5.72MB。
store/index/ —— 整个 Broker 共用,只有设了 Key 的才进来:
| 条目 | Key 哈希 | 物理偏移 | 时间差 |
|---|---|---|---|
| 0 | hash(A1001) | 0 | 30s |
| 1 | hash(A1002) | 224 | 34s |
| 2 | hash(A1003) | 608 | 40s |
文件 = 头部 40B + 槽表(500 万 × 4B = 20MB)+ 条目区(每条 20B,从尾部往前写)。存 Key 的哈希不存原文,也没有 MessageId。
建索引不阻塞 ACK——索引负责「找得快」,CommitLog 才是消息本身。
3. 读取
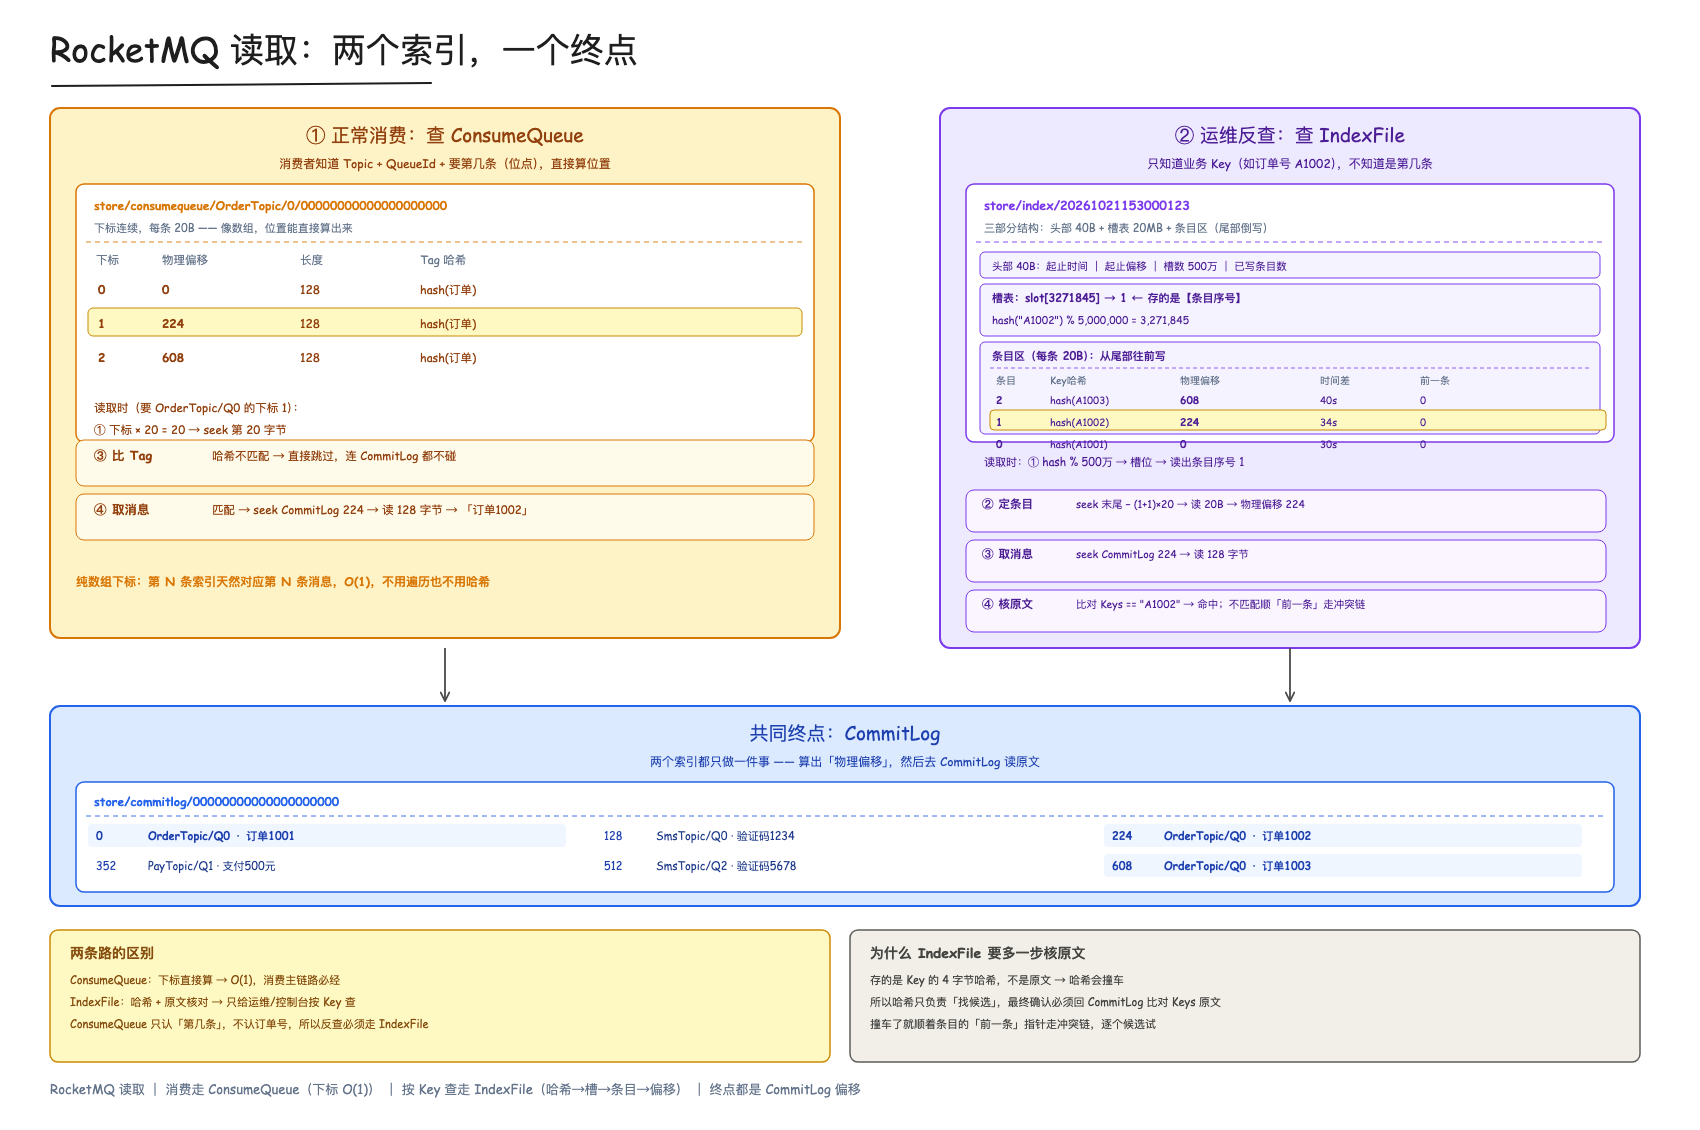
正常消费(主链路)走 ConsumeQueue:报 Topic + QueueId + 位点 N → N × 20 读出 (物理偏移, 长度, Tag 哈希) → Tag 不匹配就跳过 → 匹配则 seek CommitLog 读消息。纯数组下标,O(1)。
运维按 Key 反查走 IndexFile:hash(Key) % 500万 → 槽位 → 条目 → 比对哈希(撞车顺冲突链)→ seek CommitLog → 核对 Keys 原文才算命中。ConsumeQueue 只认「第几条」,不认订单号,所以这条路只能走 IndexFile。
两条路的终点完全一样:物理偏移 → CommitLog。 索引里的指针都指向它,消息原文只存在它里面。
五、消息类型
1. 总览
| 类型 | 语义 | 关键约束 |
|---|---|---|
| 普通消息 | 并发消费,无序 | 吞吐最高 |
| 顺序消息 | 按发送顺序消费 | 同 Key 同 Queue + 顺序监听器 |
| 延迟消息 | 指定时间后才投递 | 4.x 只有 18 个固定等级 |
| 事务消息 | 保证本地事务与发消息原子 | 半消息 + 回查 |
| 单向消息 | 只发不问结果 | 不可靠,用于日志 |
| 批量消息 | 一次发多条 | 同一 Topic,总量有限制 |
发送方式(跟类型是两回事):同步发送(等 ACK,可靠)、异步发送(不等,回调里处理)、单向发送(不管结果)。可靠性要求高的用同步或事务消息,单向发送无法保证可靠性。
2. 顺序消息
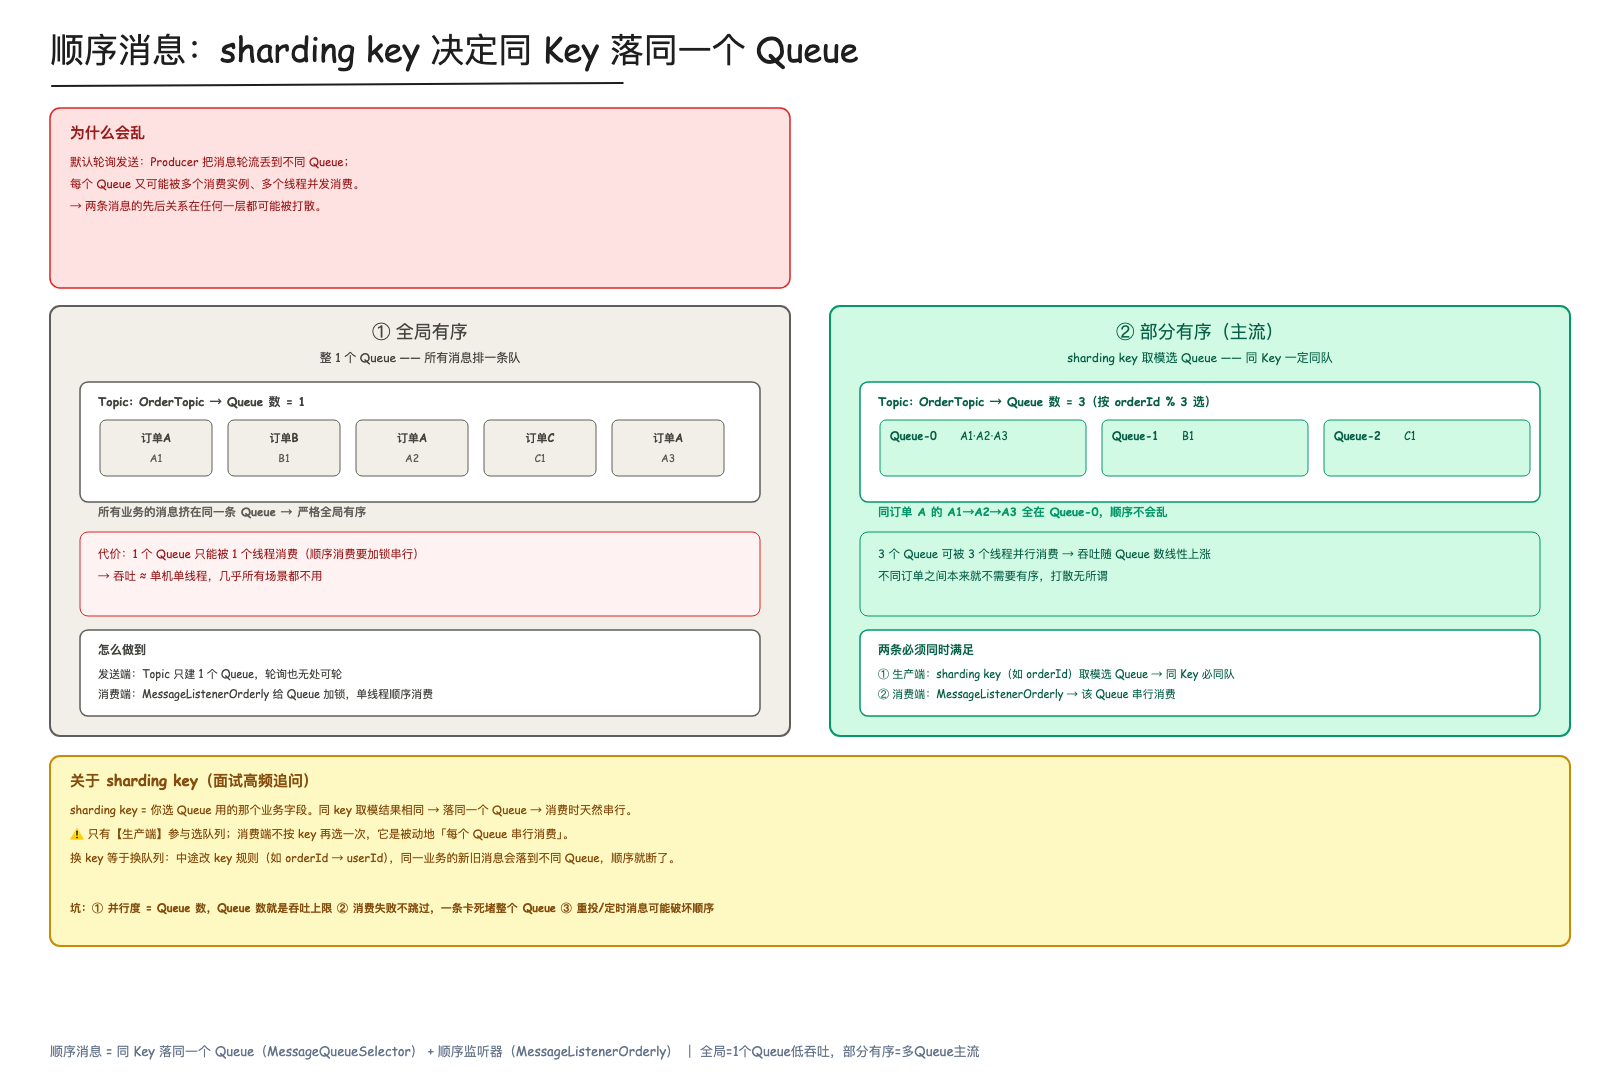
为什么会乱:默认轮询把消息发到不同 Queue,而每个 Queue 可能被不同实例、不同线程消费。
怎么保证:两件事必须同时做。
| 端 | 要求 |
|---|---|
| 发送端 | 用 MessageQueueSelector 按业务 Key(如订单 ID)选 Queue,保证同 Key 落同一个 Queue |
| 消费端 | 必须用 MessageListenerOrderly,并发监听器会打乱顺序 |
两种粒度:
| 全局有序 | 部分有序(主流) | |
|---|---|---|
| Queue 数 | 只能 1 个 | 多个 |
| 并行度 | 极低 | 高 |
| 场景 | 几乎不用 | 同订单的消息有序即可 |
代价与坑:
- 顺序消费靠给 Queue 加锁,同队列串行,牺牲并行度
- 消费失败不跳过——会不断重试这一条,堵住整个 Queue
3. 延迟消息
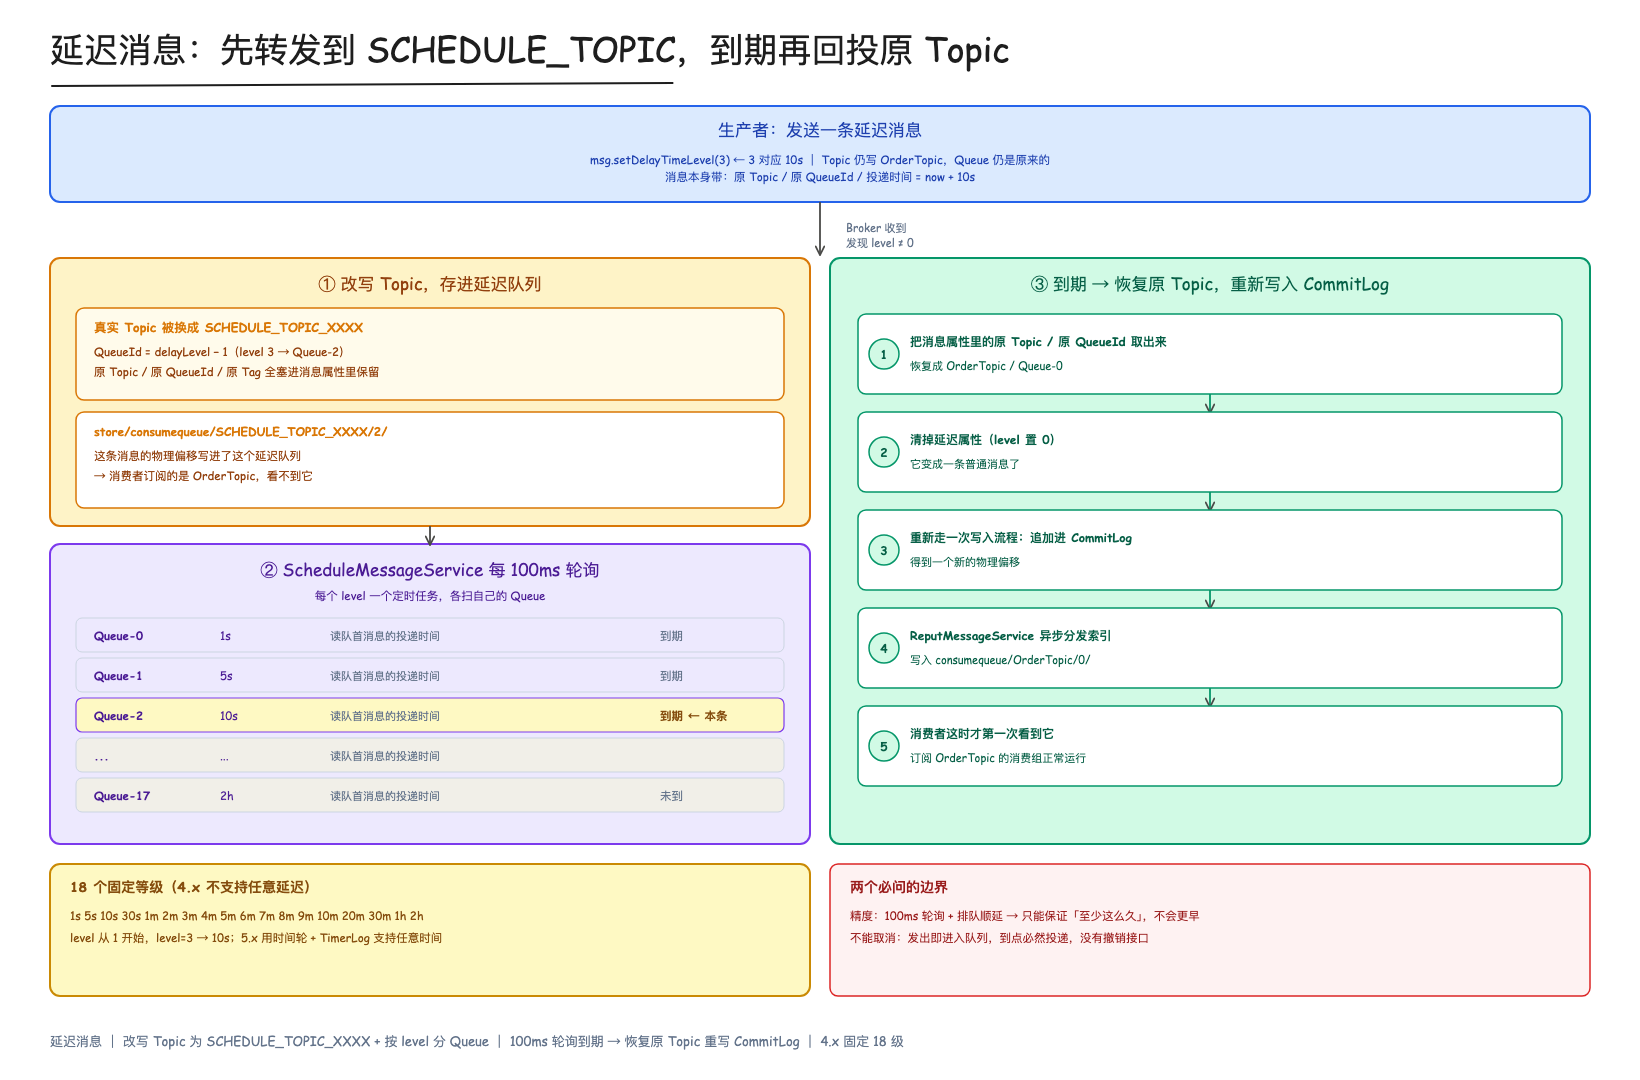
本质:消息先不投给消费者,由 Broker 暂存,到期再投。
4.x 的实现:
发延迟消息(level=3 → 10s)
 ① 改写 Topic 为 SCHEDULE_TOPIC_XXXX,按 level 分 Queue,
    原 Topic/Queue 存进消息属性
 ② Broker 内 ScheduleMessageService 每隔 100ms 扫描各延迟队列
 ③ 到期 → 恢复原 Topic/Queue → 重新写入 CommitLog
 ④ 消费者此时才能正常消费
| 要点 | 说明 |
|---|---|
| 固定 18 个等级 | 1s 5s 10s 30s 1m 2m…10m 20m 30m 1h 2h,不支持任意延迟 |
| 5.x 改进 | TimerWheel 时间轮 + TimerLog,支持任意时间、精度更高 |
| 精度 | 100ms 轮询 + 排队顺延,只能保证「至少这么久」 |
| 不能取消 | 发出即到点投递,无撤销 |
四个关键词:18 个固定等级 / SCHEDULE_TOPIC_XXXX / 100ms 轮询 / 5.x 时间轮。
4. 事务消息
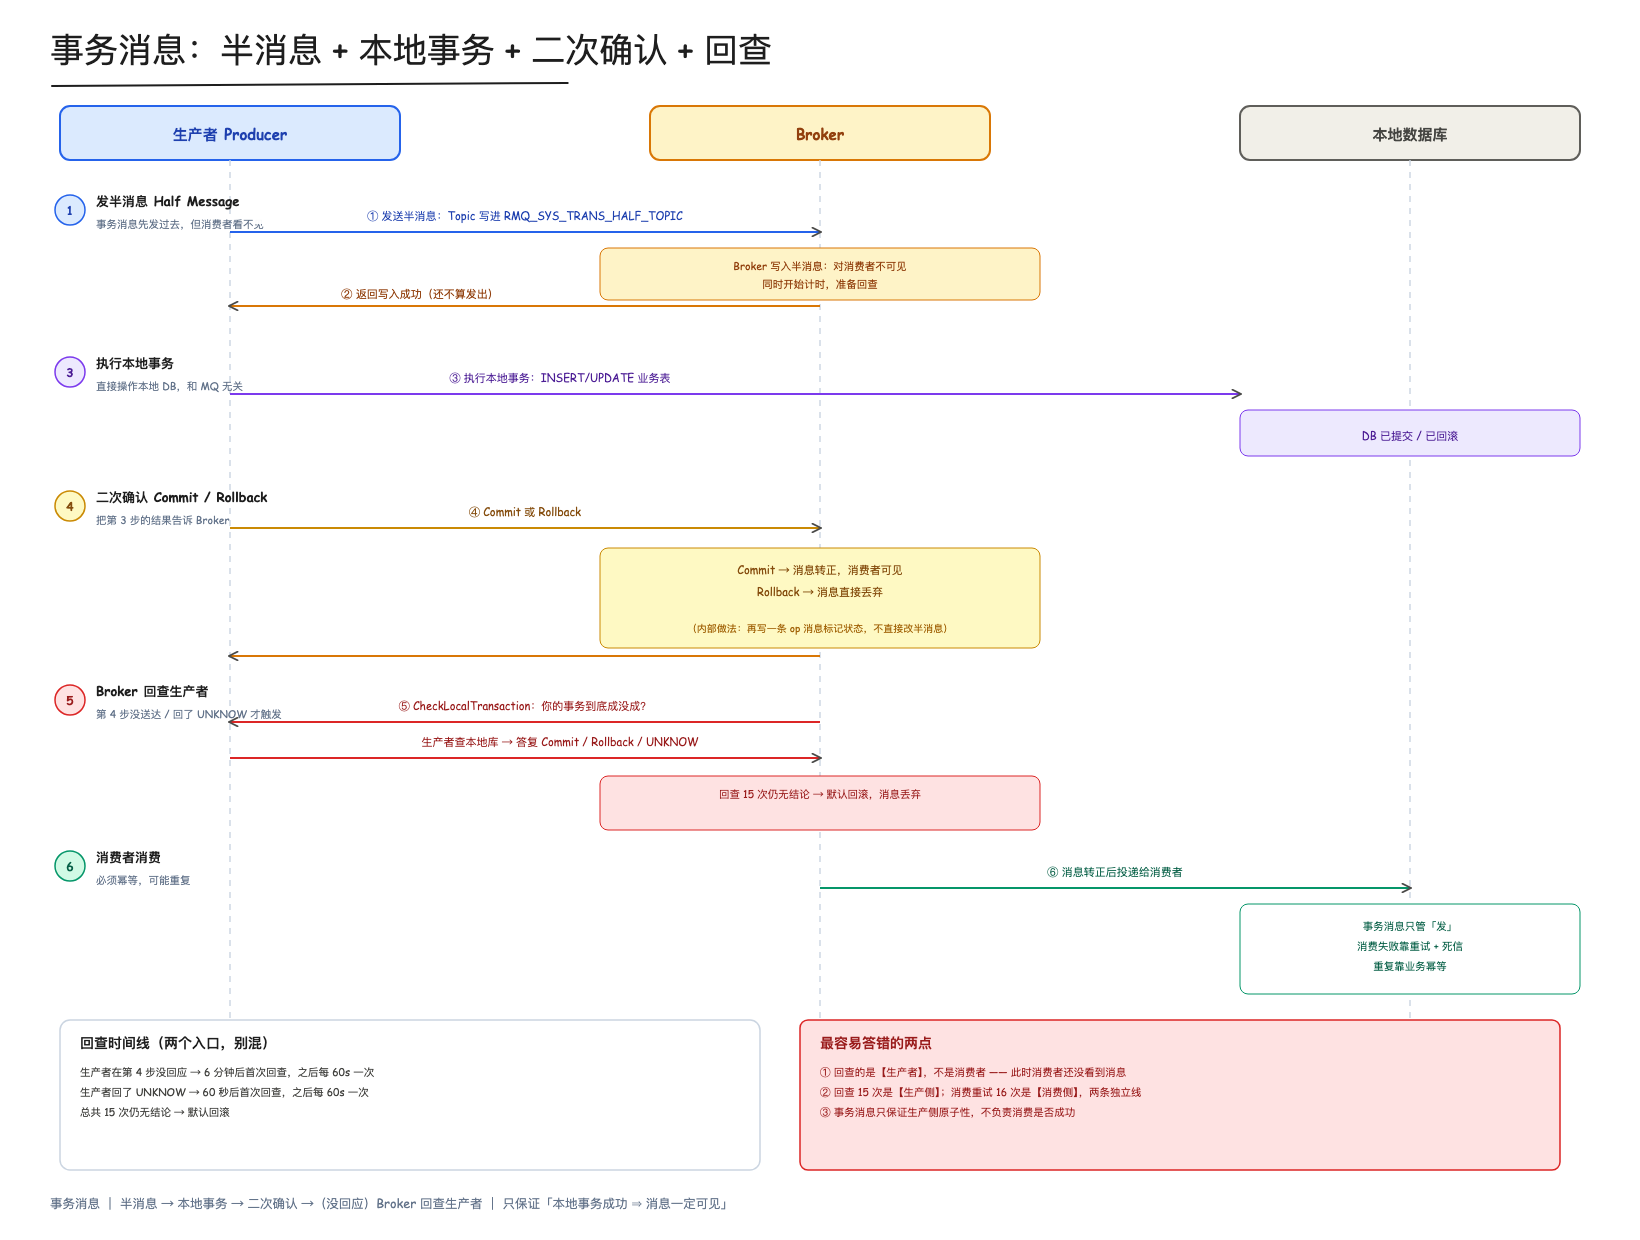
要解决什么:本地操作和发消息不在同一个事务里,无论谁先谁后,都可能一边成功一边失败。
三阶段 + 回查:
① 发半消息(Half Message)
   存内部 Topic RMQ_SYS_TRANS_HALF_TOPIC,对消费者不可见
② 执行本地事务(DB 操作)
③ 二次确认:
   成功 → Commit   → 消息转正,消费者可见
   失败 → Rollback → 消息丢弃
④ 若 ③ 没送达 → Broker 回查生产者(查本地库后答复 Commit/Rollback)
   回查 15 次仍无结论 → 默认回滚
回查时间:生产者无回应 → 6 分钟后首次回查,此后每 60s 一次;回应 UNKNOW → 60 秒后首次,每 60s 一次;总共 15 次。
边界(最容易被追问):
事务消息只保证生产侧原子性——「本地事务成功 ⇒ 消息一定发出且可见」,不负责消费者是否处理成功。
不丢不重的四段分工:事务消息管「发」,重试/死信管「收」,幂等管「重」,对账管「漏」。
两个易错点:
- 回查的是生产者,不是消费者——此时消费者还没看到消息
- 「回查 15 次」是生产侧,「消费重试 16 次」是消费侧,两条独立线
六、三大常见问题
思路:可靠(不丢)→ 幂等(不重)→ 积压(堆积)
1. 消息可靠性
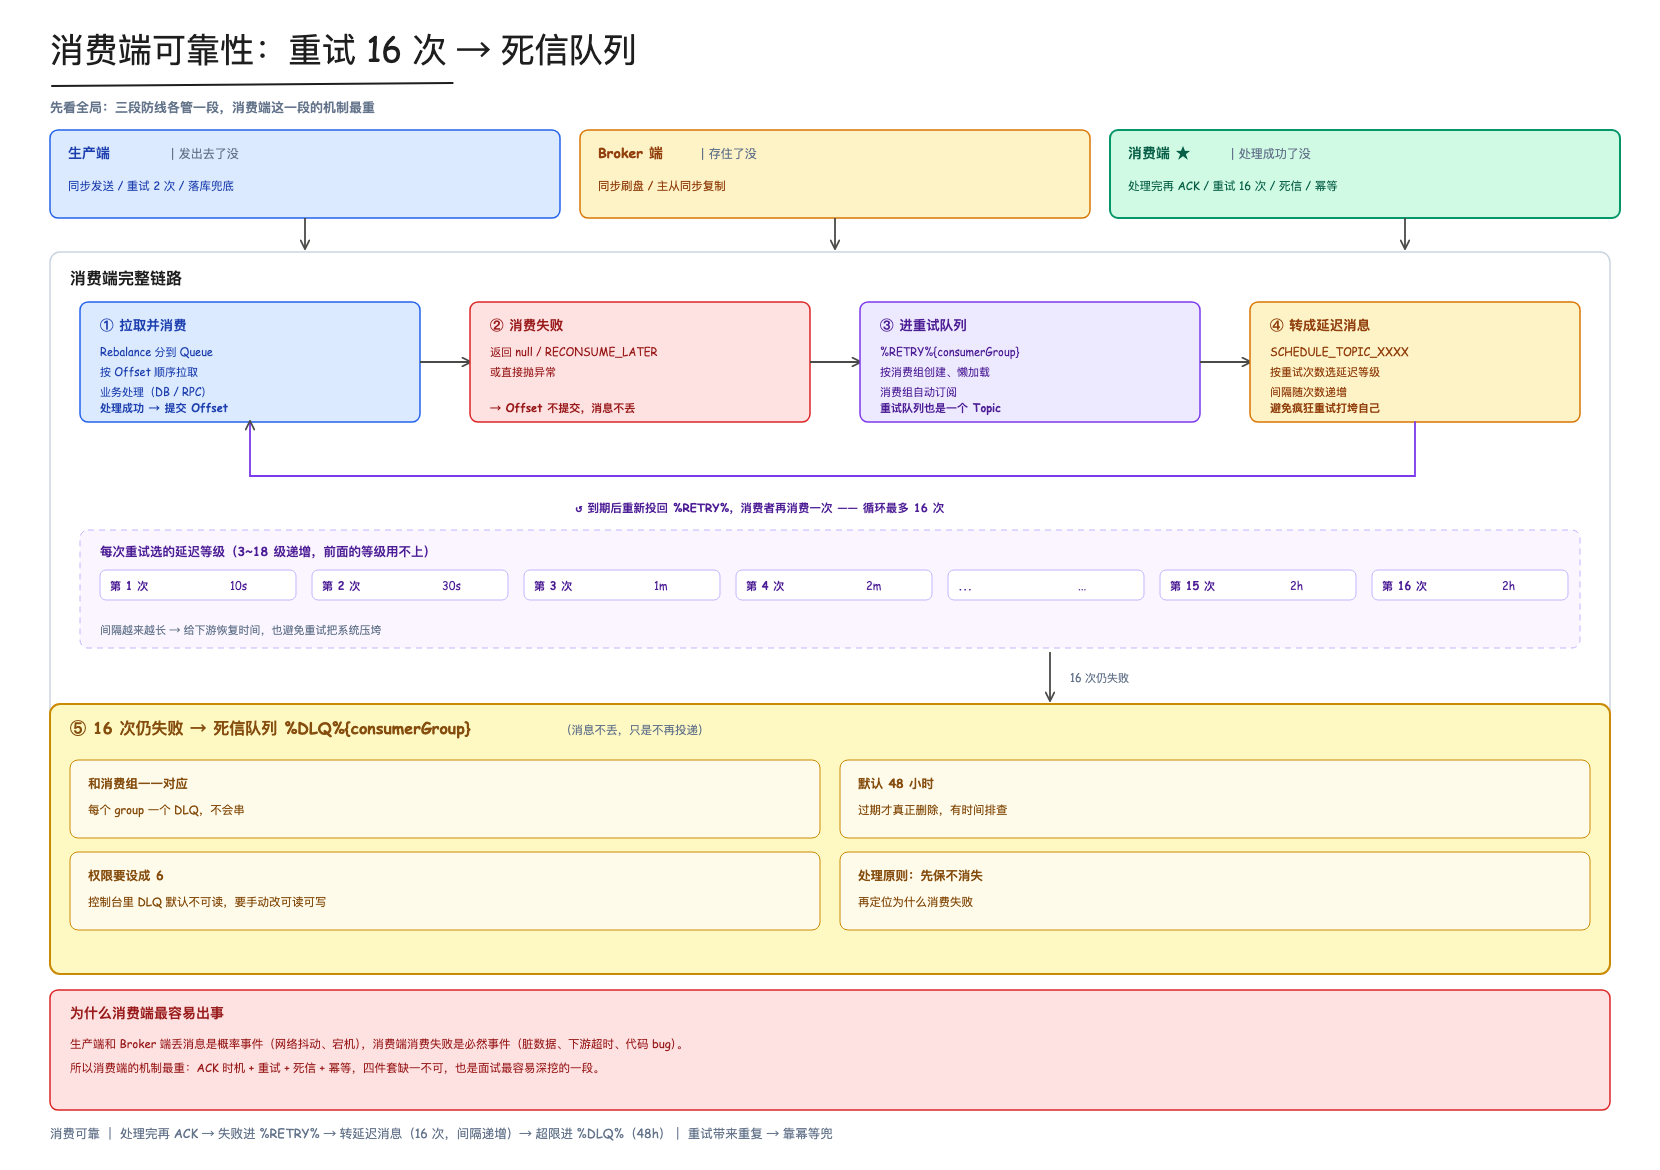
消息会在生产、存储、消费三个阶段丢,但是消费端的可靠最重要:生产无非重试、存储多用云服务(都成熟),只有消费端失败是必然发生的业务问题。
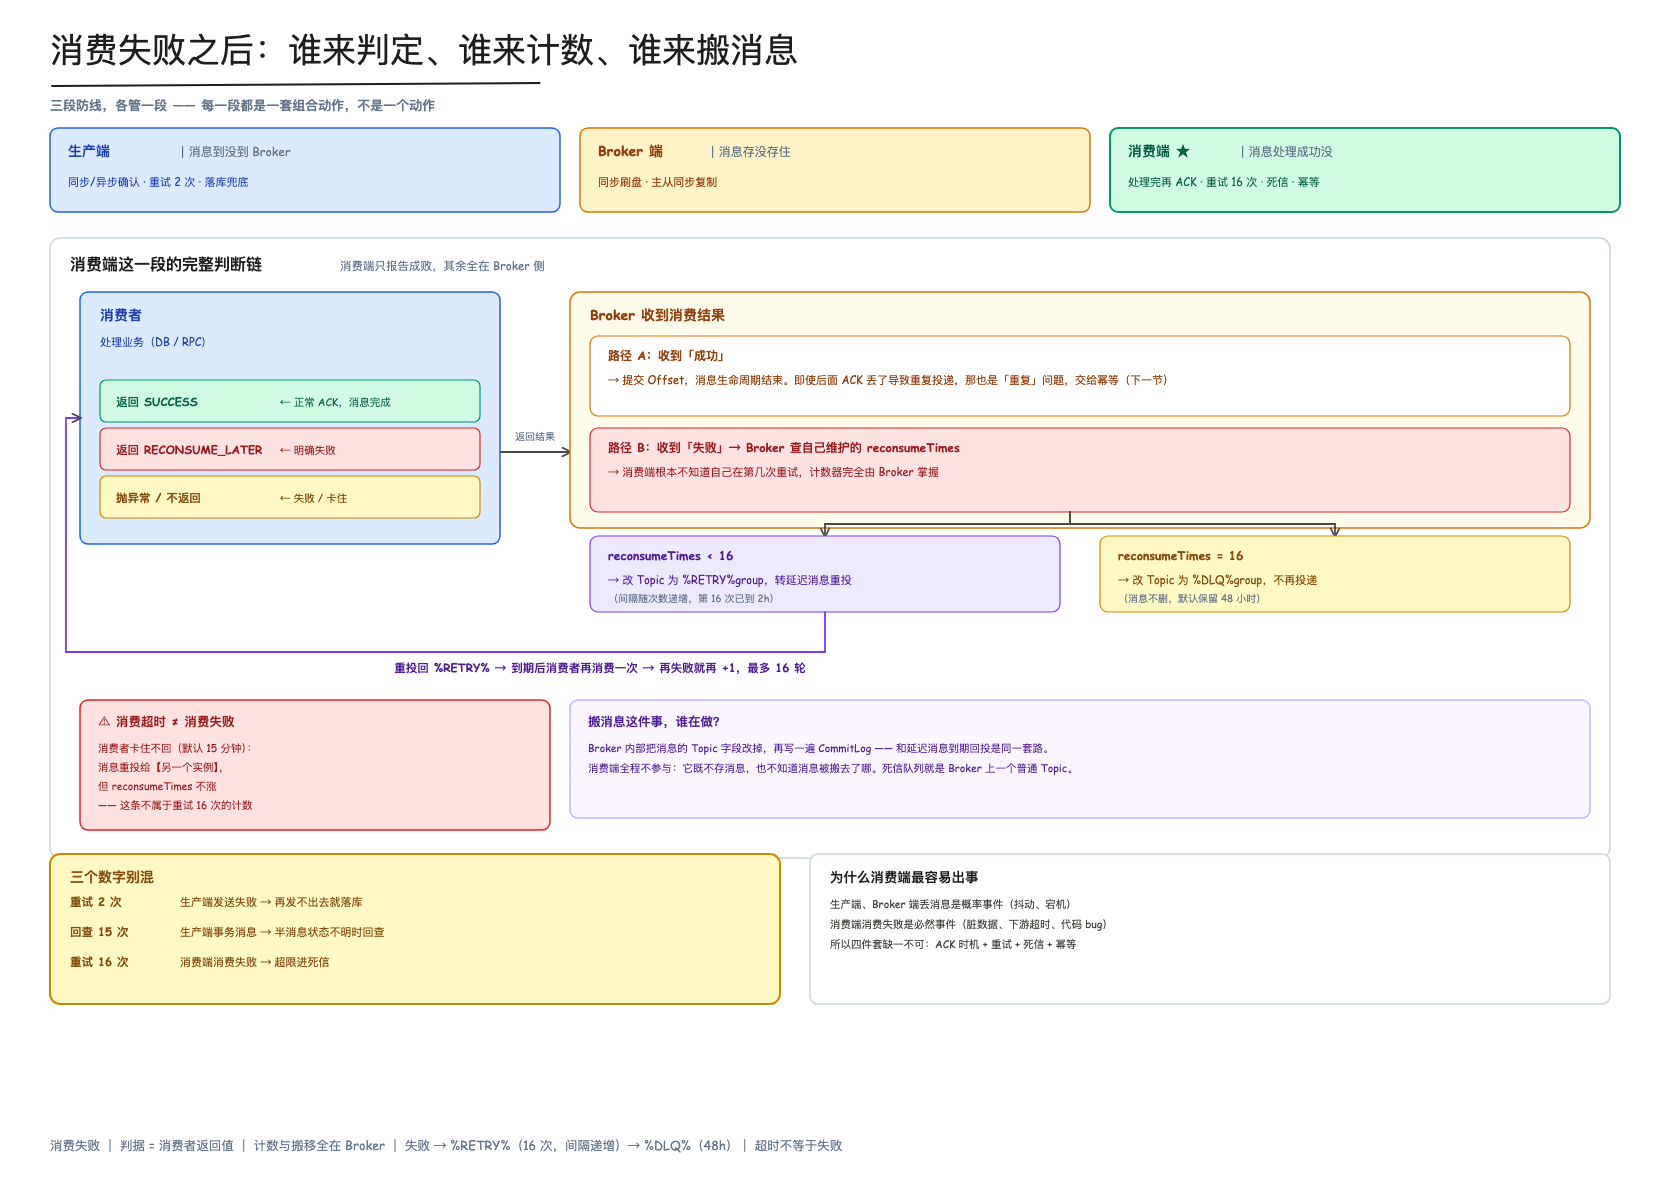
一句话记住:消费端只报告成败,判定、计数、搬消息全在 Broker 侧——Broker 自己维护 reconsumeTimes,自己改 Topic 把消息从 %RETRY% 搬到 %DLQ%,消费端不知道自己在第几次重试。
| 阶段 | 保证什么 | 具体做法 |
|---|---|---|
| 生产端 | 消息确实到了 Broker | ① 同步发送检查返回 SEND_OK;异步发送在回调里检查<br>② 失败默认重试 2 次——同步重试会换 Broker,异步重试只在本 Broker<br><br />原因:<br />同步发送时,生产者仍阻塞在调用栈上,可以查看“还有哪些 Broker”;<br />异步发送时,回调早已返回,生产者只保存了一个连接,没有全局路由可切换。<br />③ 重试超限 → 落库 / 进 Redis 兜底,由业务定时捞出来重发 |
| Broker 端 | 消息确实落了盘、且有备份 | ① 同步刷盘(SYNC_FLUSH):写完等磁盘确认才返回 ACK<br>② 主从同步复制:Master 写成功要等 Slave 也写成功<br>③ 代价:可靠性与性能二选一,两个都开 = 最可靠最慢;Master 挂了 Slave 仍有全量(实际性能太低 默认都不开) |
| 消费端 | 消息确实被处理成功 | ① 业务处理完再提交 Offset,不能收到就 ACK<br>② 失败返回 RECONSUME_LATER → Broker让该消息进重试队列,转成延迟消息,重试,默认 16 次<br>③ 仍失败 → 进死信队列(DLQ),人工查看、重发或者丢弃<br>④ 重试必然带来重复 → 业务幂等兜底(见下一节) |
三段的边界要划清(面试最容易被追问的地方):
- 生产端解决的是「发出去了没」,重试 2 次后仍失败就落库,靠业务补偿,MQ 不管了
- Broker 端解决的是「存住了没」,刷盘 + 主从,丢的概率趋零但慢
- 消费端解决的是「处理成功了没」,重试 + 死信 + 幂等三件套缺一不可
2. 消息幂等
为什么必然重复:MQ 是「at least once至少一次」语义,三个来源:
| 来源 | 场景 |
|---|---|
| 发送时重复 | 消息已持久化但应答丢了,生产者以为失败又发一次 |
| 投递时重复 | 消费完成但 ACK 丢了,Broker 网络恢复后重投 |
| Rebalance 重复 | Broker 或客户端重启、扩缩容触发 Rebalance,Queue 换了消费者但旧 Offset 未提交 |
Rebalance 为什么危险:不只是重复。它会全组暂停消费(STW),且一个实例超时被踢 → 它的 Queue 分给别人 → 别人超载 → 心跳发不出 → 又被踢 → 连环雪崩。根因是「全局暂停 + 负载传导」把单点故障放大成全组故障。
五种方案:
| 方案 | 做法 | 适用 |
|---|---|---|
| 业务幂等 | 设计成重复执行无影响(如删除 id=9) | 天然幂等最好 |
| 状态机判断 | update ... where status='交易中',只允许从特定状态流转 |
多步骤业务 |
| 唯一 ID 去重 | 消息 ID 落库或 Redis,处理前先查 | 通用 |
| 数据库唯一约束 | 业务单号加唯一索引,插入冲突即已处理 | 落库场景,最简单 |
| Redis SETNX | setnx msgId,返回 1 才处理,配 TTL 防膨胀 |
高并发 |
核心思想:处理两次,效果等于处理一次。
3. 消息积压
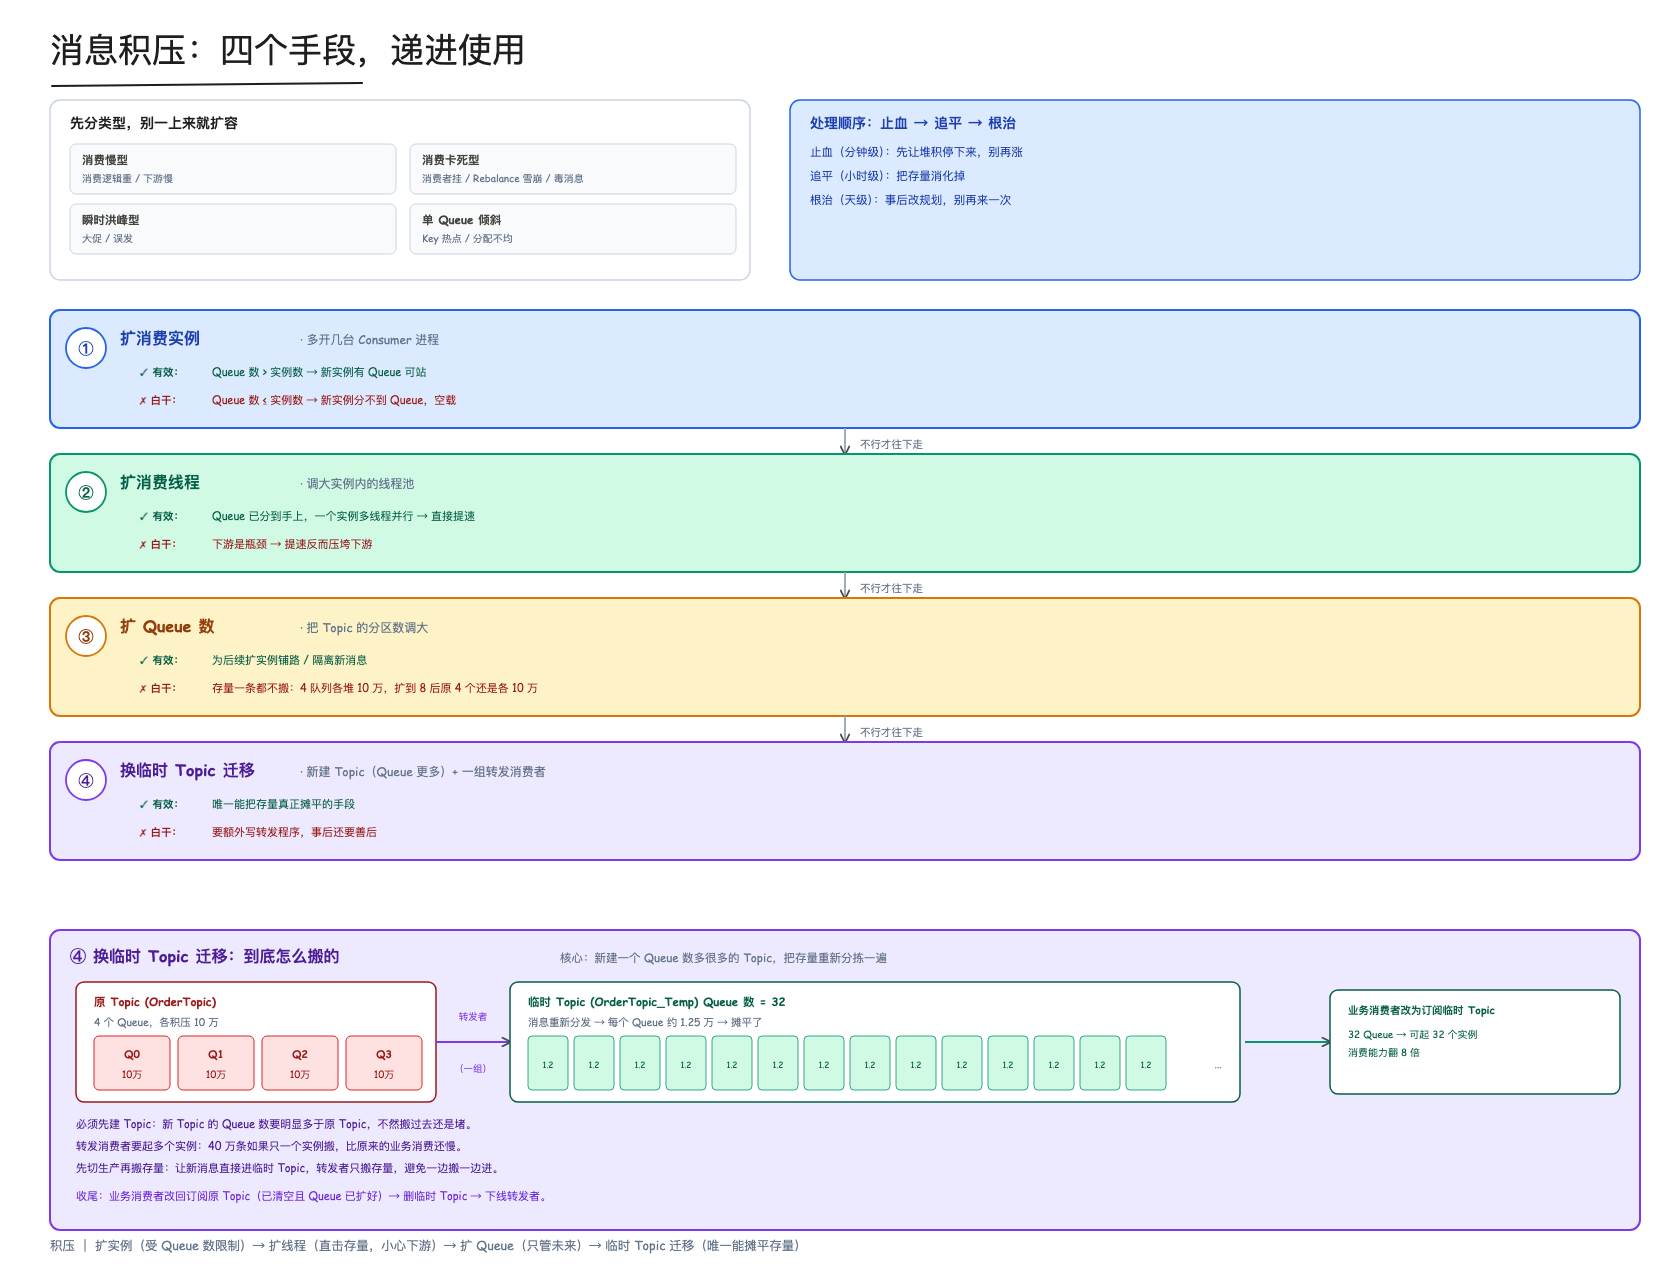
消费者的每个服务实例作为每个消费者组的消费者,通过负载均衡算法对应 broker 中一个 queue;而用不用线程池,扩不扩消费线程,提高并发数,是每个服务实例内部的事情。
服务实例会根据实例的 clientId,经过 rebalance 进行计算,而 clientId 格式是 {客户端IP}@{instanceName}@{进程号},如 192.168.1.10@order-consumer@7821,都是服务实例级别的信息,所以 queue 跟服务实例一一对应。
另外,如果队列数和服务实例数目发生变化的时候,就会触发 rebalance,即将队列给服务实例重新进行分配。重新分配的时候会 stop the world,也就是暂停所有消息的消费。那一旦有消费实例频繁重启或者抖动,就可能被认为频繁上线/下线,这时候就会产生 rebalance 风暴,整体陷入 Stop the world。所以生产中需要保持实例稳定,避免频繁重启和部署。
四个手段是递进的,不是并列的。为什么必须递进:RocketMQ 里一个 Queue 同一时刻只能被一个实例消费,这条约束把它们串成了一条链。
| 顺序 | 手段 | 有效条件 | 什么时候白干(下一步的理由) |
|---|---|---|---|
| ① | 扩消费实例 | Queue 数 大于 消费者数 | Queue 数 ≤ 消费者数 → 新实例分不到 Queue,空转 → 转 ② |
| ② | 扩消费线程 | Queue 已分到实例手上,多开线程并行处理 | 下游是瓶颈 → 提速压垮下游 → 转 ③ |
| ③ | 扩 Queue 数 | 为后续扩实例铺路、隔离新消息 | 存量一条都不搬——4 队列各堆 10 万,扩到 8 后原 4 个还是各 10 万 → 转 ④ |
| ④ | 换临时 Topic 迁移 | 唯一能把存量真正摊平 | 要额外写转发程序,成本高、事后要善后 |
最容易踩的坑:以为扩 Queue 能解决堆积。它只摊开未来,存量还在原来的 Queue 里堵着。
④ 临时 Topic 迁移:到底怎么搬
核心是「新建一个 Queue 数多很多的 Topic,把存量全部重新分拣一遍」。
原 Topic(OrderTopic)4 个 Queue,各积压 10 万(共 40 万)
   ↓ 写一个【转发消费者】,订阅原 Topic,只做一件事:把消息原样发到新 Topic
   ↓ 它不是业务消费者,唯一职责是搬运;而且要起【一组】实例,否则它自己成瓶颈
临时 Topic(OrderTopic_Temp)Queue 数 = 32
   ↓ 消息重新分发 → 每个 Queue 约 1.25 万 → 真正摊平
业务消费者改订阅临时 Topic
   ↓ 32 个 Queue → 可起 32 个实例 → 消费能力翻 8 倍
   ↓ 业务消费者**改回订阅原 Topic**(已清空且 Queue 已扩好)→ 删临时 Topic → 下线转发者